OpenAI 在 2026 年 9 月 10 日的 API changelog 宣布:GPT-Live 1 is now generally available in the API。官方句子是:Build full-duplex voice conversations that can continue while a backend model or agent handles reasoning and tools。创建会话时可选 Responses 委托(OpenAI 模型)或 client 委托(自建后端)。语音按时长计费:$0.05 per minute, billed per second;后端模型和工具另行计费。模型页给出的 ID 是 gpt-live-1,入口只有 v1/live/sessions。
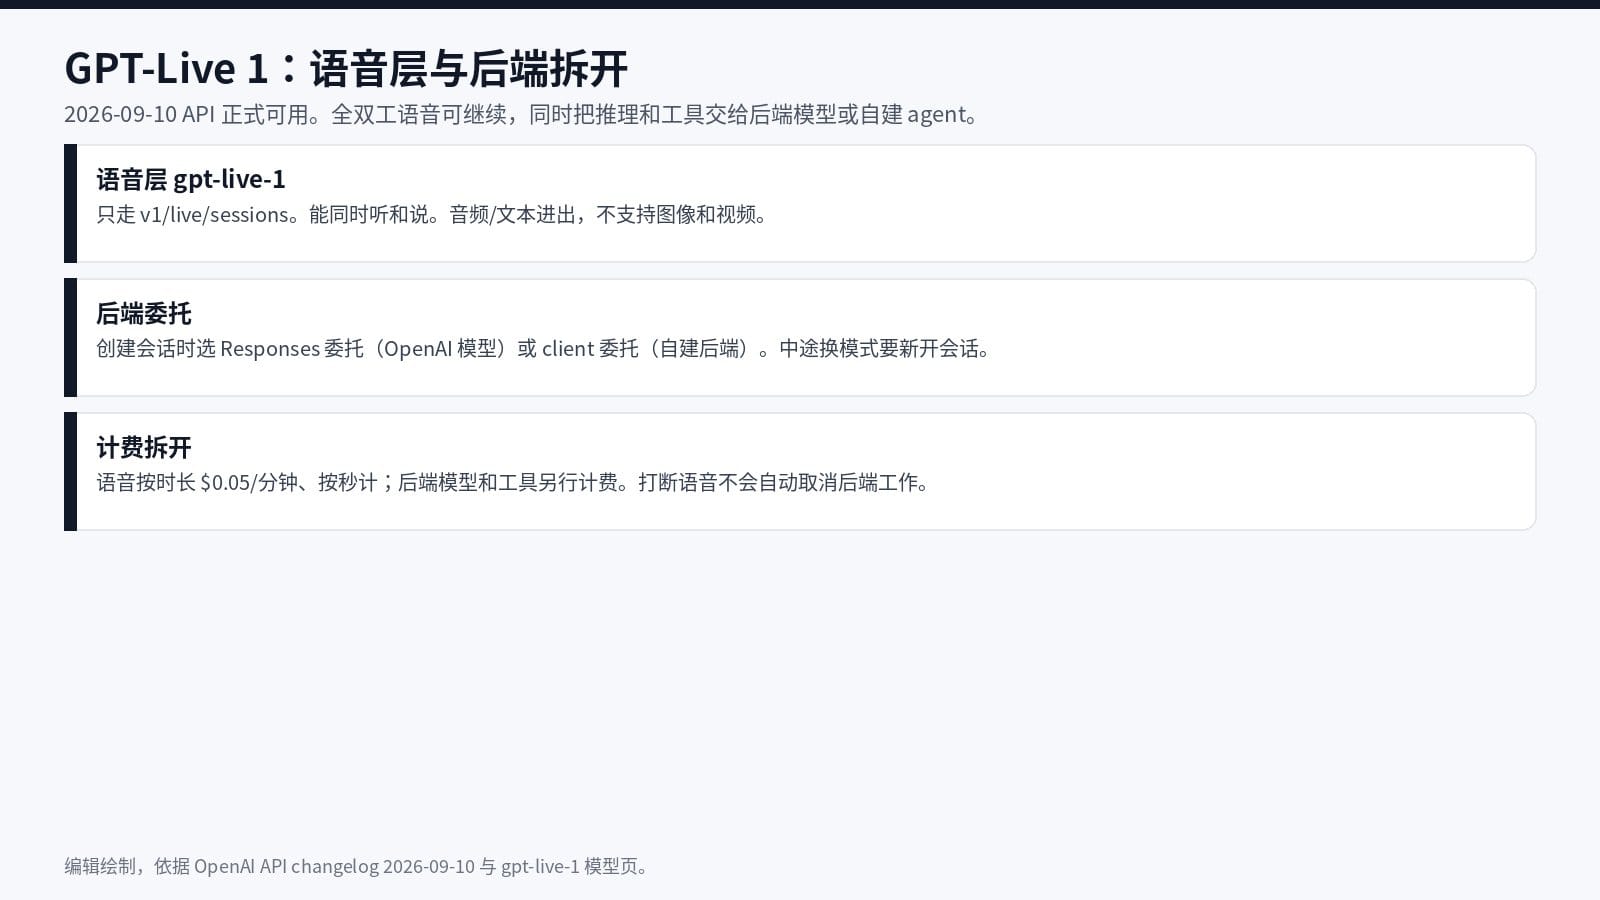
产品团队原先的摩擦是:要做能插话的语音助手,要么把推理塞进语音模型,要么自己拼一套“边说边调工具”的状态机。旧 Realtime 路线和 Chat Completions 都不是这条 Live 入口。本文要回答:GA 之后工作流哪一步被拆开、计费怎么分开、以及人必须在哪一步接管权限和未完成的后端任务。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
发生了什么
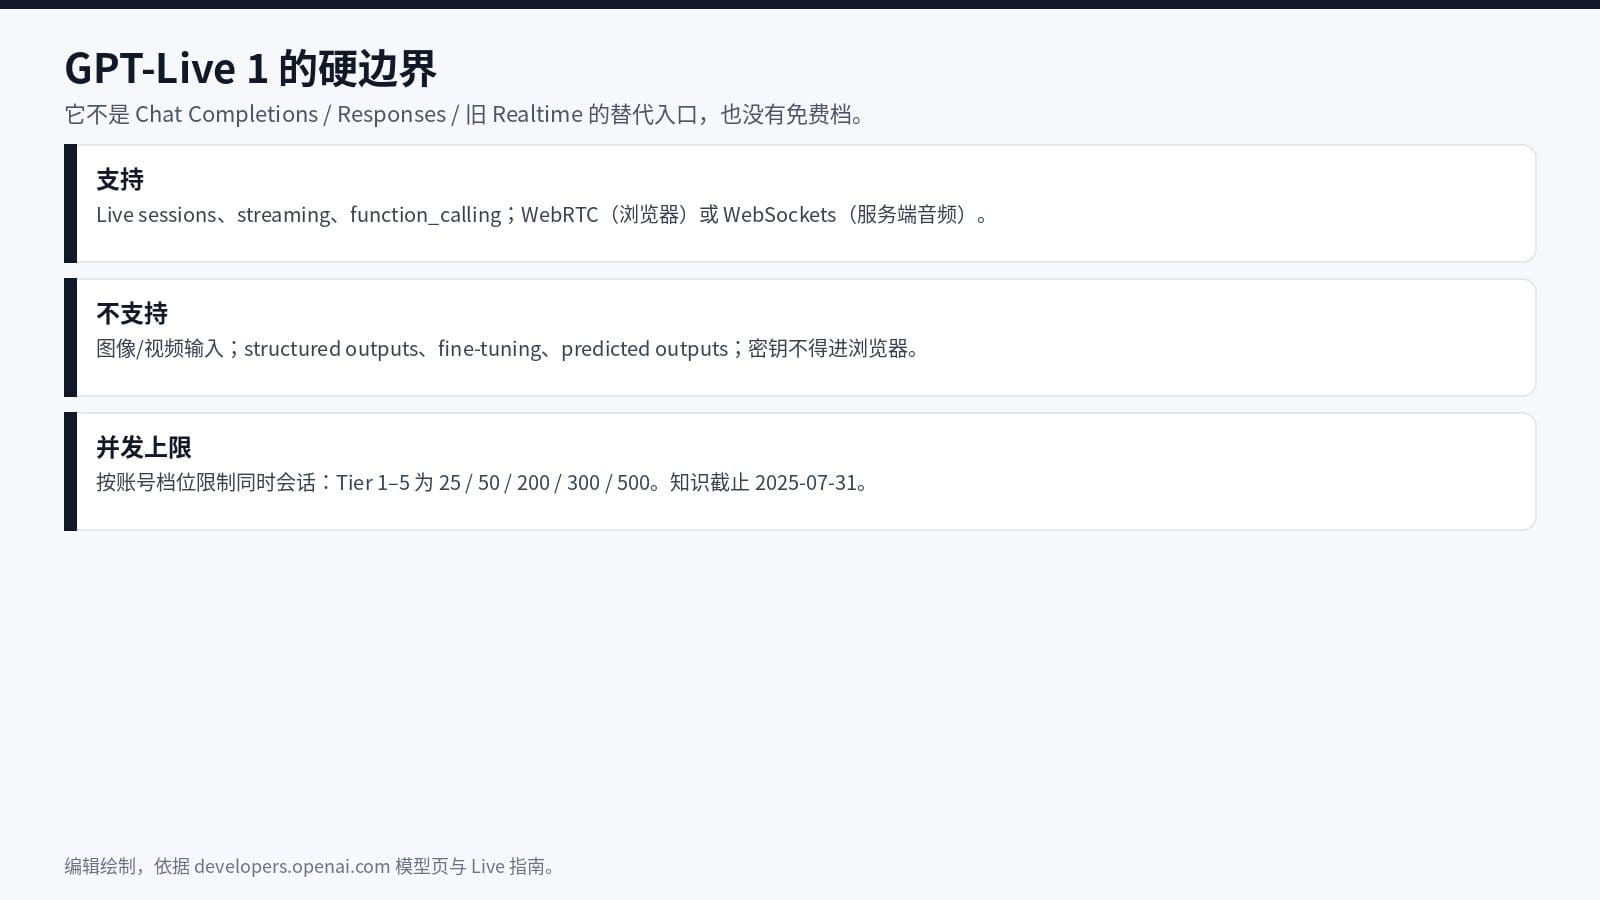
模型页把 GPT-Live 1 写成 premier model for natural, expressive voice conversations with smooth interruption handling,并明确它是 full-duplex:能同时听和说,再把推理和工具调用委托给后端 agent。输入输出是音频和文本;图像和视频被排除。知识截止写的是 2025 年 7 月 31 日。支持 streaming 与 function_calling;不支持 structured outputs、fine-tuning、predicted outputs。Chat Completions、Responses、旧 Realtime(含翻译/转写)、Assistants、Batch 等都被列为非此模型入口。
Live 指南补充连接方式:浏览器走 WebRTC(页面需 HTTPS 或 localhost,项目 API 密钥留在可信服务器,由服务器做 SDP 交换);服务端音频走 WebSockets;另有 sideband events 和 SIP/telephony。连上之后要等 session.started 再开始说话。委托模式在创建会话时选定,中途更换必须新开会话。指南原句:You choose the backend model or agent independently of the voice model。另一句是 Choose the mode when you create the session; to change modes, start a new session。
完整工作场景:说话不停,工具在后端跑
输入是用户的实时语音,例如“查一下这个订单为什么重复扣款,必要时打开工单工具”。操作从“一个模型既生成语音又调 API”变成两段:GPT-Live 负责听、说、判断何时交接;后端(Responses 上的受支持模型,或你自己的 agent)负责工具、规则和结果。交付仍是一句口语回复,但反馈循环拆开了:语音可以继续,工具调用在另一条链路上进行。
关键边界写在指南里:Interrupting speech does not automatically cancel backend work。用户插话只能打断正在播放的语音,不会默认停掉已经发出的退款、改权限或写库操作。因此应用仍要自己做权限、确认、私有函数和持久任务状态。关闭会话才会拿到最终用量并断开连接。密钥不得放进浏览器。
一个可核对的验收动作:让助手开始一项会调工具的任务,在它说话时插话改口;确认语音被打断,同时检查后端工具是否仍在执行。若工具被误取消或误继续,都要在应用层补确认框,而不是指望模型自己停。第二次验收看账单:同一会话应同时出现按时长的语音费用和按 token 的后端费用,两者不要加总成一个“通话单价”再对外报价。
为什么这会改变工作流
因果是职责分离。语音质量和工具正确性不再绑在同一个采样预算上:语音层按秒计费,推理和工具按各自模型与工具价。changelog 写明 Voice sessions cost $0.05 per minute, billed per second,时间不会凑整到整分钟。模型页重复同一价格,并写下游模型/工具另计。没有免费档。
并发按同时会话数限制,不是按 token:Tier 1 到 Tier 5 为 25 / 50 / 200 / 300 / 500。客服或现场支持如果按“每个座席一条常驻会话”估算,要先核对档位,而不是假设能无限开麦。full-duplex 让产品可以做边说边听,但这把“用户改口”从产品特性变成了取消语义问题:没做确认流的团队,会把插话理解成取消,系统却继续执行。
对开发者工作流的直接变化是:语音前端可以独立迭代提示词和打断策略,工具权限仍按原有 agent 网关走。现场演示时,不要把“能插话”演示成“能撤销刚才那次 API 调用”。
限制与人接管点
GPT-Live 1 不是通用文本 API,不能拿它当 Chat Completions 替代品。不接受图像和视频,不能用它做“看屏幕讲解代码”。structured outputs 不可用,工具参数校验仍要后端做。知识截止停留在 2025-07-31,不能把它当成当天事实来源。委托模式不能在同一会话中途切换。
人必须接管的步骤:敏感工具的二次确认、插话后是否取消后端任务、会话关闭与用量对账、以及浏览器里绝不出现 API 密钥。同一天 changelog 里的 Agents API 公开测试是独立事件,已经另文处理,不要和 GPT-Live 拼成“一个 Agent 平台发布”。VS Code 1.137 的 Voice Mode 是编辑器里对 Copilot 说话,入口和计费都不是 v1/live/sessions。项目 API 密钥过期策略也是 9 月 10 日的另一条目,只影响密钥寿命,不改变 Live 会话语义。
指南还要求关闭会话以取得最终用量。开发者如果只在前端挂断麦、不结束 Live session,账单和对账脚本会对不齐。把“用户离开页面”映射成服务器侧关会话,应写进接入清单,而不是事后从发票反推。
麦克风权限和 HTTPS 约束也属于人接管点:没有麦或未走 HTTPS/localhost 的页面,指南不保证能建会话。现场演示应先检查这两项,再谈模型和声音。
如何试用
读模型页和 Live 指南,用服务器创建 v1/live/sessions,模型填 gpt-live-1。先走 WebRTC 本地页或 WebSockets 服务端音频,等到 session.started。第一次只接一个只读工具,验证插话、委托和按秒账单;不要把退款、删数据或改权限接到未做确认的委托链上。看账单时把语音时长和后端 token 分开核对。需要换委托模式时,结束当前会话再开新会话,不要指望热切换。
信息来源
- OpenAI API changelog(2026-09-10 GPT-Live 1 GA)
- OpenAI 模型页:gpt-live-1
- OpenAI 指南:Getting started with live sessions
开发必备:API 全流程管理神器 Apifox
介绍完上文的内容,我想额外介绍一个对开发者同样重要的效率工具 —— Apifox。作为一个集 API 文档、调试、设计、测试、Mock、自动化测试于一体的工具,Apifox 是目前提升研发效率的首选。
如果你正在开发项目,不妨试试其极其友好的界面设计,它完全兼容 Postman 和 Swagger 数据格式,导入数据非常方便,,即使是新手也能很快上手,点击这里即可注册使用。
值得一提的是,除了个人和常规团队使用,针对有高安全合规要求、或需要在内网环境协作的企业,Apifox 还提供了深度定制的私有化部署方案。
获取专属报价与部署方案
 详细的私有化部署系统架构与安全白皮书
 针对您公司规模的专属报价单
 免费的 1v1 专属产品演示 (Demo) 机会