GPT-6 Astra 没有进行训练,却把 Qwen3.5-0.8B 在 MATH-500 上的得分从 7.9% 提高到 48.1%。它读取模型权重,找到一个使模型在思考过程中循环的方向,然后从两个 MLP 层中减去这个方向。这次修改涉及 131,072 个权重,占模型的 0.016%。这些数字来自四位 MIT CSAIL 研究者于 11 月 2 日发表的文章;修改后的模型也已公开,可供核对。
下文介绍什么是权重空间编程、Astra 修改了什么、这种方法的局限,以及如何让编码智能体比较两个模型。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
什么是权重空间编程?
权重空间编程是指通用 LLM 根据自然语言目标,直接读取和修改神经网络的权重,不使用梯度下降或训练循环。模型推断网络各部分计算的内容,再像程序员编辑源码一样直接修改数值。
这个术语出自 Rikiya Takehi、Jayden Teoh、Alex Zhang 和 Omar Khattab 于 2026 年 11 月 2 日发表的 Sparks of Weight-Space Programming。作者认为所有结果都“处于非常早期”,其中一些只来自一次或少数几次运行。
GPT-6 Astra 如何修复 Qwen3.5-0.8B
最受关注的是实验 8。研究者要求 GPT-6 Astra 通过修改权重提升 Qwen3.5-0.8B 的数学能力。过程如下:
- 实验设置。 Astra 获得一个已加载模型权重的 Python 会话(类似 notebook),没有 GPU,另有训练集中的 7,469 道 GSM8K 和 7,275 道 MATH 练习题。它没有接触测试集。
- 预算。 Astra 不能训练模型,只能进行 10、25 或 50 次前向传播。每次前向传播最多可让模型回答 512 道题,或读取 1,024 段文本。
- 诊断。 Astra 发现基础模型会陷入循环:最初 96 道练习题中有 85 道一直运行到 32,768 token 上限,仍未给出答案。作者指出,Qwen 自己的模型卡也提醒该模型容易陷入思考循环。
- 追踪。 Astra 将循环追溯到第 15 层和第 19 层的 MLP 写入的一个方向。
- 修改。 它从这两层各自的
down_proj的 64 个输出列中减去该方向,共修改约 8 亿权重中的 131,072 个。
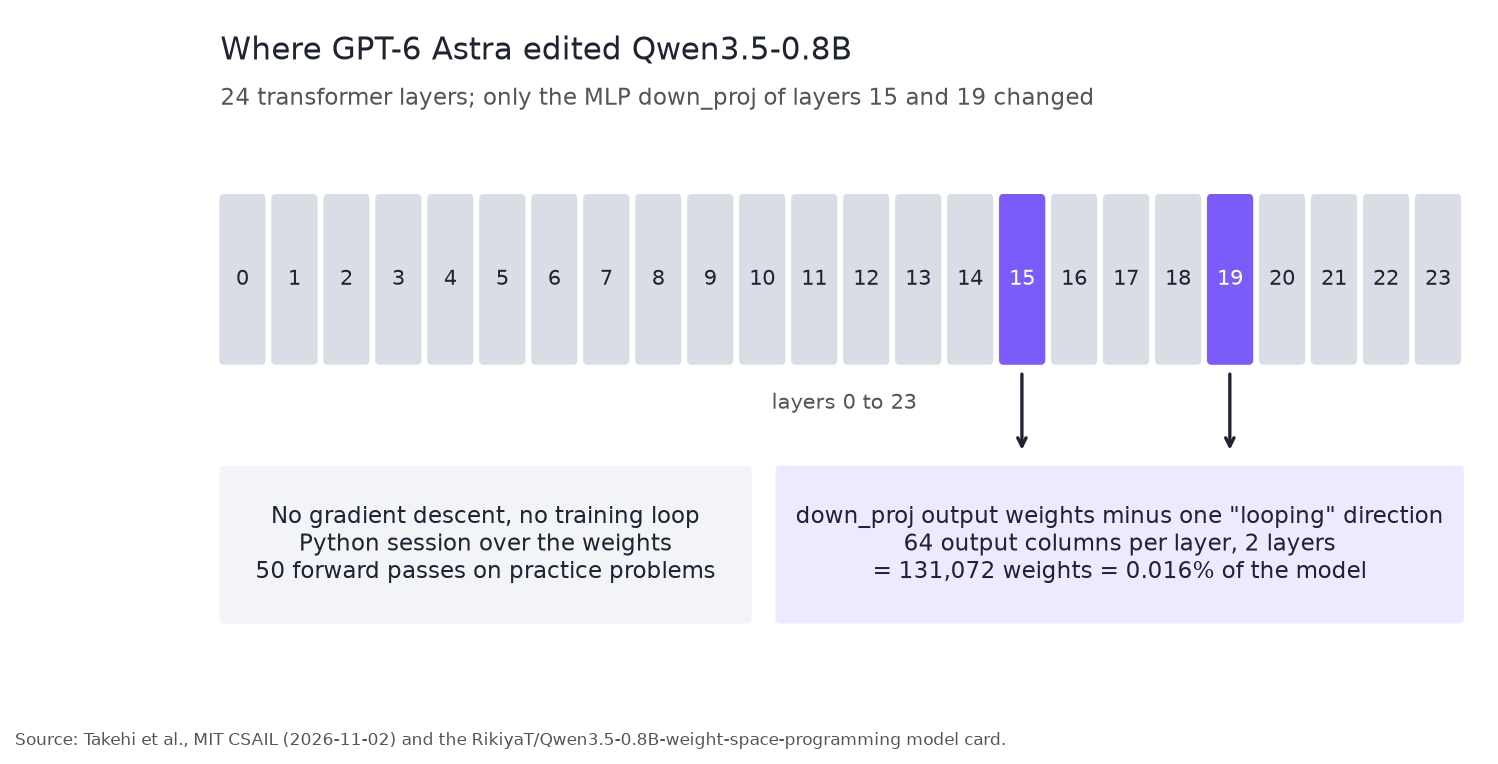
根据 Hugging Face 模型卡,与基础版 Qwen/Qwen3.5-0.8B 检查点相比,只有这两个 down_proj 张量不同;每个重建后的张量都通过 SHA-256 校验,与作者评估时使用的版本一致。修改后的模型采用 Apache 2.0 许可证。
结果:基础版与修改版 Qwen3.5-0.8B
以下数字均来自作者文章,实验启用了思考,最多生成 32,768 个 token,每题采样多次。“触及 token 上限”指 MATH-500 答案耗尽生成额度的比例。
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | 触及 token 上限 |
|---|---|---|---|---|
| 基础版 | 7.9% | 13.8% | 21.0% | 93.0% |
| 修改版,10 次前向传播 | 12.3% | 25.7% | 49.0% | 87.2% |
| 修改版,25 次前向传播 | 14.1% | 25.1% | 39.9% | 86.4% |
| 修改版,50 次前向传播 | 48.1% | 67.1% | 62.3% | 33.1% |
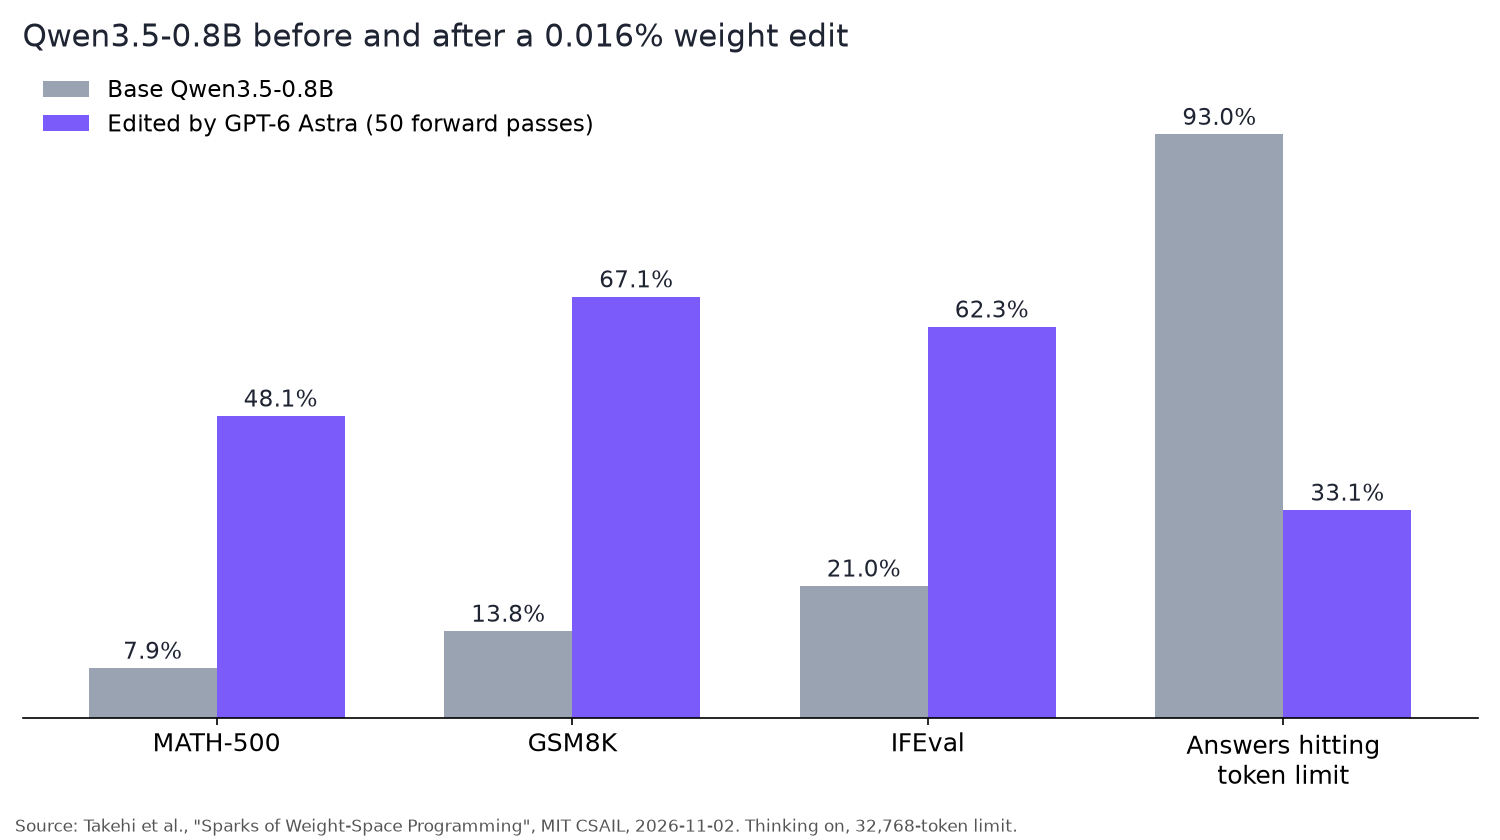
- 效果延伸到了其他任务。 循环问题不限于数学,因此 IFEval 得分也约增至原来的三倍。
- 预算影响很大。 只进行 10 或 25 次前向传播时,循环问题几乎没有缓解。
- 有独立复现。 Hugging Face 的 Ahsen Khaliq 根据日志重建检查点,重新运行完整的 MATH-500(500 道题,每题采样 4 次)。修改版得分 51.0%,其中 31.6% 的答案触及上限。基础版在 25 道题的快速检查中得分 5.0%。
你也可以在演示 Space 输入题目,观察两个模型的回答。
修改权重做不到什么
作者还进行了一个比主要结果更能说明边界的对照实验:将同样的方法用于很少陷入循环的 Gemma 3 270M。该模型只有 8.5% 的答案触及上限,而 Qwen 为 93%。
| Gemma 3 270M | MATH-500 |
|---|---|
| 基础版 | 6.8% |
| 最佳修改版(25 次前向传播) | 7.7% |
Gemma 的错误通常是算术算错等普通错误,并不存在一个可以直接关闭的单一组件。作者认为,权重修改移除的是掩盖既有能力的障碍,无法凭空赋予模型原本没有的能力。Qwen 本来就能算出许多答案,只是无法结束推理。
因此,这项结果不能说明训练已经不再需要。它展示的是前沿模型找到并移除一个集中在局部的故障。
权重空间编程研究中的其他实验
实验 8 是八个实验之一,其余实验使用规模小得多的网络:
- 读取权重。 只看原始权重,Astra 准确识别了 4 个 PPO 游戏策略对应的全部 4 款游戏,以及 3 个小型字符级语言模型的全部 3 种训练语言。
- 修复策略。 一个 Kinetix 小车策略原本在 256 次尝试中全部失败;Astra 用一次回复修改其 3.5% 的权重后,在 1,024 次尝试中全部成功。
- 从零写入权重。 Astra 写出的 MinAtar Breakout 权重得分 517.4,而训练 5 亿步的 PPO 得分 25.3;但在 Seaquest 上,Astra 以 53.1 分落后于 PPO 的 88.9 分。
- 围棋。 它从零写出一个拥有 148 万权重的 9×9 围棋网络,在 50 次前向传播预算下击败了同等规模的 PPO 网络。
- 一次失败。 仅凭权重,它无法判断两个 Gemma 3 270M 副本中哪一个经过迎合性训练;获得注意力模式后,它在三组配对中全部选对。
完整实验日志 包含每条提示词、Astra 的推理摘要和它运行的全部代码。
自行检查 Qwen3.5-0.8B 的思考循环修复效果
比较直接的做法是将两个检查点部署为兼容 OpenAI 的 API,向它们发送相同提示词。vLLM 可分别用一条命令启动:
vllm serve Qwen/Qwen3.5-0.8B --port 8001 \
  --served-model-name qwen --max-model-len 34816 --gpu-memory-utilization 0.45

vllm serve RikiyaT/Qwen3.5-0.8B-weight-space-programming --port 8002 \
  --served-model-name qwen --max-model-len 34816 --gpu-memory-utilization 0.45
两个服务都使用 qwen 作为模型名,因此同一个请求体可发往不同端口。--max-model-len 34816 与模型卡示例一致。
每个请求都参考作者的采样设置,并开启思考:
{
  "model": "qwen",
  "messages": [{"role": "user", "content": "{{question}}\nPlease reason step by step, and put your final answer within \\boxed{}."}],
  "temperature": 0.6,
  "top_p": 0.95,
  "top_k": 20,
  "presence_penalty": 1.5,
  "max_tokens": 32768,
  "chat_template_kwargs": {"enable_thinking": true}
}
最后一个 \boxed{} 值是答案,finish_reason 表示模型正常停止(stop)还是用尽 token(length)。length 代表生成未能在限制内结束。
如果不想运行 GPU,也可以尝试相关的托管 API,或在本地比较较小的 Qwen 模型。
让编码智能体比较两个模型
手工评判二十条长篇生成结果很费时。以下以 Apifox CLI 演示环境、测试场景、数据驱动运行和报告,并在本机访问 localhost 端点。相关命令在 Apifox CLI 2.2.12 的帮助信息中可见,但这套端到端操作尚未实测,执行结果待核实。
安装和配置命令如下,其中 npx -y skills add https://apifox.com 尚未实测,标为[待核实]:
npm install -g apifox-cli@latest
apifox login --with-token <YOUR_TOKEN>
npx -y skills add https://apifox.com   # pick your agent when prompted
接着可向 Claude Code、Codex、Cursor 或 OpenCode 提供以下提示词:
In Apifox project <id>, create two environments: qwen-base at http://localhost:8001
and qwen-edited at http://localhost:8002. Create a test scenario that POSTs to
/v1/chat/completions with the body in request.json, using {{question}} from the
first 10 GSM8K test questions in gsm8k-10.csv. Assert that the last \boxed{} value
equals {{answer}} and that choices[0].finish_reason is not "length". Run it against
both environments and give me a table: correct answers and length finishes per model.
示例中,智能体读取载荷 schema、验证 JSON,再执行以下命令;这套端到端流程尚未实测,结果待核实:
apifox environment create qwen-base --project <id> --base-url http://localhost:8001
apifox environment create qwen-edited --project <id> --base-url http://localhost:8002
apifox cli-schema get test-scenario-create
apifox cli-schema validate test-scenario-create --file scenario.json
apifox test-scenario create --project <id> --file scenario.json
apifox run -t <scenarioId> --project <id> -e <baseEnvId> \
  -d gsm8k-10.csv --timeout-request 1800000 -r cli,json --out-file qwen-base
apifox run -t <scenarioId> --project <id> -e <editedEnvId> \
  -d gsm8k-10.csv --timeout-request 1800000 -r cli,json --out-file qwen-edited
-d 让每行 CSV 数据成为一次迭代。--timeout-request 的单位是毫秒;发生循环时,生成到 32,768 token 上限可能耗时数分钟。-r cli,json 会打印摘要,并生成可供智能体比较的 JSON 报告。10 道题取自 GSM8K 测试集。
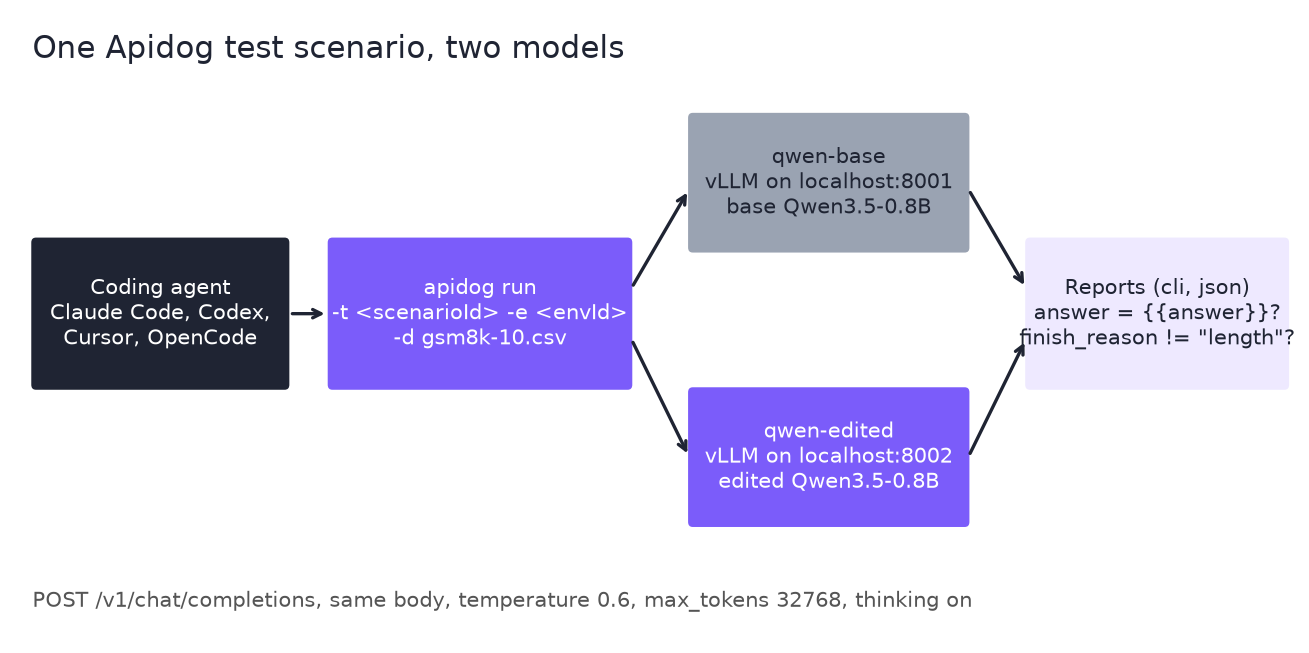
如果结果接近作者的实验,基础版多数答案会因 finish_reason 断言失败,修改版则多数通过。10 道题只是快速检查,不能充当基准测试;应把差距视作线索,而非正式得分。--upload-report 可在应用中查看运行结果,但该能力及命令参数需待核实。
同一场景也可用于模型更换后的回归测试;-r junit 的相关配置需待核实。
对部署小模型有什么启示
- 衡量截断情况,而不只看准确率。 Qwen 的 7.9% 得分掩盖了多数回答无法结束的问题。检查
finish_reason可以发现它。 - 寻找单一原因造成的故障。 循环和重复可能集中在网络的一小部分。
- 记住对照实验。 如果模型是算错了,而不是卡住,类似修改未必有用。
常见问题
GPT-6 Astra 训练了 Qwen3.5-0.8B 吗? 没有。作者不允许梯度下降或训练循环。Astra 在 Python 会话中修改权重,只通过 10、25 或 50 次前向传播观察模型。
修改了多少权重? 131,072 个,作者称约占模型的 0.016%。改动位于第 15 和 19 层 MLP 的 down_proj 矩阵,每层涉及 64 个输出列。
修改后的模型可获取吗? 可以。Hugging Face 上的 RikiyaT/Qwen3.5-0.8B-weight-space-programming 采用 Apache 2.0 许可证,提供两个变更张量的哈希值,另有独立复测结果(MATH-500 得分 51.0%)。
为什么数学得分大幅提高? 因为基础模型陷入循环。在 MATH-500 中,93.0% 的回答触及 32,768 token 上限;修改后降至 33.1%,使模型能够完成原本就能算出的答案,并没有学会新的数学知识。
权重空间编程适用于所有模型吗? 目前不能如此断言。对很少陷入循环的 Gemma 3 270M,最佳修改仅将 MATH-500 得分从 6.8% 提高到 7.7%。作者认为所有结果都还处于非常早期。
无需写代码也能测试修改版模型吗? 可以。在 Hugging Face 的演示 Space 输入一道题,就能运行并比较两个模型。若要重复测试,可参照上文使用 vLLM;Apifox CLI 的具体流程需待核实。