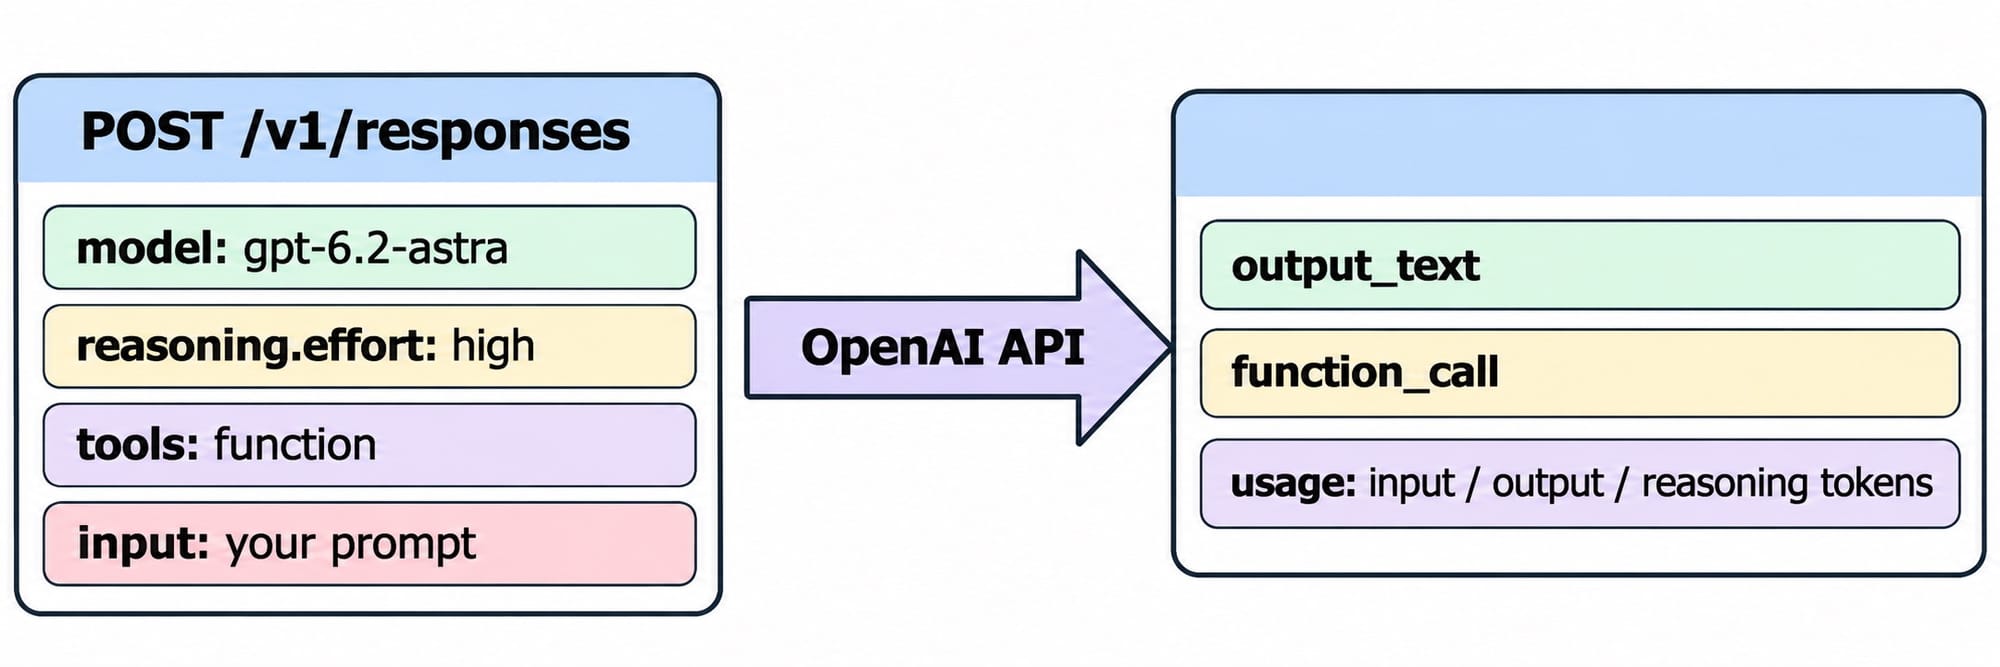
简要回答: 要调用 GPT-6.2 Astra API,把请求发到 OpenAI 的 Responses 端点(POST /v1/responses),在请求体里写 "model": "gpt-6.2-astra"、一个推理强度(例如 "high")和你的输入。价格是每百万输入 token 8 美元、每百万输出 token 40 美元,最多接受 922K 输入 token,返回最多 128K。不要把强度设成 none,API 会直接拒绝。
OpenAI 于 2026 年 11 月 17 日发布 GPT-6.2 Astra 以及更便宜的兄弟型号 GPT-6.2 Sol。如果你以前调用过 GPT-6 Astra,大部分代码可以沿用。本文从第一次请求讲到工具调用、强度调优、计价陷阱,以及一套可以让编码代理替你重复执行的测试。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
首次调用 GPT-6.2 Astra API 前的准备
你需要四样东西,其中三样大概已经具备:
- OpenAI API key,在平台后台创建,导出为
OPENAI_API_KEY。 - 付费用量档位。 OpenAI 的模型页列出 Astra 的速率限制从 Build 档开始(每分钟 5,000 次请求、1M token)。
- 模型 ID
gpt-6.2-astra。更便宜的模型是gpt-6.2-sol。 - 受支持的端点:Responses、Chat Completions 或 Batch。Realtime、Assistants 和 fine-tuning 都不支持这两个模型。
以下规格取自 OpenAI 的 GPT-6.2 Astra 模型页,核对时间为 2026 年 11 月 18 日。
| 规格 | GPT-6.2 Astra |
|---|---|
| 模型 ID | gpt-6.2-astra |
| 上下文窗口 | 1,050,000 token |
| 最大输入 | 922,000 token |
| 最大输出 | 128,000 token |
| 知识截止日期 | 2026 年 5 月 18 日 |
| 端点 | Responses、Chat Completions、Batch |
| 特性 | 流式输出、函数调用、结构化输出、图像输入、prompt caching |
如何发出第一次 GPT-6.2 Astra API 请求
Responses API 是 OpenAI 为新特性优先建设的端点,从这里入手即可。步骤如下:
- 导出密钥:
export OPENAI_API_KEY=sk-... - 带上模型 ID 和推理强度发一个请求。
- 从
output_text读答案,从usage读 token 用量。
用 curl:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.2-astra",
    "reasoning": { "effort": "high" },
    "input": "Review this migration plan and list the three biggest risks."
  }'
用官方 Python SDK(pip install --upgrade openai):
from openai import OpenAI

client = OpenAI()  # reads OPENAI_API_KEY

response = client.responses.create(
    model="gpt-6.2-astra",
    reasoning={"effort": "high"},
    input="Review this migration plan and list the three biggest risks.",
)

print(response.output_text)
print(response.usage)
用 Node.js(npm install openai):
import OpenAI from "openai";

const client = new OpenAI();

const response = await client.responses.create({
  model: "gpt-6.2-astra",
  reasoning: { effort: "high" },
  input: "Review this migration plan and list the three biggest risks.",
});

console.log(response.output_text);
早期每次调用都要看 usage 块。Astra 在写出第一个字之前就消耗推理 token,而这些按输出计费,简短的回答也可能比你预期的更贵。
为 GPT-6.2 Astra 选择推理强度
推理强度是同时影响质量和成本的最大杠杆。OpenAI 的推理指南列出 none、minimal、low、medium、high、xhigh 和 max,并说明每个模型只支持其中一部分。对 GPT-6.2 Astra 和 Sol,唯一确认的规则是 none 会被拒绝,因此每次调用都会推理。
| 强度 | 适用场景 |
|---|---|
low / medium |
简单修改、信息抽取、简短回答 |
high |
代码审查、规划、多数高难度提示词;开始测试时的合理默认值 |
xhigh |
长时间 agent 运行和异步任务,只在评测显示明显收益时使用 |
max |
最难的问题,更好的答案值得多花几倍 token |
OpenAI 没有说明 Astra 的默认强度,所以每次请求都显式设置,账单和测试结果才可复现。
强度对账单的影响有多大?Simon Willison 在发布日用同一条出图提示词跑了三档强度,并公布了成本:Astra 在 high 下 11.55 美分,xhigh 下 17.70 美分,max 下 88.71 美分。从 high 到 max,成本翻了将近八倍。
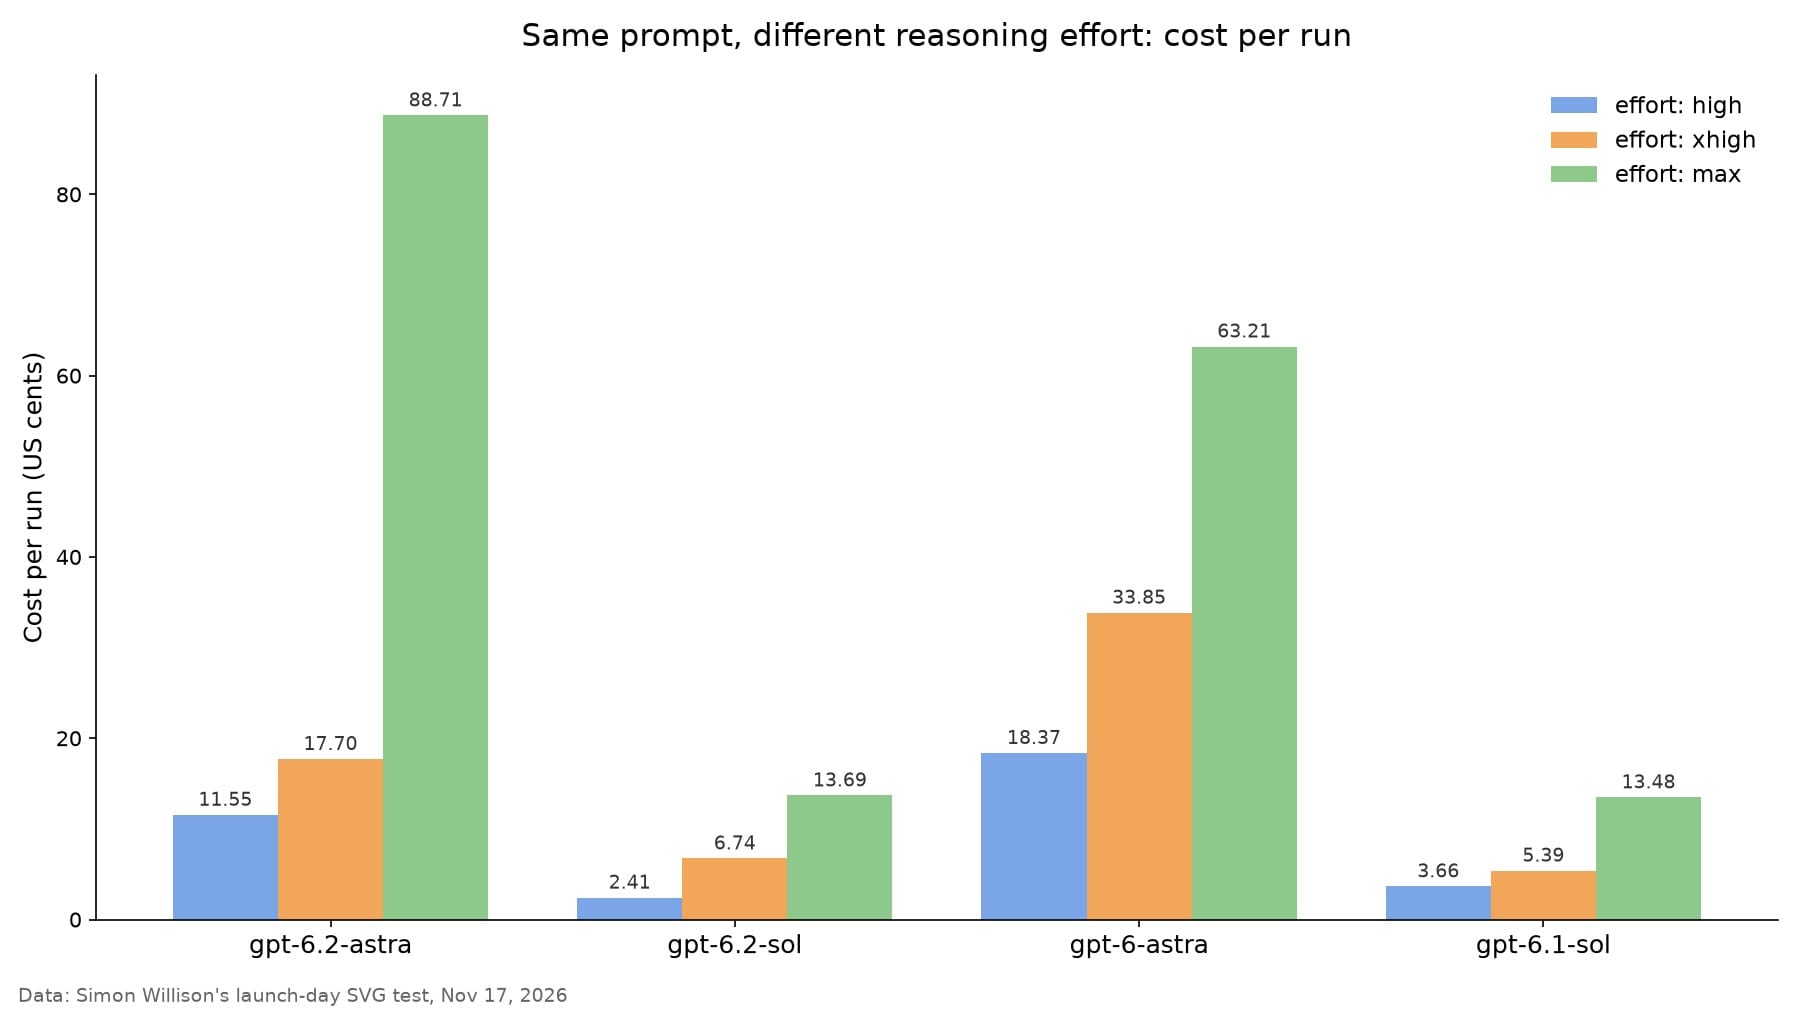
注意 GPT-6.2 Astra 在 high 和 xhigh 下比 GPT-6 Astra 便宜,max 下却更贵。每 token 价格降了 20%,但 max 强度思考得更久。衡量口径应该是「完成一个任务的成本」,而不是每百万 token 的价格。
在 GPT-6.2 Astra API 中使用工具与结构化输出
Astra 支持函数调用、结构化输出,以及 Responses API 中一长串托管工具:web search、file search、image generation、code interpreter、hosted shell、apply patch、skills、computer use、MCP 和 tool search。
函数工具的定义方式与 GPT-6 Astra 相同:
response = client.responses.create(
    model="gpt-6.2-astra",
    reasoning={"effort": "high"},
    tools=[{
        "type": "function",
        "name": "get_order_status",
        "description": "Look up an order by its ID.",
        "parameters": {
            "type": "object",
            "properties": {"order_id": {"type": "string"}},
            "required": ["order_id"],
        },
    }],
    input="Where is order A-1042?",
)

for item in response.output:
    if item.type == "function_call":
        print(item.name, item.arguments)
你自己执行函数,再把结果作为 function_call_output 条目、带上对应的 call_id 回传。Astra 据此写出最终答案。
需要机器可读的输出时,在 text.format 里传 JSON schema,并设置 "type": "json_schema" 和 "strict": true。模型返回的 JSON 会符合你的 schema,可以直接解析,无需猜测。
面对这样强的模型,有两个习惯值得培养。第一,给每个工具写紧凑的描述和严格的 schema;发布日的评审者反馈,Astra 在长时间、开放式的任务里容易跑偏。第二,在 agent 循环里设置 max_output_tokens,避免某一步失控吃光预算。关于端点本身的背景,参见 OpenAI Responses API 指南。
GPT-6.2 Astra API 价格与速率限制
Astra 按百万 token 计费,超长提示词会有加价。以下费率来自模型页:
| 项目 | GPT-6.2 Astra | GPT-6 Astra(参考) |
|---|---|---|
| 输入 | $8.00 | $10.00 |
| 缓存输入 | $0.40 | $1.00 |
| 缓存写入(保留 30 分钟) | $10.00 | 不适用 |
| 输出 | $40.00 | $50.00 |
陷阱在长上下文规则。请求输入一旦超过 272K token,整个请求的输入和缓存费率翻倍、输出涨到 1.5 倍。一条 300K token 的提示词按输入 16 美元、输出 60 美元计费,而不是只对超出的部分加价。如果你要把整个仓库喂给 Astra,尽量拆分或把缓存控制在 272K 以内。
Batch 适合可以等待的评测和回填任务;VentureBeat 报道称 Batch 为半价。
各档位的标准速率限制:
| 档位 | 每分钟请求数 | 每分钟 token 数 |
|---|---|---|
| Build | 5,000 | 1,000,000 |
| Launch | 10,000 | 4,000,000 |
| Grow | 15,000 | 40,000,000 |
遇到 429 响应时用指数退避重试。在 xhigh 下跑长时间 agent,很容易在 Build 档把 token 预算烧光。
从 GPT-6 Astra 迁移到 GPT-6.2 Astra
多数代码只需改一处:模型字符串。上线前请检查以下几点:
- 模型 ID:
gpt-6-astra改为gpt-6.2-astra。 none强度: 任何还在发送它的代码路径现在都会失败,换成你的评测能接受的最低值。- prompt caching: 缓存输入从 1.00 美元降到 0.40 美元,稳定的系统提示词和工具列表现在更值得缓存。
- 长提示词: 接近 272K token 的请求要按上面的长上下文规则重新核算。
- 安全性: OpenAI 表示两个 GPT-6.2 模型都达到了「Critical」网络安全阈值,配备了更严格的防护。安全类工具的提示词可能收到以前没有的拒绝。
早期评价褒贬不一,切换前务必测试。据 VentureBeat 的汇总,Ethan Mollick 称 Astra「非常不稳定、很奇怪」,Dan Shipper 说它在端到端构建中经常过早停止;也有人称赞它的代码审查和 computer use。只有你自己的提示词才算基准。GPT-6 Astra API 指南覆盖了上一代可以沿用的部分;如果你的流量以常规任务为主,GPT-6.1 Sol API 指南展示了更便宜档位的请求形态。
让编码代理持续测试 GPT-6.2 Astra
在终端里粘贴提示词,只能说明 Astra 今天表现如何,说明不了下个月某次更新会不会打破你的 schema。更好的做法是让编码代理把检查写成用例并持续运行,你只写一条提示词。(Apifox 是否提供等价的 CLI 与用例运行能力,待核实)
为 POST https://api.openai.com/v1/responses 创建一个测试用例:
模型用 "gpt-6.2-astra",推理强度 "high",并挂一个 get_order_status 函数工具。
断言状态码 200,输出中包含名为 get_order_status 的 function_call,
其 arguments 能解析为带 order_id 的 JSON,且 usage.output_tokens 小于 4000。
API key 从环境 <envId> 的 OPENAI_API_KEY 变量读取,然后运行。
把密钥放在测试环境里而不是提示词里,它就不会停留在代理的上下文中。重复执行多次可以看出 Astra 的工具调用是否稳定;把结果输出为 JUnit 格式接进流水线,每次部署都会自动重跑这道检查。
常见问题
GPT-6.2 Astra API 的模型 ID 是什么? gpt-6.2-astra,更便宜的兄弟型号是 gpt-6.2-sol。两者都支持 Responses、Chat Completions 和 Batch 端点。
GPT-6.2 Astra API 怎么收费? 每百万输入 token 8 美元、每百万缓存输入 token 0.40 美元、每百万输出 token 40 美元。输入超过 272K token 的请求,整个请求的输入翻倍、输出按 1.5 倍计算。
为什么我的请求因为 reasoning effort none 失败? 两个 GPT-6.2 模型都拒绝 "effort": "none"。改用 high,或者用你测试下来能完成任务的最低一档。
GPT-6.2 Astra 的上下文窗口有多大? 总计 1,050,000 token,其中最多 922,000 输入 token、128,000 输出 token。
能在 Chat Completions API 里用 GPT-6.2 Astra 吗? 可以。不过 web search、computer use、apply patch 等托管工具只列在 Responses API 下,agent 类工作请走 Responses。
GPT-6.2 Astra 有免费额度吗? API 没有,每次调用都计费。在 ChatGPT Work 和 Codex 中,Plus、Pro、Enterprise 和 Edu 套餐包含该模型,见 OpenAI 的发布公告。