摘要:2026 年 10 月 1 日,GitHub 发布 Actions Runner Controller 0.15.0。这次更新面向运维自托管 Runner 集群的团队,集中改掉了三件长期麻烦的事:补丁版本升级不再需要重建资源、优雅停机时间可配置、Reconcile 的并发与事件量可以按控制器调节。
导语:自托管 Runner 的运维有一个不对称的地方——集群越大,真正让人半夜起床的就越不是"Runner 跑不动",而是升级、缩容和清理这些控制面的动作。ARC 0.15.0 改的正是这一层。
发生了什么:一次以"稳定与可观测"为主题的版本
按 GitHub 官方 Changelog 的定位,0.15.0 关注的是 runner scale set 的可靠性、可伸缩性与可观测性,目标读者是运行大规模 Runner 集群的运维人员——在那种规模下,"控制器吞吐、优雅停机与准确的指标"这三件事会变得重要。
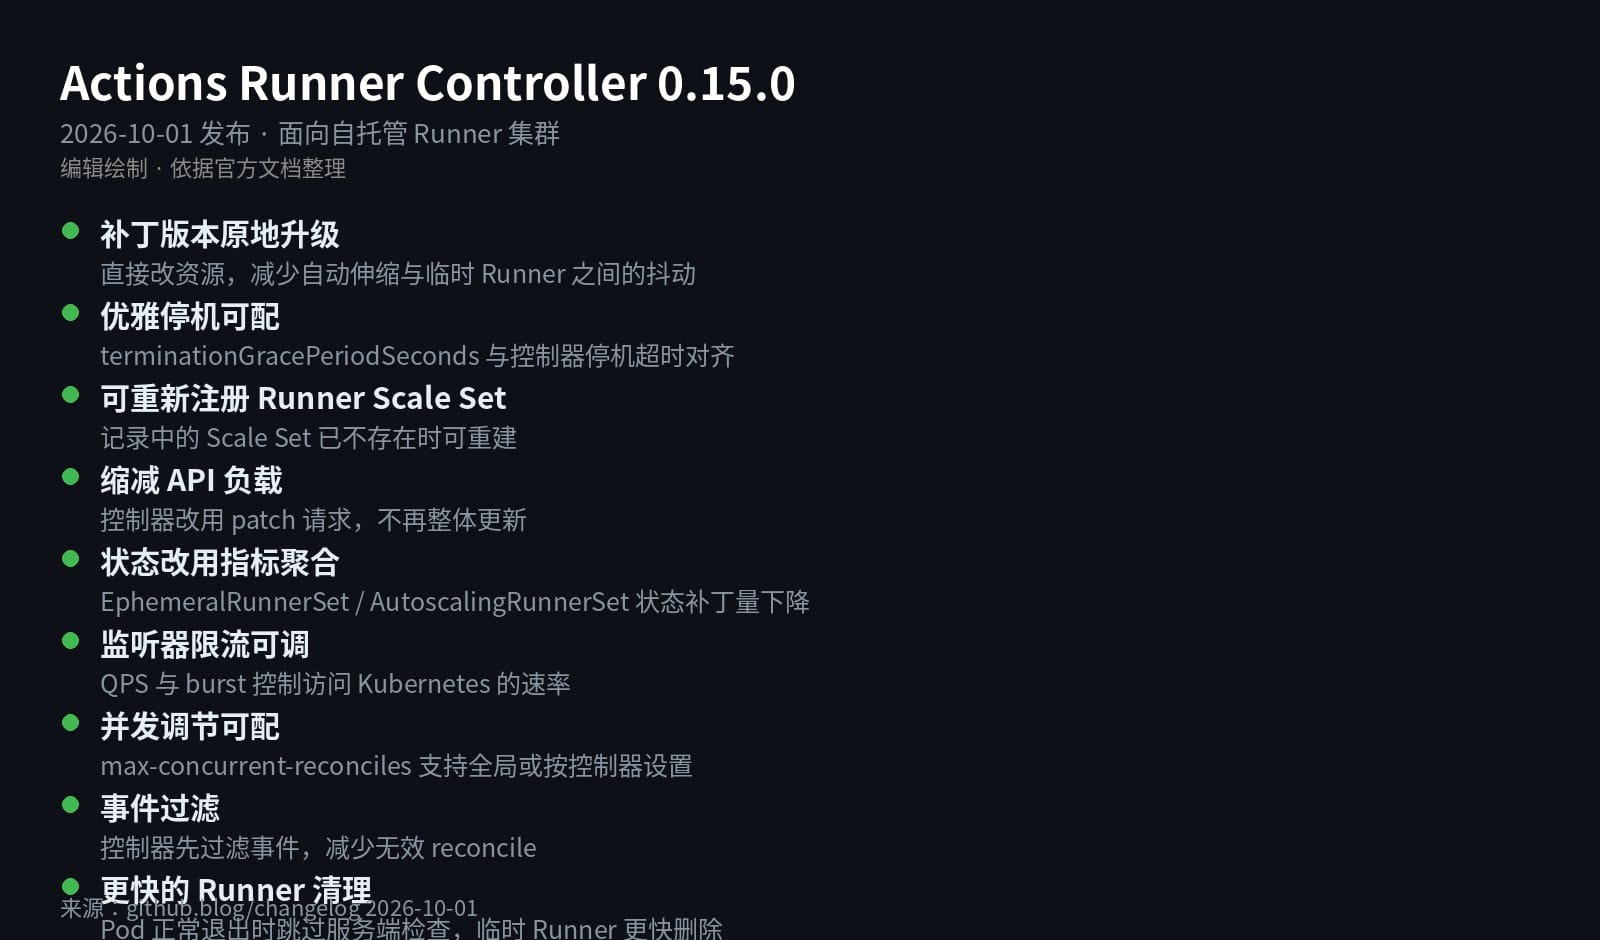
具体动作可以分成四组。第一组是升级与停机:补丁版本升级现在会直接修改资源(in-place patch),以此减少自动伸缩与临时 Runner 之间的扰动;terminationGracePeriodSeconds 变为可配置,并且会与控制器管理器的优雅停机超时对齐,避免两者各说各话。第二组是控制面负载:控制器的更新改用 patch 请求而不是整体 update,Runner 状态聚合从状态写入改为基于指标,官方称这降低了状态补丁的量。第三组是可调节项:QPS 与 burst 设置可以控制监听器访问 Kubernetes 的速率限制;max-concurrent-reconciles 支持全局或按控制器设置并发;控制器会先过滤传入事件,减少无效的 reconcile。第四组是恢复与清理:如果记录中的 Runner Scale Set 在 Actions 服务里已不存在,现在可以重新注册;当 Runner Pod 正常退出时,会跳过服务端的移除检查,从而更快删除临时 Runner。
一个完整场景:升级一次 ARC,不再需要"冻结伸缩"
设想一个跑了 200 个并发 Runner 的团队要做 ARC 的补丁升级。在旧的行为里,升级意味着改动资源定义,而资源定义同时被自动伸缩逻辑和临时 Runner 的生命周期共用——运维的常规做法是先冻结伸缩、排空在跑的 Job、升级、再恢复,整个过程需要选在低峰期,还要盯着有没有 Job 卡在中间。
0.15.0 把补丁升级改成原地修改资源之后,这条流程的破坏面明显收窄。配合可配置的 terminationGracePeriodSeconds,停机不再是一个固定的、凭猜测设的时长,而是可以和控制器自己的停机超时对齐——这一点在大集群里尤其重要,因为"控制器已经关了但 Runner 还以为自己在被管理"正是那类难以复现的偶发故障。
为什么它改变工作流:把控制面从"经验判断"拉回"可配置"
这次更新最实际的贡献,是把一批以前只能靠经验猜的量变成了显式参数。并发多少合适、监听器对 API Server 的压力多大、事件风暴时控制器会不会被自己的 reconcile 拖垮——以前这些问题的答案通常写在某个人的值班笔记里;现在它们对应到 max-concurrent-reconciles、QPS/burst 和事件过滤三个旋钮上。
事件过滤与指标化状态这两条,对规模化的意义比看起来大。Reconcile 是控制器的核心成本:每次事件都触发一轮对账,而大集群里大量事件其实是无关的。控制器自己在入口过滤掉无效事件,等于把成本从"每次都对账一遍"降到"只对需要的事件对账"。把 Runner 状态聚合从状态写入改成指标,则是把"状态"这种高频写入换成"指标"这种更便宜的载体,直接减轻了 etcd 和 API Server 的压力。
清理路径的改动同样值得单独说一句。临时 Runner 的设计前提是"用完就删",但删除本身要走一轮服务端检查;0.15.0 在 Runner Pod 正常退出的情况下跳过这一步,让临时 Runner 更快消失。对小集群这是一个几秒的差别,但对一个频繁起停几千个 Runner 的集群,它意味着节点回收不再被这些残留对象拖住。再加上"记录里的 Runner Scale Set 在 Actions 服务中已不存在时可以重新注册"这一条,控制器面对的不是"必须人工介入的损坏状态",而是可以自己收敛的偏差——这两条合在一起,才是这次更新被称为"面向运维"的原因。
边界:这是运维版本,不是功能版本;官方未提及破坏性变更
需要说清楚三点:
- 官方 Changelog 未提及任何破坏性变更、弃用或必需的迁移步骤。这不等于"升级一定无风险"——它只说明这一版没有对外声明需要手动处理的变更。实际升级前仍应按自己的版本跨度检查 ARC 文档。
- 这些都是集群侧收益,不会让你的 CI 变快。它优化的是控制器的吞吐、停机与清理,不会改变单个 Job 的执行速度。
- 自托管 Runner 的前提没变。ARC 依然要求你自己维护 Kubernetes 集群、镜像与网络出口;这次更新没有改变自托管与 GitHub 托管 Runner 之间的成本与责任划分。
人需要接管的判断点在于参数取值本身。QPS、burst 与并发上限都直连 API Server,设得过高会把压力转嫁给集群,设得过低会让 Runner 排队。官方只给了旋钮,没有给推荐值——这仍然需要运维按自己集群的规模做容量判断,并且在小范围灰度之后才放开。
如何试用
ARC 通过 Helm 安装与升级,0.15.0 的升级动作与以往一致:先把 Chart 版本更新到 0.15.0,再在低峰期做一次补丁升级验证原地升级的行为是否符合预期。对于此前被停机问题困扰的集群,可以在升级时一并显式设置 terminationGracePeriodSeconds;对于事件量较大的集群,建议先打开事件过滤观察 reconcile 次数与 API Server 的请求量变化,再决定是否调整并发与限流参数。具体命令与参数说明以官方 Actions Runner Controller 文档为准。
信息来源
- GitHub Changelog,2026-10-01,Actions Runner Controller release 0.15.0:
https://github.blog/changelog/2026-10-01-actions-runner-controller-release-0-15-0 - Actions Runner Controller 官方文档(安装、升级与控制器参数)
说明:本文列出的九项变更与"未提及破坏性变更"均来自上述官方 Changelog;关于冻结伸缩、灰度顺序的建议属于编辑分析,不代表 GitHub 官方建议。
HiFox:将 Agent 变成真正的队友
另外,我们也在思考,AI 如何从个人提效走进团队协作。
HiFox 是一个让人和 AI Agent 在同一个工作现场协作的平台:你可以像给同事分派任务一样指派 Agent,在任务看板中跟踪进度、查看结果,让 Agent 成为团队里的队友。
👉 立即体验 HiFox:https://hifox.com
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,
欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
