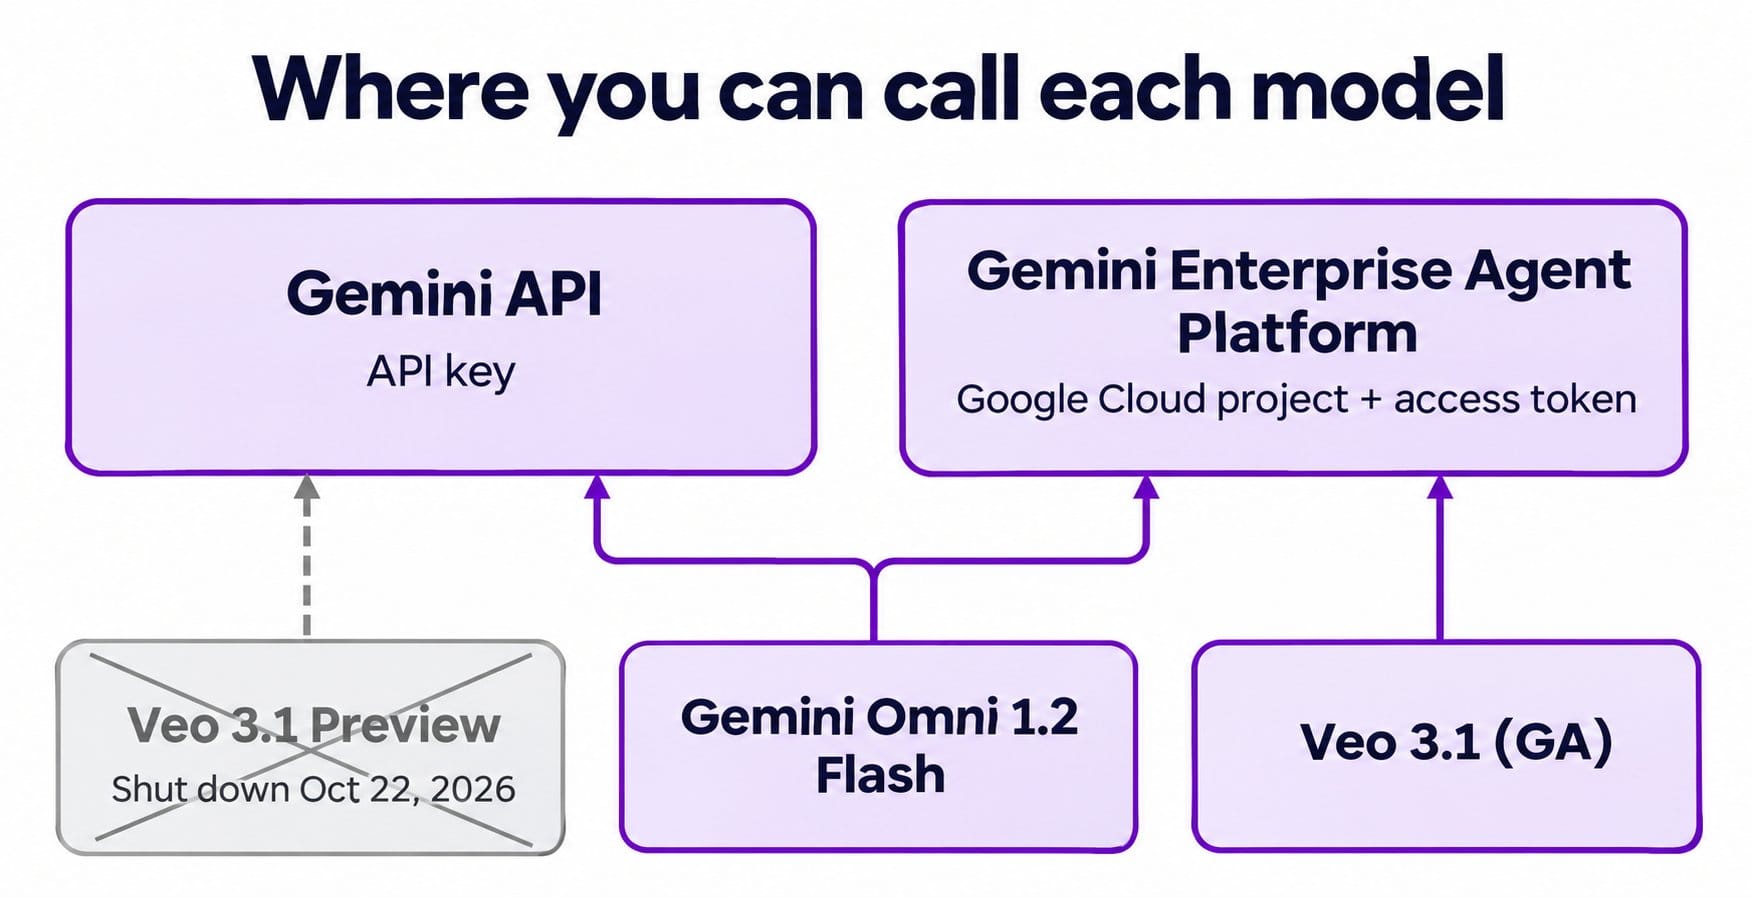
简要回答: 如果你希望只用一个 API Key 接入、支持多轮对话式编辑,或单次生成最长 15 秒的视频片段,请基于 Gemini Omni 1.2 Flash 构建。只有当你已经运行在 Google Cloud 上,且需要单次请求生成最多 4 个视频(sampleCount)等专属参数控制时,才建议选择 Veo 3.1。目前你已无法通过 Gemini API 调用 Veo:其预览版(Preview)模型已于 2026 年 10 月 22 日关停。
这次下线让原本的“模型选型对比”变成了一次“接入平台决策”。我们的 Omni 1.1 与 Veo 3.1 对比文章梳理了早期规格;本文将直接回答当下最实际的工程问题:现在新项目应该基于哪一个构建?
Google 未公布 Omni 1.2 的基准评测分数,因此本文不对两者的肉眼画质做主观排名。下文列出的规格与价格均基于 2026 年 11 月 6 日查阅的 Google 官方文档。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
Gemini Omni 1.2 Flash 与 Veo 3.1 核心规格速览
| Gemini Omni 1.2 Flash | Veo 3.1 | |
|---|---|---|
| 状态 | 正式版(GA) | generate-001 与 fast-generate-001 为 GA,lite-generate-001 为预览版(Preview) |
| 调用平台 | Gemini API、Gemini Enterprise Agent Platform | 仅限 Agent Platform |
| 认证方式 | API Key(Gemini API) | Google Cloud 项目与访问令牌 |
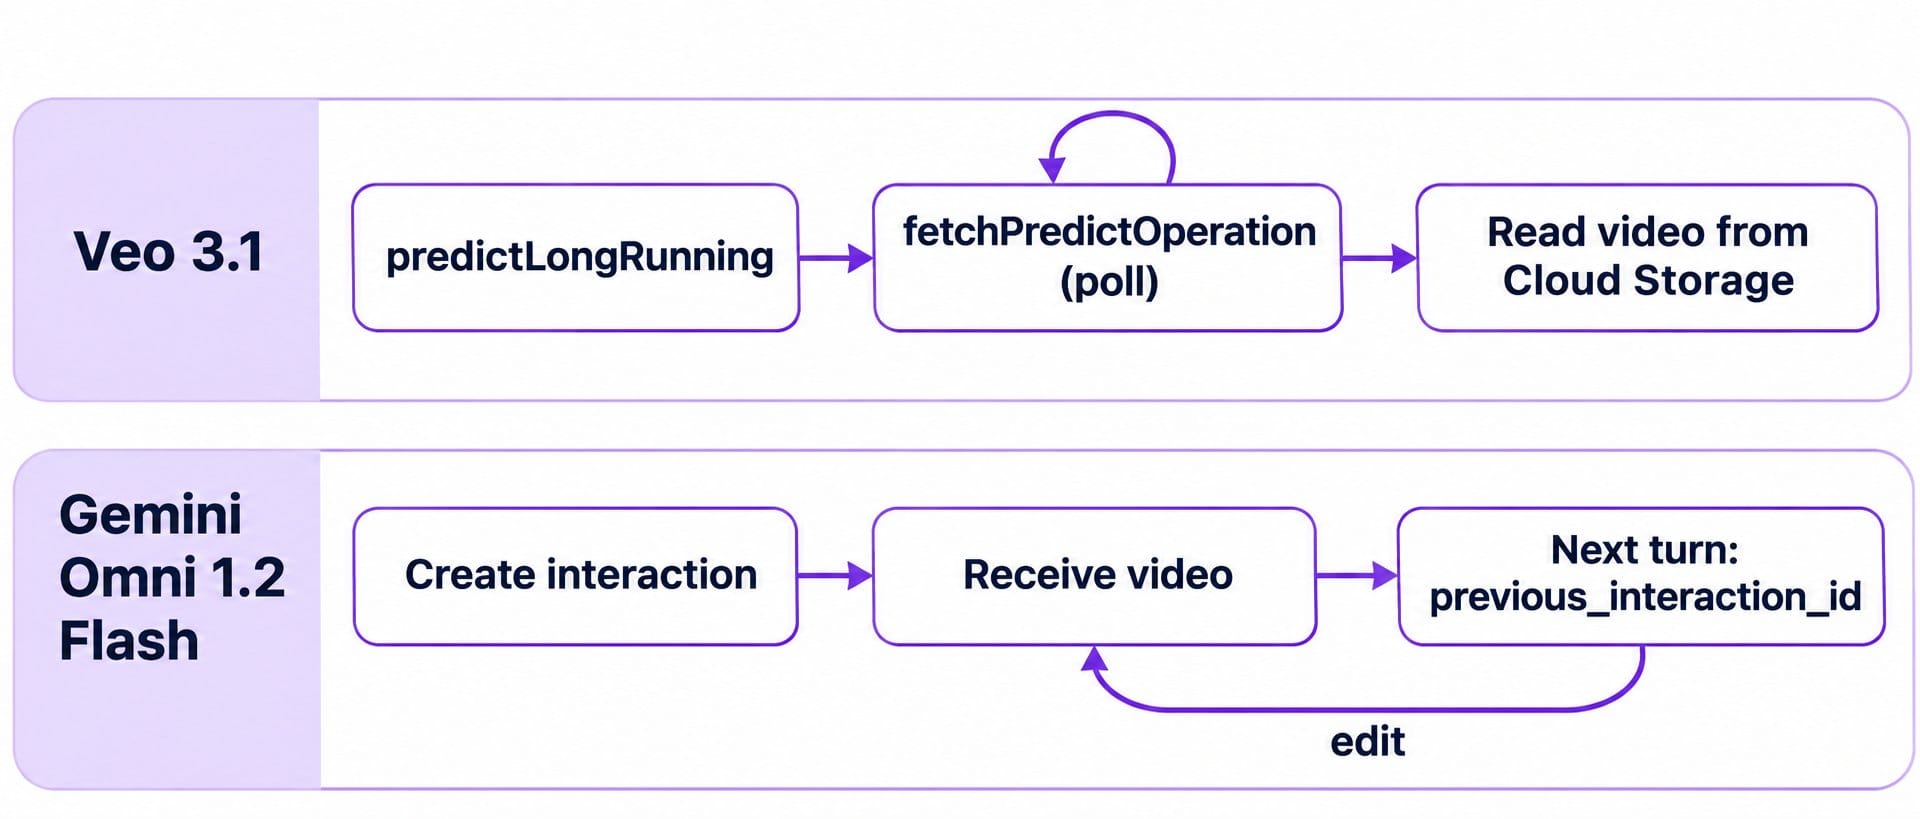
| 请求形式 | Interactions API | predictLongRunning,配合 fetchPredictOperation 轮询 |
| 区域(Location) | Agent Platform 上为 global |
us-central1 |
| 单段时长 | 3 至 15 秒(以 1 秒为步长) | 4、6 或 8 秒 |
| 音频支持 | 原生音频 | 支持声音生成 |
| 分辨率 | 360p、720p、1080p 与 4K(上采样) | 720p、1080p,Veo 3.1 标准版支持 4K |
| 视频延展 | 每轮追加 3 至 10 秒 | 每次调用追加 7 秒,总长上限 37 秒 |
| 多轮编辑 | 支持(通过 previous_interaction_id) |
我们查阅的文档中无对应功能 |
| 单次请求输出数 | 官方示例中每轮返回 1 段视频 | sampleCount 支持 1 至 4 段 |
| 负向提示词 | 不支持单独字段,需写进正文提示词 | 支持 negativePrompt 参数 |
| 最早退役时间 | 未列出 | 2027 年 5 月 4 日或更晚(GA 模型) |
规划时需留意一处文档矛盾:Omni 延展后的总时长上限因调用入口而异。Gemini API 文档写明总长最多 30 秒,而 Agent Platform 视频延展文档则写明最高可达 40 秒。如果你的产品对外承诺了视频时长,请务必在实际发版的入口上先行验证。
Veo 发生了什么变化
Gemini API 视频文档现已明确声明,Gemini API 中的 Veo 3.1 Preview 模型已关停。2026 年 10 月 22 日当天共有三个模型 ID 随之下线:
veo-3.1-generate-previewveo-3.1-fast-generate-previewveo-3.1-lite-generate-preview
Google 给出了两条替代路径:改用 Gemini Omni Flash,或者迁移到 Gemini Enterprise Agent Platform(Vertex AI 的继任平台)上的正式版(GA)Veo 模型。我们在 Google 当前的 Veo 模型页面中未发现比 3.1 更新的 Veo 版本。
这意味着,任何基于 AI Studio API Key 和 Veo 预览版模型 ID 构建的集成现在都已经无法工作。仅替换模型名称字符串并不能修复报错,因为正式版 Veo 运行在另一个平台上,认证方式也完全不同。包括我们之前的 Veo 3.1 API 指南在内的早期教程,当时都是基于预览版入口编写的。
两个 API 的每秒成本对比
Omni 按输出 token 计费,Veo 则按分辨率采用固定费率。以下均为带音频视频的每秒单价:
| 输出分辨率 | Omni 1.2 Flash | Veo 3.1(GA) | Veo 3.1 Fast(GA) | Veo 3.1 Lite(Preview) |
|---|---|---|---|---|
| 360p | $0.023 | 不支持 | 不支持 | 不支持 |
| 720p | 约 $0.07 | $0.40 | $0.10 | $0.05 |
| 1080p | $0.104 | $0.40 | $0.12 | $0.08 |
| 4K | $0.209 | $0.60 | $0.30 | 不支持 |
Omni 的数据来自 Google Gemini 定价页面(输入 token 另按每百万 $1.50 计费),其 1080p 和 4K 费率包含超分上采样。Veo 的数据来自 Agent Platform 价格表。该价格表按“count(次数/单位)”标注单价但未定义具体单位;由于这些数值与发布时报道的每秒费率完全吻合,我们将其按每秒单价解读,建议结合首月账单再次核对。此外价格表中还列出了 Fast 的 4K 单价,但模型说明页显示仅 Veo 3.1 标准版支持 4K 输出。
生成一段 8 秒的 720p 带音频视频,在 Omni 上约需 $0.56,在 Veo 3.1 上需 $3.20,在 Fast 上需 $0.80,在 Lite 上需 $0.40。Lite 是唯一一款带音频单价低于 Omni 的 Veo 模型,但它目前仍处于预览阶段。Veo 还单独提供了无音频(video-only)费率,例如 Fast 在 720p 下无音频为 $0.08/秒。关于 token 换算逻辑,可参考我们的 Omni 1.1 定价拆解文章并将视频输出单价替换为每百万 token $12.00。
此外,Google 将 Omni 1.2 和 1.1 的免费层级均列为“不提供(Not available)”。
什么时候应该选择 Gemini Omni 1.2 Flash
- 不想在调用链路里引入 Google Cloud 项目。 只需一个 API Key 加一次 POST 请求就能拿到生成的视频。
- 业务需要用户多轮微调视频。 传入
previous_interaction_id和新提示词,每一轮都会返回修改后的新视频。Google 建议在只修改单一元素时加上“Keep everything else the same(保持其余部分不变)”。 - 单次调用需要生成超过 8 秒的视频。 Omni 单次最高支持 15 秒,而 Veo 最长只能生成 8 秒。
- 需要低成本草稿模式。 生成一段 10 秒的 360p 测试视频仅需约 $0.23。
- 高度依赖参考图控制。 Omni 单次最多接收 6 张参考图(最多支持 2 个角色、每个角色最多 3 张参考图)。
选型前也需了解其局限性:Google 表示高速体育运动、剧烈切换的剧本动作和复杂物理规律仍在持续改进中;不支持上传音频文件;欧洲经济区(EEA)、瑞士和英国不支持编辑或延展上传的视频;所有输出视频均带有肉眼不可见的 SynthID 水印。
什么时候应该选择 Veo 3.1
- 基础设施已经运行在 Google Cloud 上。 项目、IAM 权限和 Cloud Storage 存储桶均已就绪,没有额外的平台搭建成本。
- 希望单次请求生成多个候选版本。
sampleCount参数支持一次调用返回最多 4 段视频。 - 工作流依赖
negativePrompt字段。 Omni 没有独立的负向提示词参数。 - 需要明确标注的模型退役日期。 Google 为 GA 模型列出的最早退役时间为 2027 年 5 月 4 日或更晚,便于提前规划迁移周期。反面例子正是 Omni 1.1 的短周期切流:自 2026 年 12 月 3 日起,发往
gemini-omni-1.1-flash的请求将自动路由至 1.2 并按 1.2 费率计费。 - 需要在欧洲经济区(EEA)、瑞士或英国延展上传的视频素材。 Veo 的视频延展文档中未列出这一地区限制,但正式投入开发前仍建议在目标区域实测确认。
相应的代价是:固定在 us-central1 区域、必须配置 Google Cloud 项目,以及需要自己实现异步轮询循环。用于延展的输入视频必须是 24 fps、时长 1 至 30 秒的 MP4 文件。此外,视频延展文档虽然在模型表格中列出了 Lite,但在 REST 接口说明部分却未包含它,因此 Lite 是否支持视频延展仍有待确认。
将现有 Veo 集成迁移到 Interactions API
迁移到 Omni 需要同时修改请求体结构、轮询方式和响应解析逻辑。下面是遵循 Google 官方文档的 Veo 视频延展调用:
POST https://us-central1-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/us-central1/publishers/google/models/veo-3.1-generate-001:predictLongRunning

{
  "instances": [{
    "prompt": "The drone keeps climbing above the harbor",
    "video": { "gcsUri": "gs://my-bucket/clip.mp4", "mimeType": "video/mp4" }
  }],
  "parameters": { "storageUri": "gs://my-bucket/out/", "sampleCount": 1 }
}
同样的任务通过 Agent Platform 调用 Omni 时,请求格式如下:
POST https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID/locations/global/interactions

{
  "model": "gemini-omni-1.2-flash",
  "store": false,
  "input": [
    { "type": "text", "text": "The drone keeps climbing above the harbor" },
    { "type": "video", "uri": "gs://my-bucket/clip.mp4", "mime_type": "video/mp4" }
  ],
  "response_format": [{
    "type": "video",
    "delivery": "uri",
    "gcs_uri": "gs://my-bucket/out/",
    "aspect_ratio": "16:9",
    "duration": "7s"
  }],
  "generation_config": { "video_config": { "task": "extend" } }
}
字段映射关系如下表所示:
| Veo 字段 | Omni 对应字段 |
|---|---|
instances[0].prompt |
input 中的文本项(text item) |
instances[0].video.gcsUri |
input 中视频项的 uri |
parameters.storageUri |
response_format 中的 gcs_uri |
parameters.aspectRatio |
response_format 中的 aspect_ratio |
parameters.seed |
generation_config.seed |
parameters.negativePrompt |
直接在提示词正文里写“Do not do X” |
parameters.sampleCount |
我们查阅的文档中无对应字段,需分多次请求发送 |
fetchPredictOperation |
设置 background: true,随后对 interaction ID 发起 GET 请求 |
videos[].gcsUri |
steps 中类型为 model_output 的视频项 |
迁移时需特别注意四个细节:
response_format的结构差异。 Agent Platform 示例将response_format包在数组中,而 Gemini API 文档则将其描述为单个对象,请严格按照所调用平台的格式传参。- 时长参数格式。 Omni 要求传入类似
"7s"的字符串(全新生成支持"3s"至"15s",视频延展支持"3s"至"10s")。 - URI 丢失陷阱。 在 Gemini API 上,即使创建时请求了 URI 交付,后续调用
GET /v1beta/interactions/{id}仍会返回内联的 base64 数据。URI 仅保证在创建响应或流式响应中返回,请务必在创建时直接保存。 - 多轮编辑依赖会话存储。 如果设置了
store: false,后续将无法在下一轮对话中继续编辑该视频。
如果是首次调用 Interactions API,我们的 Omni 1.1 API 指南在替换新模型 ID 后同样适用。
使用 Apifox CLI 让编程智能体同时测试两套模型
如果你后续可能切换模型供应商,或者同时混用两套模型,最稳妥的做法是维护一套与底层模型无关的统一契约测试。你可以把这项工作交给编程智能体:让它通过 Apifox CLI 定义两个端点,分别封装成测试场景,并归入同一个测试套件中执行相同的断言。
npm install -g apifox-cli@latest
apifox auth login --with-token <YOUR_TOKEN>
apifox skill install
随后向 Claude Code、Codex 或 Cursor 提供一条提示词:
In Apifox project <id>, create endpoints for Gemini Omni 1.2 Flash
(POST /v1beta/interactions) and Veo 3.1 Fast (predictLongRunning plus
fetchPredictOperation). Build one test scenario per provider and put both
in a test suite named video-provider-contract. Poll Veo until done. Assert
the same things on each: the job finishes, the output is video/mp4, and a
video URI or data field is present. Run it and summarize any failures.
智能体会依次读取各项 schema、校验请求载荷,随后构建并运行该测试套件:
apifox cli-schema get endpoint-create
apifox cli-schema validate endpoint-create --file omni.json
apifox endpoint create --project <id> --file omni.json
apifox test-scenario create --project <id> --name "omni-contract" --folder-id <folderId> --priority 1
apifox test-scenario import-steps <scenarioId> --project <id> --source endpoint --ids <endpointId> --sync manual
apifox test-suite create --project <id> --name "video-provider-contract"
apifox test-suite update <suiteId> --project <id> --file suite.json
apifox run --test-suite <suiteId> --project <id> -e <envId> \
  --timeout-request 300000 -r cli,junit --out-dir ./reports
这样一来,切换底层供应商时任何不兼容都会在断言阶段直接暴露,而不会等到生产环境播放器报错。由于每次运行都会产生真实的视频计费,请尽量使用最短小的测试规格:一段 3 秒 360p 的 Omni 视频加上一段 4 秒 720p 的 Veo Fast 视频合计约 $0.47,建议配置为每晚定时运行,而非每次提交代码都触发。同一条运行命令可直接接入 CI 流水线,详见我们的 Apifox CLI CI/CD 指南。
常见问题
现在还能用 Gemini API Key 调用 Veo 吗? 不能。Gemini API 中的 Veo 3.1 Preview 模型已于 2026 年 10 月 22 日关停。正式版(GA)模型运行在 Gemini Enterprise Agent Platform 上,需要绑定 Google Cloud 项目并使用访问令牌认证。
有 Veo 4 吗? 截至 2026 年 11 月 6 日,我们在官方渠道未发现 Veo 4,Google 当前的 Veo 模型页面仅列出了 3.1 系列模型。
我现有的 Omni 1.1 代码会怎样? 自 2026 年 12 月 3 日起,发往 gemini-omni-1.1-flash 的请求将自动路由至 gemini-omni-1.2-flash 并按 1.2 费率计费。原有的模型字符串仍可正常工作,但由于底层模型发生了变化,请务必在此日期前在 1.2 上重新测试现有提示词。
哪款模型生成的视频画面更好看? Google 未公布两者的对比基准跑分,因此我们不做主观定论。建议用同一组业务提示词在两款模型上分别生成样片并自行评估。