截至 2026 年 11 月 11 日,Google 的 Gemini 4 Carbon API 使用模型 ID gemini-4-carbon,在 2026 年 11 月 30 日之前的价格为每百万输入 token $2、每百万输出 token $10,之后恢复为 $4 与 $20。Google 已于 2026 年 11 月 10 日将其正式全面开放(GA),且仅在 Gemini API 的付费层级中提供。
本指南将带你从申请新密钥一路跑通第一个请求,解析决定实际账单的关键用量字段,并演示如何把接口回归测试交给你的编码 Agent 自动完成。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
Gemini 4 Carbon 的模型 ID 是什么?
Gemini 4 Carbon 的模型 ID 为 gemini-4-carbon。你可以在发往 Gemini API Interactions 端点的请求体中将其作为 model 字段传入,也可以在 Python / JavaScript SDK 或 Google AI Studio 提示词中使用它。Google 将 Carbon 称为旗下最强的推理模型,建议将其用于高难度任务;而日常工程工作则继续以 Gemini 4 Argon 作为默认模型。
想先了解模型本身的背景,可以阅读 Gemini 4 Carbon 是什么。
| 项目 | 值 | 来源 |
|---|---|---|
| 模型 ID | gemini-4-carbon |
Google AI Studio 文档 |
| 开放时间 | 2026 年 11 月 10 日 | Google 发布公告 |
| 可用渠道 | Gemini API 付费层级、Google AI Studio、Android Studio | Google 发布公告 |
| 免费层级 | 不提供 | Google AI Studio 文档 |
| 上下文窗口 | 1,048,576 tokens(由输入、思考与输出共享) | Google AI Studio 文档 |
| 单次同步响应最大输出 | 65,536 tokens | Google AI Studio 文档 |
| 超长解码(Long decode) | 开启 background: true 时最高可达 1M tokens 减去输入长度 |
Google AI Studio 文档 |
| 思考等级(Thinking levels) | low、medium(默认)、high |
Google AI Studio 文档 |
| 价格(至 2026 年 11 月 30 日) | 每百万输入 token $2,输出 token $10 | Google 发布公告 |
| 价格(2026 年 12 月 1 日起) | 每百万输入 token $4,输出 token $20 | Google 发布公告 |
| 缓存输入(隐式缓存) | 每百万 token $0.10,12 月 1 日起为 $0.20 | Google AI Studio 文档 |
如何获取用于 Gemini 4 Carbon 的 Gemini API 密钥?
Carbon 仅运行在付费层级上,因此光有一个普通 API 密钥还不够,你的密钥所属项目必须绑定 Cloud Billing 计费账户:
- 打开 Google AI Studio 中的 API keys 页面。新用户会自动创建一个项目和密钥;老用户可点击 Create API key。
- 在 API keys 或 Projects 页面上点击 Set up billing(设置计费)。
- 按照 Google 快速入门的要求,创建或关联一个 Cloud Billing 账户,添加付款方式并预充值至少 $5 的额度。
- 在终端中导出密钥:
export GEMINI_API_KEY="YOUR_API_KEY"。
如果你想了解完全不需要 API 密钥的使用方式,可参考 Gemini 4 Carbon 免费使用方式汇总。
如何发送你的第一个 Gemini 4 Carbon API 请求?
Google 官方的 Carbon 快速入门使用 Interactions API:向 /v1beta/interactions 发送 POST 请求,并在请求体中传入 model 和 input。建议将模型名称保存在环境变量中,方便后续在 Carbon 与 Argon 之间一行切换。
使用 curl:
export GEMINI_MODEL="gemini-4-carbon"

curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "'"$GEMINI_MODEL"'",
    "input": "Find the race condition in this retry loop and rewrite the lock safely.",
    "generation_config": {
      "thinking_level": "medium"
    }
  }'
使用 Python SDK(pip install -U google-genai):
import os
from google import genai

MODEL = os.environ.get("GEMINI_MODEL", "gemini-4-carbon")

client = genai.Client()  # 自动从环境变量读取 GEMINI_API_KEY

interaction = client.interactions.create(
    model=MODEL,
    input="Find the race condition in this retry loop and rewrite the lock safely.",
    generation_config={"thinking_level": "medium"},
)

print(interaction.output_text)
print(interaction.usage)
以上两段代码均遵循 Google 官方文档中的示例。由于撰写本文的机器上没有绑定付费 Carbon 密钥,我们未在本机实际执行这两段代码,首次接入时请对照你自己的真实响应核对返回结构。
来自 Google 迁移说明的三个细节可以帮你省去不少排查时间:
- 移除采样参数。
temperature、top_p和top_k会被 Carbon 直接忽略,建议从请求体中删掉。 - 调高超时时间。 高难度提示词可能需要数分钟才能完成推理。Google 建议开启后台执行(background execution),或者将 HTTP 客户端超时设为至少 15 分钟。
- 在服务端保存对话状态。 进行多轮对话和工具调用时,请传入
previous_interaction_id,而不必每轮重发整段历史记录。
已经在用 Argon?我们的 Gemini 4 Argon API 指南使用的是完全相同的请求结构。
如何解读响应中的 usage 与思考 token?
每次 interaction 调用都会返回一个 usage 对象。以下是直接决定账单金额的字段:
total_input_tokens:你发送的输入总量,包含系统指令和工具声明。total_thought_tokens:模型在给出最终回答前用于内部推理思考的 token 数量。total_output_tokens:最终可见的回答文本。total_tokens:以上各项之和。
最需要紧盯的字段是 total_thought_tokens。Google 的思考机制指南明确指出,响应侧的计费基准是“输出 token 与思考 token 之和”,因此思考过程同样按每百万 token $10(12 月起为 $20)的输出单价计费。Google 还表示,为了探索和验证结果,Carbon 在每一轮中“比 Argon 消耗更多的思考 token”。在处理高难度提示词时,思考 token 往往占据了整张账单的大头。
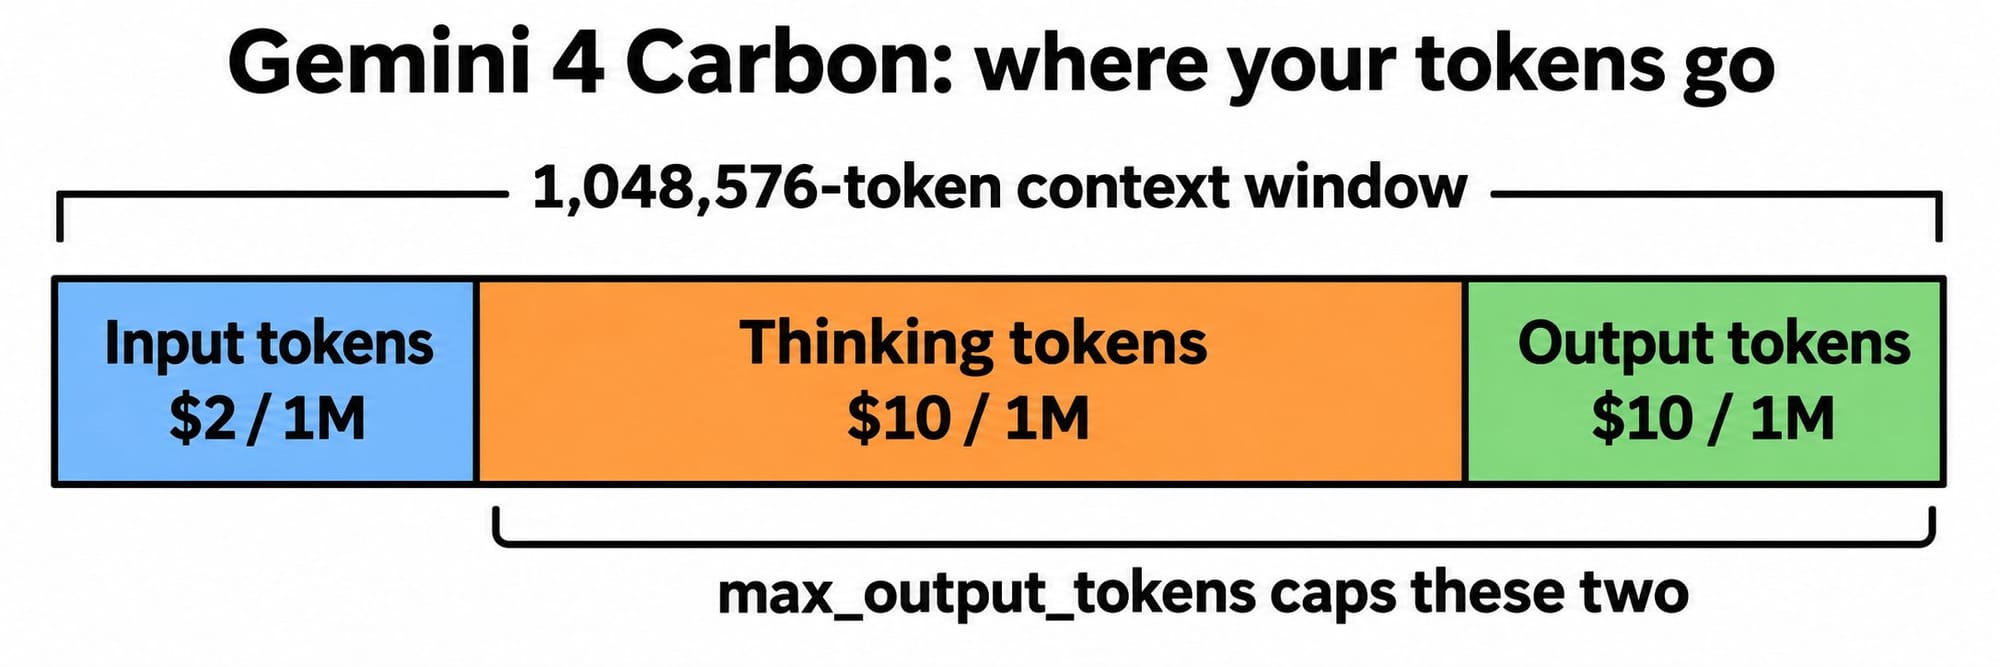
max_output_tokens 同时限制了“思考 + 输出”的总和。如果你把这个值设得太低,Carbon 可能会在思考阶段就把预算用光,导致最终回答被截断。Google 给出的起点建议如下:
- 常规任务: 保持默认值 65,536。
- 当前上限低于 32K 的应用: 至少调高到 32,768。
- 复杂推理与编码: 设置
background: true,并将上限设为 131,072 或 262,144 tokens。
开启 background: true 后,Google 服务端会以 64K token 为步长持续生成响应。你只需轮询该 interaction,直到其状态离开 in_progress 或 queued,然后将每个 model_output 步骤中的文本拼接起来即可。
该选哪个 Gemini 4 Carbon 思考等级(thinking level)?
思考等级是你平衡生成质量、延迟和成本的核心开关。根据 Google 的 思考机制指南 和 Carbon 文档:
| 思考等级 | Token 消耗 | 适用场景 |
|---|---|---|
low |
消耗最少,延迟最低 | 简单且对成本敏感的任务、轻量分析与写作 |
medium(默认) |
均衡 | 大多数任务,包括复杂编码与 Agent 工作 |
high |
消耗最多,首字延迟最慢 | 高难度数学、科学问题,以及最棘手的编码或 Agent 任务 |
Google 建议在全部三个等级上跑一遍你的评测集,并保留能满足质量门槛的最低档位。在 Carbon 上,low 与 high 之间的差额就是你的预算去向。
什么时候该把任务发给 Gemini 4 Carbon 而不是 Argon?
Google 对此说得非常直接:“Argon 依然是绝大多数软件工程与知识工作的理想选择。”这两款模型共享 1M 上下文窗口、内置工具以及完全相同的首发单 token 价格,因此真正的区别在于每轮调用消耗多少 token。建议将复杂的根因调试、架构设计、高密度多模态综合分析、数学证明和安全审计交给 Carbon;而将交互式编码、日常功能开发和需要快速反馈的生产循环留在 Argon 上。我们的 Gemini 4 Carbon 与 Argon 对比做了更深入的拆解;如果你正在将 Carbon 与 Anthropic 的最新模型做权衡,可参考 Gemini 4 Carbon 对比 Claude Fable 5.2 以及 Claude Fable 5.2 API 指南。
单次 Gemini 4 Carbon API 调用成本是多少?
根据 Google 官方定价,在 2026 年 11 月 30 日之前,Gemini 4 Carbon 为每百万输入 token $2、每百万输出 token(含思考)$10;12 月 1 日起恢复为 $4 与 $20。
为了直观换算到单次调用,假设有一条包含 2,000 输入 token、6,000 思考 token 和 1,500 输出 token 的请求(注:以下为算术示例数字,并非实测记录):
- 输入:2,000 x $2 / 1M = $0.004
- 思考 + 输出:7,500 x $10 / 1M = $0.075
- 总计:目前约为 $0.079,12 月 1 日起约为 $0.158
不同提示词触发的思考 token 数量差异极大,因此请务必读取你自己的 usage 对象。完整的价格计算、12 月涨价影响及单任务成本对比可查看 Gemini 4 Carbon 定价解析。
让你的编码 Agent 用 Apifox CLI 测试 Carbon API
在调优过程中,你会反复修改思考等级、输出上限和提示词。与其每次改完都靠肉眼去盯 JSON 响应,不如让你的编码 Agent(Claude Code、Codex、Cursor)配合 Apifox CLI 编写一条可重复运行的自动化测试。
先安装 CLI 并完成登录:
npm install -g apifox-cli@latest
apifox auth login --with-token <YOUR_APIFOX_TOKEN>
apifox test-case category --project <PROJECT_ID>
然后给你的 Agent 发送一条提示词:
In Apifox project <PROJECT_ID>, create a test case for
POST https://generativelanguage.googleapis.com/v1beta/interactions
with the x-goog-api-key header read from the GEMINI_API_KEY variable in
environment <ENV_ID>. Send model "gemini-4-carbon",
a short prompt and thinking_level "low", and assert: HTTP 200, status is
"completed", usage.total_thought_tokens exists, and usage.total_tokens is
below 20000. Validate the CLI schema, run it and summarize any failures.
在测试中使用 low 档位可以让每次回归运行的成本保持在最低水平。Agent 会读取 schema、校验 payload 并运行用例(以下命令参数均对照 Apifox CLI 2.2.12):
apifox test-case category --project <PROJECT_ID>
apifox cli-schema get test-case-create
apifox cli-schema validate test-case-create --file case.json
apifox test-case create --project <PROJECT_ID> --file case.json
apifox test-case run <CASE_ID> --project <PROJECT_ID> -e <ENV_ID> -r cli,json
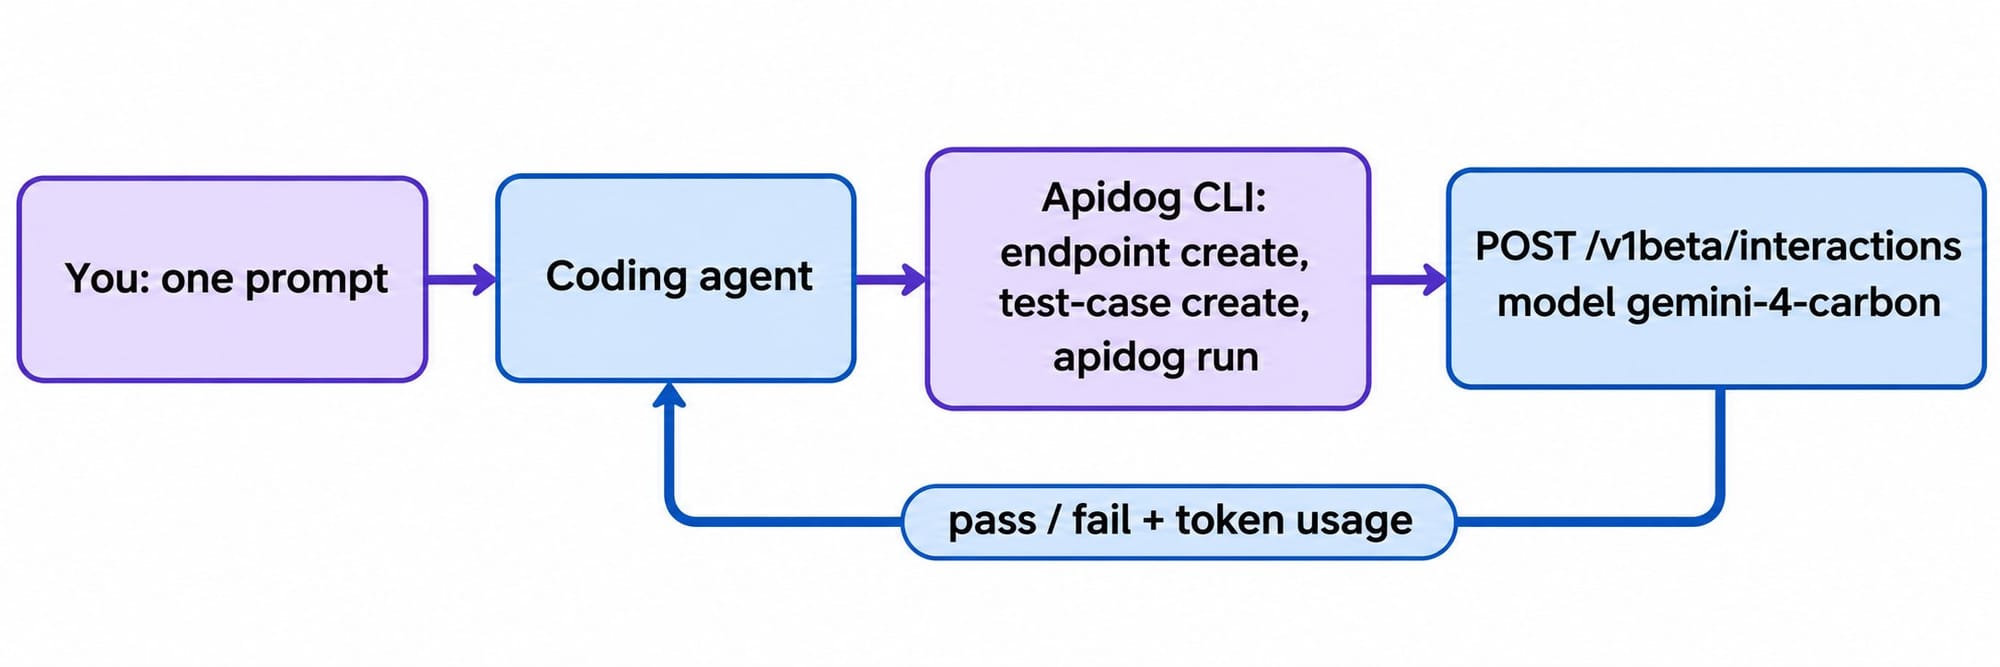
其中针对 token 预算的断言非常实用:如果某次提示词改动导致思考 token 暴涨并突破了你设定的阈值,测试就会在账单失控前直接报错拦截。把 -r cli,json 换成 -r junit,同一条命令就能直接放进 CI 流水线中运行。
常见问题
Gemini 4 Carbon API 是免费的吗? 不是。Google 文档明确指出 Gemini 4 Carbon 不在 Gemini API 的免费层级中提供。你需要一个绑定了 Cloud Billing 且预充值至少 $5 的付费层级项目。在个人消费端,Google 正在向 Gemini 应用、AI 模式和 Antigravity 中的 Google AI Ultra 订户逐步开放 Carbon。
Vertex AI 上可以使用 Gemini 4 Carbon 吗? Google 的发布公告点名了 Gemini API、Google AI Studio、Android Studio、Gemini 企业版、Antigravity 和 CodeMender,并未提及 Vertex AI,因此在基于 Vertex AI 做排期前请先核对 Google Cloud 的模型列表。
Gemini 4 Carbon 的上下文窗口是多大? 1,048,576 tokens,由输入、思考和输出共同分享。单次同步响应上限为 65,536 tokens;开启后台执行(background execution)后,单次响应最高可运行至 1M tokens 减去你的输入长度。
我可以使用 generateContent 代替 Interactions API 吗? Google 的 Carbon 快速入门使用的是 Interactions API,同时其文档在客户端超长解码续写场景中提到了 GenerateContent API。如果你的现有应用已经在使用 generateContent,建议在全面迁移前先实测直接替换模型 ID 是否可用。
如何从 Gemini 4 Argon 切换到 Carbon? 将模型字符串从 gemini-4-argon 改为 gemini-4-carbon 即可。Google 表示无需修改请求结构。由于 Carbon 思考耗时更长,建议同步调高 max_output_tokens 和 HTTP 超时时间,并在非必要时将 thinking_level 保持在 medium。