目前还没有公开的 Gemini 4 Argon API,Google 也没有公布模型 ID。Google 于 2026 年 9 月 30 日发布 Argon,目前仅面向 Fairwind Program 的防御方开放:一组 Fairwind 合作伙伴把它作为 Gemini Enterprise 上的托管模型使用。Artificial Analysis 把 Google AI Studio 列为 Argon 唯一的 API 提供商,但没有速度或延迟数据,这更符合被列入白名单的预发布访问,而不是一个你可以注册的接口。当更大范围的 rollout 开始时,Google 表示会“从付费 API 客户和 Google AI Ultra 订阅用户开始”,所以一个付费的 Gemini API key 能让你排在前面。
发布和可用之间的这段空白,是可以利用的时间。本指南把 Google 已确认的 Argon API 信息和未确认的分开,然后带你走一遍今天就能在 Gemini 3.8 Flash 上运行的代码,让切换到 Argon 变成只改一个变量。你将构建请求、设置上线提醒、在 Apifox 中 mock 响应,并按 Argon 的价格加上成本上限。关于模型本身,先从 what Gemini 4 Argon is 看起;关于 rollout 各阶段,见 Gemini 4 Argon release date guide。
关于 Gemini 4 Argon API,哪些已确认,哪些没有
Google 的 发布博客 给出了价格和输出上限。集成所需的其他几乎所有信息仍未公布。
| 项目 | 状态 | 详情 |
|---|---|---|
| 输入价格 | 已确认 | 每 1M token $2(介绍期),介绍期后 $4 |
| 输出价格 | 已确认 | 每 1M token $10(介绍期),之后 $20 |
| 缓存输入 | 已确认 | 输入优惠 95%:介绍期 $0.10,标准价 $0.20 |
| 输出上限 | 已确认 | 1M token,此前为 64K |
| API 形式 | 已示意 | Google 的文档称所有新模型都在 Interactions API 上发布 |
| 模型 ID | 未公布 | 在模型页面、定价页面和 changelog 中均无 |
| 输入上下文窗口 | 未公布 | Google 的长上下文评测使用了最长 1M token 的 prompt,但这并不是规格 |
| 思考档位 | 未公布 | 评测在“最高思考设置”下运行;名称和默认值未知 |
| 速率限制 | 未公布 | 未公布任何档位 |
| Batch 支持 | 未公布 | 没有 batch 或 Flex 定价 |
| 长 prompt 档位 | 未公布 | 3.1 Pro 在超过 200K 时收费更高;Argon 的规则未说明 |
| 介绍期时长 | 未公布 | $2/$10 没有结束日期 |
有两行值得细看。API 形式这一行来自 Interactions API 文档,其中称新模型“将在 Interactions API 上发布”。Argon 是新模型,所以预计它会先出现在那里;Google 没有说明 generateContent 是否会提供它。输出这一行是 Google 为模型声明的上限,但 Vals AI 在其测试的配置下列出的最大输出为 262K,所以不要假设每个接口在第一天都能提供完整的百万上限。我们的 1M 输出 token 指南涵盖了该上限对流式传输、超时和存储的影响。
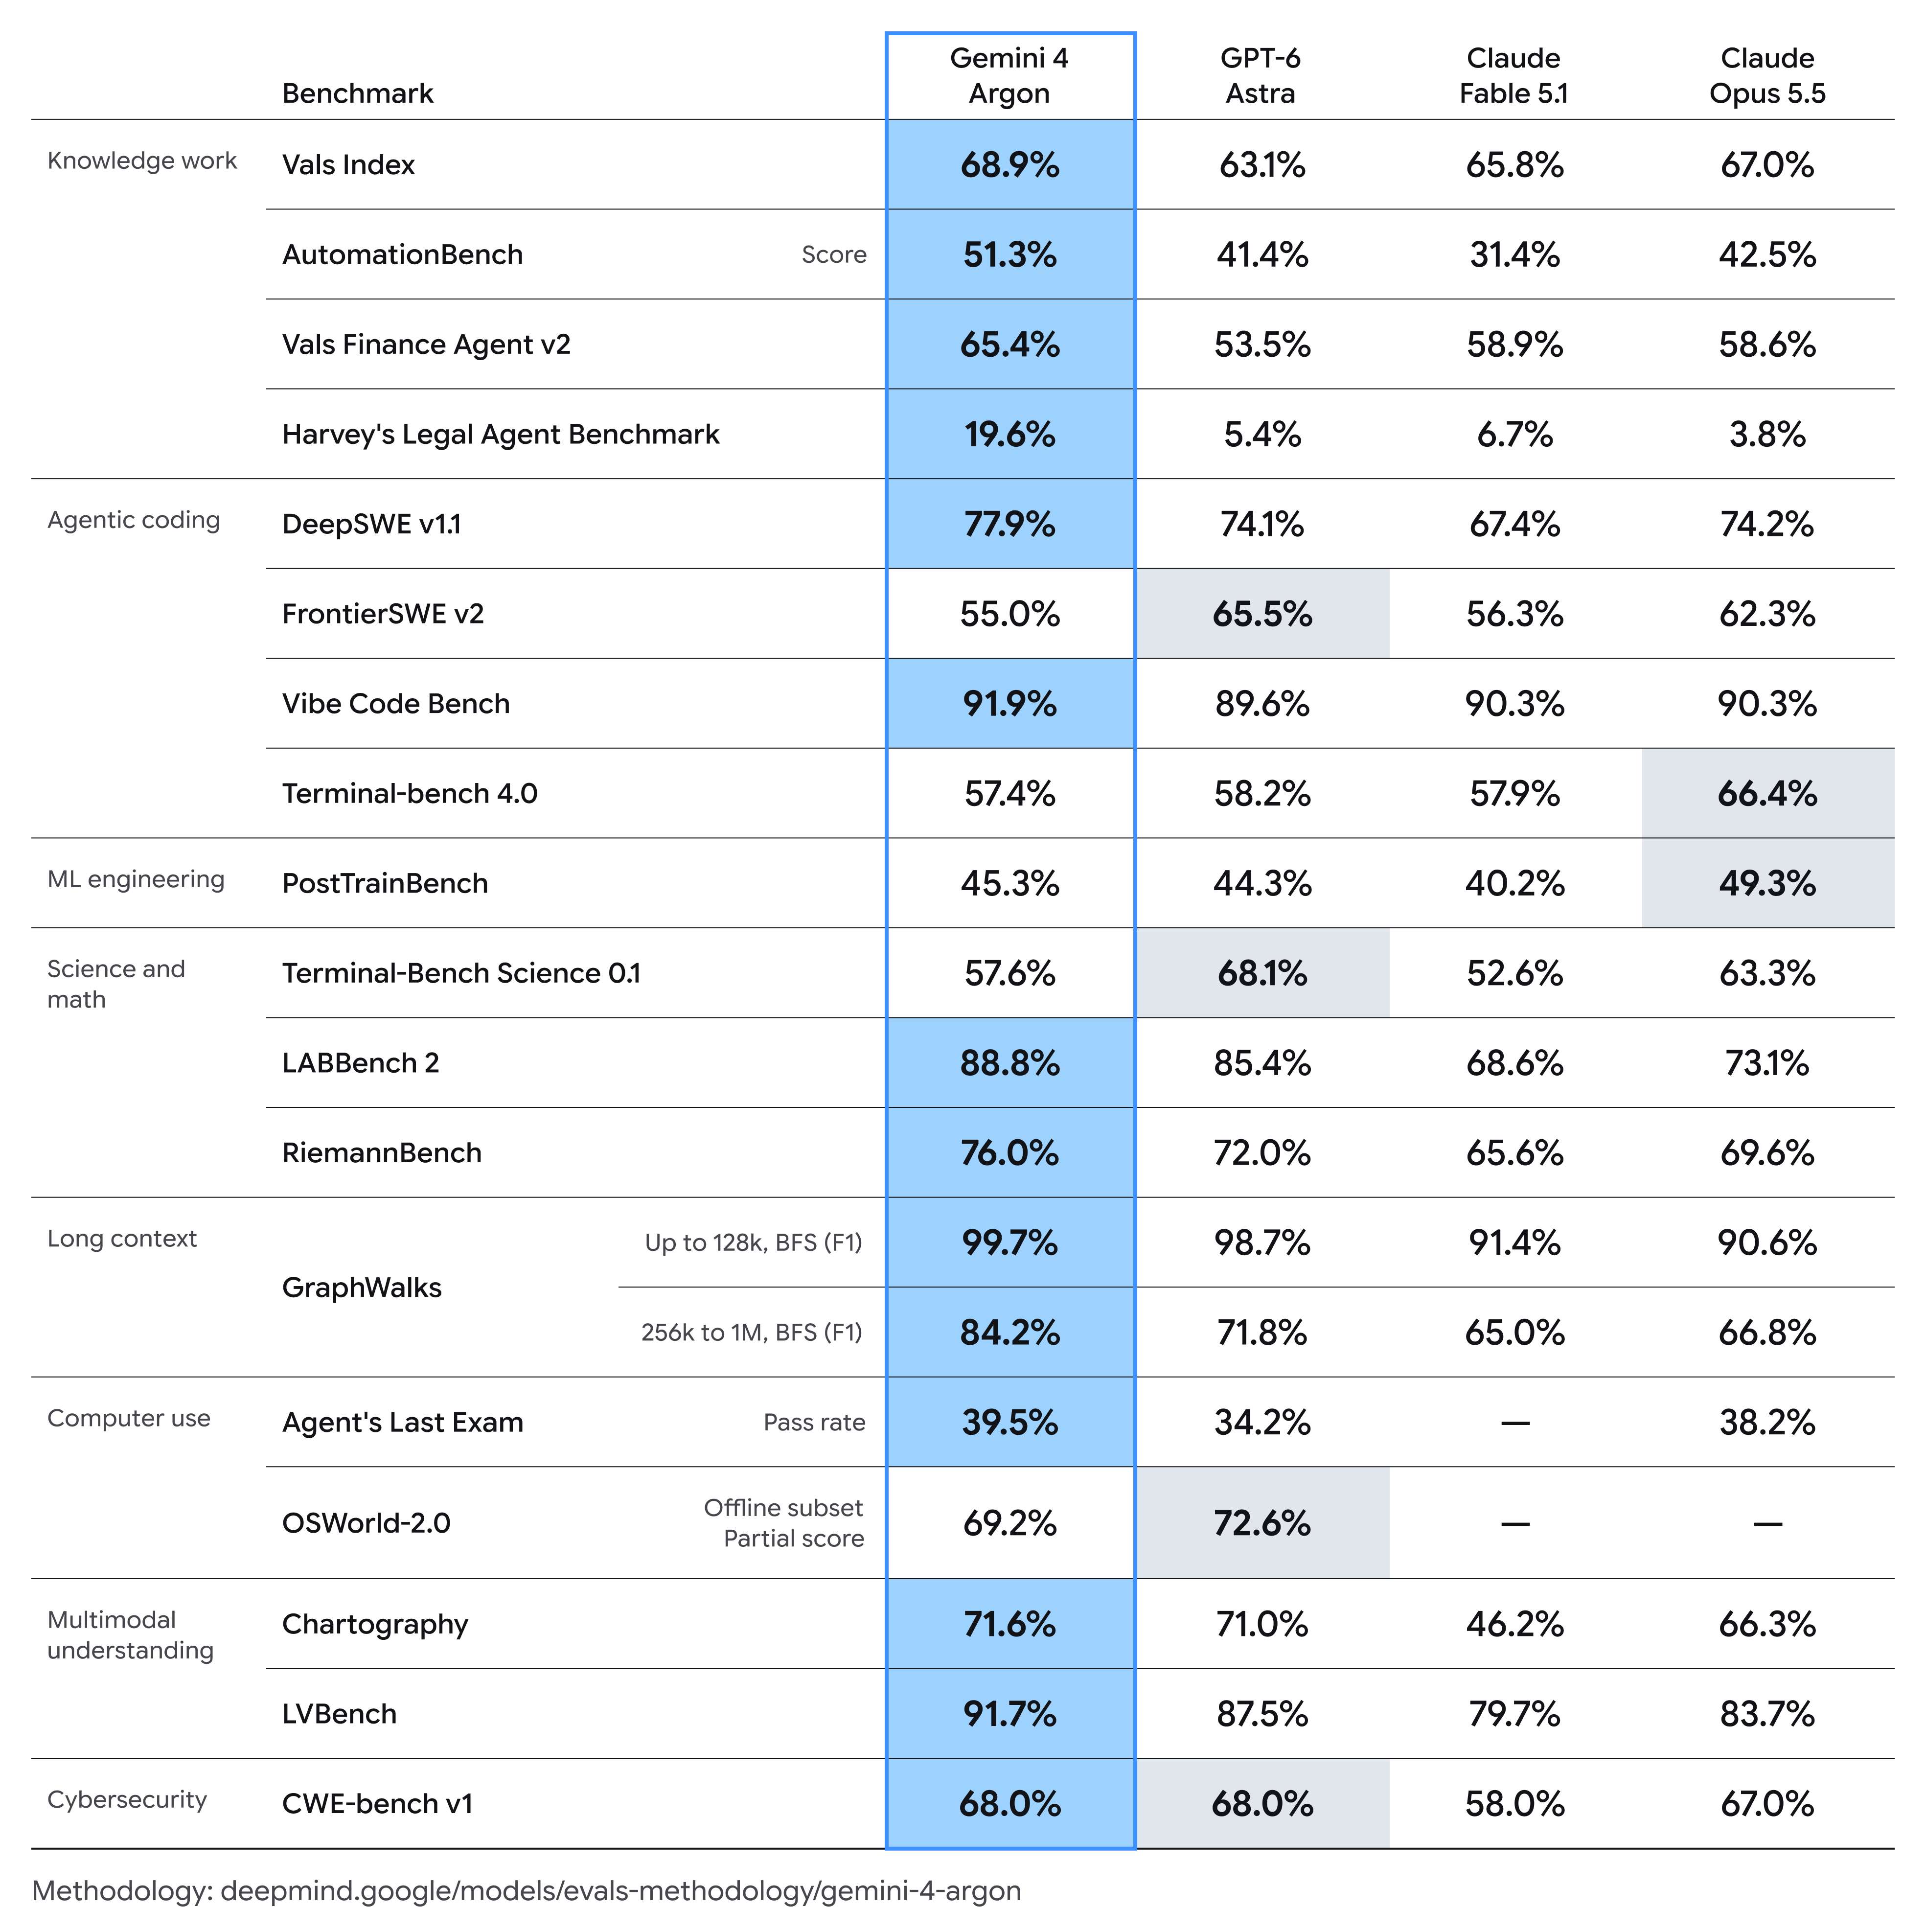
价格方面,这里一段就够了。一个 20,000 token 的 prompt 加 5,000 输出 token 的请求,在介绍期价格为 20,000 x $2/1M + 5,000 x $10/1M = $0.04 + $0.05 = $0.09,在标准 $4/$20 时为 $0.18。Argon 的介绍期输出价格($10)低于 Gemini 3.1 Pro Preview 的 $12,标准价格则与 Claude Opus 5.5 完全一致。Gemini 4 Argon 定价拆解给出了完整场景,包括缓存输入和一次用满的 1M token 响应。
不要把在网上找到的模型 ID 硬编码
搜索 Argon 模型 ID,你会在基准测试网站、聚合站和开源 pull request 上找到各种字符串。它们都是占位符。Vals AI 在自己的模型页面上使用自己的 slug,某个 GitHub pull request “临时”加入了一个 ID,而 OpenRouter 风格的路径会跳到 not-found 页面。Google 没有确认其中任何一个,多家媒体也明确提醒不要硬编码猜测值。
猜错的 ID 会以最没帮助的方式失败:上线当天在生产环境报 404,或者如果你的封装捕获错误过于宽泛,就静默回退。应当把模型名放在配置里。下面每个示例中,模型都来自一个 GEMINI_MODEL 环境变量,默认值为 gemini-3.8-flash,这是一个你今天就能调用的稳定模型。当 Google 公布 Argon 的 ID 时,你只改一个值。
在 Gemini 3.8 Flash 上把代码准备好
Gemini 3.8 Flash(gemini-3.8-flash)运行在 Argon 预期会使用的相同接口、header 和响应结构上,在 2026 年 12 月 31 日之前为每 1M token $0.75/$3.75。你的 key 保存在 GEMINI_API_KEY 中,绝不要把它写进代码。完整设置见我们的 Gemini 3.8 Flash API guide。
第 1 步:发送一个 Interactions API 请求
Interactions API 是 Google 的主要 API,自 2026 年 6 月起全面可用(Generally Available)。把模型和思考档位都放在变量中,因为 Argon 的档位名称尚未公布。
MODEL="${GEMINI_MODEL:-gemini-3.8-flash}"
THINKING="${GEMINI_THINKING:-medium}"

curl -s -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "{
    \"model\": \"${MODEL}\",
    \"input\": \"List the retry rules a REST client should follow for HTTP 429.\",
    \"generation_config\": {\"thinking_level\": \"${THINKING}\"}
  }"
Python SDK 需要 google-genai 2.3.0 或更高版本才能使用 Interactions API:
# pip install "google-genai>=2.3.0"
import os
from google import genai

MODEL = os.environ.get("GEMINI_MODEL", "gemini-3.8-flash")
THINKING = os.environ.get("GEMINI_THINKING", "medium")

client = genai.Client()  # reads GEMINI_API_KEY from the environment
interaction = client.interactions.create(
    model=MODEL,
    input="List the retry rules a REST client should follow for HTTP 429.",
    generation_config={"thinking_level": THINKING},
)
print(interaction.output_text)
在 3.8 Flash 上,有效档位是 low、medium(默认)和 high;minimal 会返回 HTTP 400。我们的 thinking levels guide 解释了其中的取舍。多轮对话时,把上一条响应的 ID 作为 previous_interaction_id 传入,并发送 store: false 以选择不进行服务端存储。
第 2 步:保持 generateContent 路径可用
大多数现有代码调用的是旧版 generateContent 接口,Google 表示它仍然得到完全支持。下面是同样的请求:
curl -s "https://generativelanguage.googleapis.com/v1beta/models/${MODEL}:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "{
    \"contents\": [{\"parts\": [{\"text\": \"List the retry rules a REST client should follow for HTTP 429.\"}]}],
    \"generationConfig\": {\"thinkingConfig\": {\"thinkingLevel\": \"${THINKING}\"}}
  }"
注意思考配置的位置:在 Interactions 上是 generation_config.thinking_level,在这里是 generationConfig.thinkingConfig.thinkingLevel。如果你的客户端同时封装了两者,默认让新模型走 Interactions。工具定义也需要同样的谨慎;见 Gemini 3.8 Flash function calling。
第 3 步:用 models.list 安排上线检查
不要反复刷新 changelog。直接问 API。models 接口会返回可用模型及其 token 上限和支持的方法:
import os, sys, requests

resp = requests.get(
    "https://generativelanguage.googleapis.com/v1beta/models",
    params={"pageSize": 1000},
    headers={"x-goog-api-key": os.environ["GEMINI_API_KEY"]},
    timeout=30,
)
resp.raise_for_status()
hits = [m for m in resp.json().get("models", []) if "argon" in m["name"].lower()]
for m in hits:
    print(m["name"], "in:", m.get("inputTokenLimit"),
          "out:", m.get("outputTokenLimit"), m.get("supportedGenerationMethods"))
sys.exit(1 if hits else 0)  # a failed run is the alert
用 cron 或 CI 计划每小时运行一次,使用你生产应用所用的 key。我们在 2026 年 10 月 1 日用付费项目 key 运行这个调用时,它返回了 61 个模型、没有 nextPageToken,也没有任何名称包含“argon”。匹配到的那天,这条记录会一次性告诉你三件事:真实的模型名、outputTokenLimit 是否为完整的 1M,以及列出了哪些方法。
第 4 步:mock 响应,在拿到访问权限之前就把客户端建好
构建消费 Argon 的代码并不需要 Argon。把第 2 步的请求保存在 Apifox 中,用 GEMINI_API_KEY 和 GEMINI_MODEL 作为环境变量,对 3.8 Flash 发送一次,并把真实响应提取到该接口中作为响应示例。Apifox 默认的 Smart Mock 会根据数据模型生成数据,所以把项目默认的 mock 方式设为“响应示例优先”(项目设置、功能设置、Mock 设置)。这样 mock URL 就会返回你保存的响应,前端、队列 worker 和解析器都能对着它运行,而不消耗 token。
要清楚这个 mock 是什么:当前 Gemini 的响应数据模型,而不是 Argon 专属的,因为 Google 还没有公布。这仍然是正确的选择,因为 Argon 预计会使用同一套 API。要演练一次庞大的 Argon 响应,把示例中的 usageMetadata 改成很大的计数,并确认你的计费和告警代码能正确响应。
第 5 步:对 usageMetadata 和成本上限做断言
每个 generateContent 响应都包含 usageMetadata。在 Apifox 中添加一个后置操作脚本,按 Argon 的标准价格为每个响应计价,让测试在账单之前先失败:
// Apidog post-processor: price this response at Gemini 4 Argon's standard rates
const u = pm.response.json().usageMetadata;
const IN = 4 / 1e6;   // USD per input token after the intro period
const OUT = 20 / 1e6; // USD per output token; thinking bills as output on current Gemini models
const out = (u.candidatesTokenCount || 0) + (u.thoughtsTokenCount || 0);
const cost = u.promptTokenCount * IN + out * OUT;
pm.test("usageMetadata is present", () => pm.expect(u).to.be.an("object"));
pm.test("cost under $0.10 at Argon rates", () => pm.expect(cost).to.be.below(0.10));
上限按请求设置;像这个短 prompt 用 $0.10 就合适。Google 没有说明 Argon 如何对思考 token 计费,所以脚本假设沿用当前 Gemini 的规则。保留同一个保存的请求,现在对 3.8 Flash 运行、以后对 Argon 运行:token 数量和成本的差异就是你的回归对比。
FAQ
Gemini 4 Argon API 可用吗? 尚未公开。Argon 仅面向一组 Fairwind Program 合作伙伴 rollout,他们通过 Gemini Enterprise 使用它。付费 API 客户和 Google AI Ultra 订阅用户是下一批,没有日期。
Gemini 4 Argon 的模型 ID 是什么? Google 没有公布。第三方网站上的字符串是占位符,所以把模型放在环境变量里,并关注 models.list。
Gemini 4 Argon API 会花多少钱? 在时长未说明的介绍期内,每 1M token $2 输入、$10 输出,之后为 $4 和 $20。缓存输入优惠 95%。见 Gemini 4 Argon pricing。
Argon 能配合 generateContent 使用吗? Google 没有说明。它的文档称所有新模型都在 Interactions API 上发布,所以基于 Interactions 构建,把 generateContent 当作回退方案。
Google AI Ultra 能给我 API 访问权限吗? 不能。AI Ultra 是面向消费者的订阅,而不是 API key。Google 表示 API 访问从付费 API 客户开始。
你的下一步
在每个环境中设置 GEMINI_MODEL,安排 models.list 检查,保存带有成本断言的 Interactions 和 generateContent 请求,把请求、mock 和测试都放在同一个工作空间里,等 Google 公布 ID 时改一个变量即可。
HiFox:将 Agent 变成真正的队友
另外,我们也在思考,AI 如何从个人提效走进团队协作。
HiFox 是一个让人和 AI Agent 在同一个工作现场协作的平台:你可以像给同事分派任务一样指派 Agent,在任务看板中跟踪进度、查看结果,让 Agent 成为团队里的队友。
👉 立即体验 HiFox:https://hifox.com
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,
欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
