Gemini API changelog 在 2026 年 9 月 15 日把两款音频到音频模型标成 GA:gemini-3.8-live 和 gemini-3.8-live-extended-thinking。它们走 Live API,面向实时语音应用。同一天的 Google 博客把价格写成音频输入 $0.005/分钟、音频输出 $0.018/分钟;定价页写明这是付费档按 token 折算的约数,输出价含 thinking tokens。
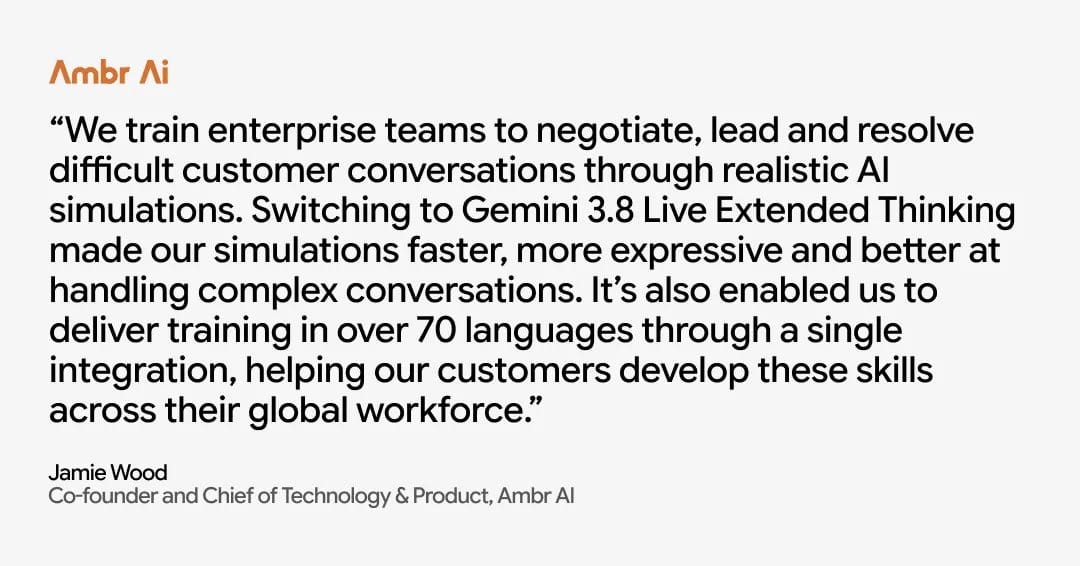
语音 Agent 真正费时间的,不是“能不能说话”,而是工具一慢,对话就得要么傻等、要么不经推理直接答。Live API 的 Thinking 指南把这个限制写死了:普通语音模型要么立刻说、要么在工具跑完前保持沉默。gemini-3.8-live-extended-thinking 把规划和异步工具放到后台,前台继续用口语填空;代价是客户端不能再只看 turnComplete。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
发生了什么
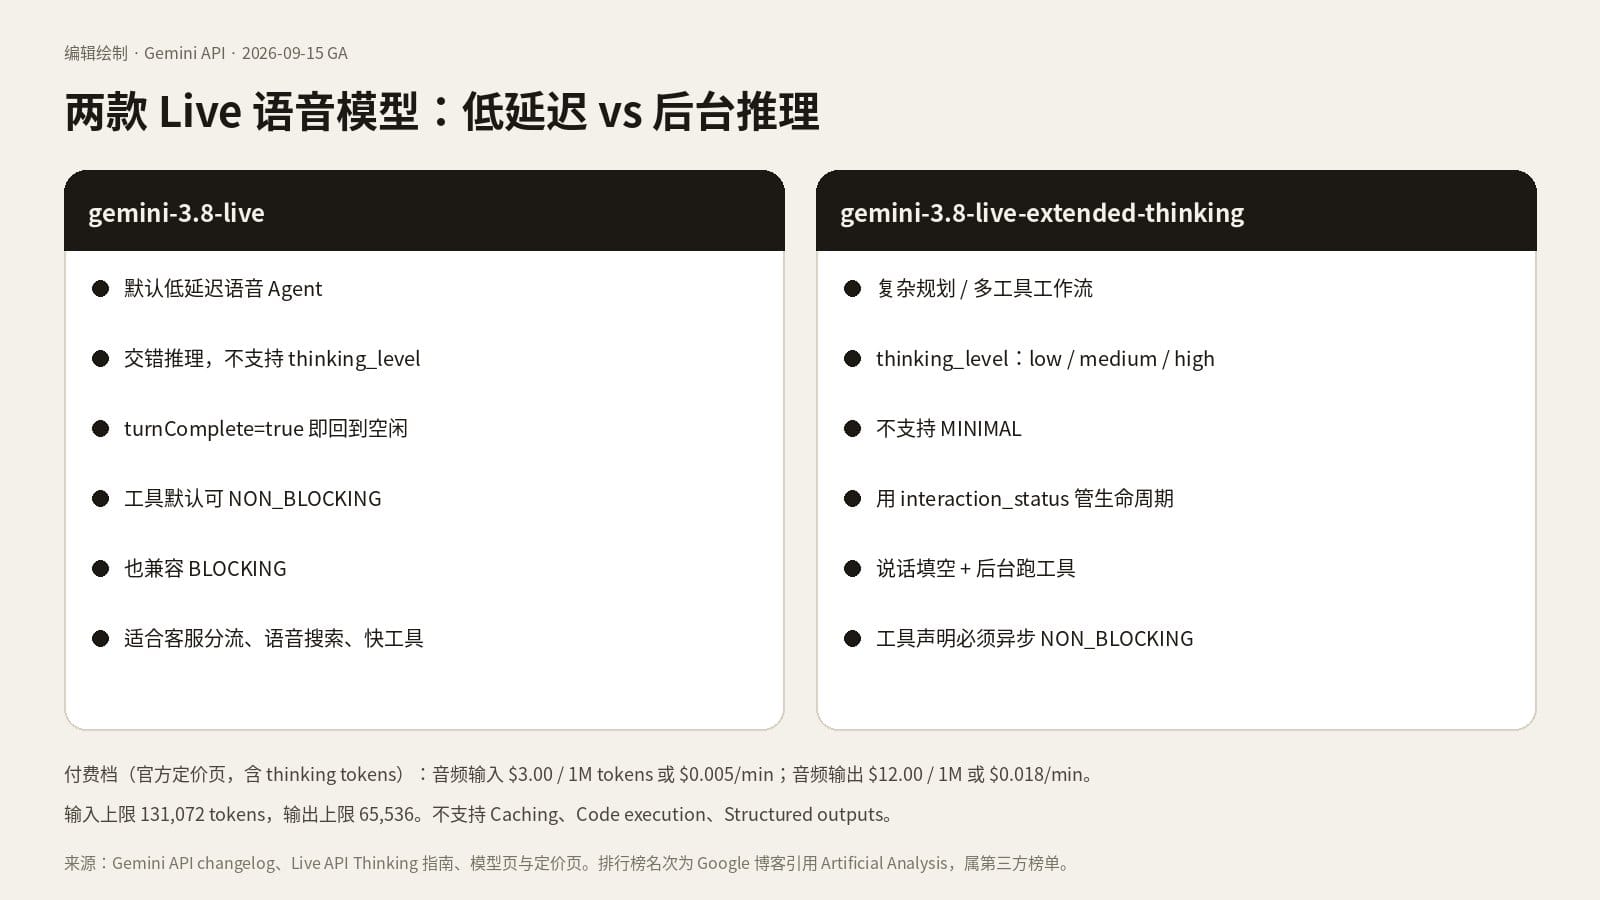
changelog 给两款模型的定位不同。gemini-3.8-live 是大多数低延迟语音 Agent 和实时对话的默认选项,特点是交错推理、默认异步函数调用,以及完整会话周期内的客户端内容更新,并且没有推理等待造成的额外延迟。gemini-3.8-live-extended-thinking 是高推理音频模型,在直播音频过程中支持后台推理,适合需要更强后台推理的场景。
模型页补充了硬限制:gemini-3.8-live 输入上限 131,072 tokens,输出上限 65,536;输入可以是文本、图像、音频、视频,输出是文本和音频。Function calling、Live API、Search grounding、交错 Thinking 可用。Caching、Code execution、File search、Structured outputs、Image generation、URL context、Batch API 不可用。thinking_level 在这款默认 Live 模型上不受支持,从 gemini-3.1-flash-live-preview 迁过来时要从 session setup 里拿掉。
博客还列了异步函数调用、视觉上下文、字母数字精度、97+ 语言,以及把实时音频和结构化数据增量合并。3.8 Live Extended Thinking 另有可配置 thinking,便于在后台做多步推理,同时在主对话里叙述进度。这些能力是产品方描述;博客引用 Artificial Analysis Speech-to-Speech 榜第一,属于第三方榜单,不是 Gemini API 文档里的 SLA。
一条可以真用的工作场景
输入是一条已经用 Live API WebSocket 拉起来的语音会话,用户在说“帮我查这个保单号,再对比两个套餐”。若走 gemini-3.8-live,工具应尽量在毫秒级返回,会话生命周期仍以 turnComplete: true 回到空闲。文档举例是客服分流、语音搜索、读传感器、控智能设备。
若工具要查日志、比价、跑几秒以上的 API,应换成 gemini-3.8-live-extended-thinking。Thinking 指南要求工具声明为异步 NON_BLOCKING;thinking_level 可选 low / medium / high,不支持 MINIMAL。模型可以一边说“我在查航班选项”,一边在后台跑工具。服务器会发 interaction_status: "IN_PROGRESS",整段任务结束才是 IDLE。turnComplete: true 在这里只表示一句口语说完,不表示会话空闲。
交付物是连续的语音,而不是等工具全部返回后再一次性播报。定价页把两款 3.8 Live 和仍在 preview 的 gemini-3.1-flash-live-preview 放在同一张价目上:付费档音频输入 $3.00 / 1M tokens 或 $0.005/分钟,图像/视频 $1.00 / 1M 或 $0.002/分钟,文本输入 $0.75 / 1M;音频输出 $12.00 / 1M 或 $0.018/分钟,文本输出 $4.50 / 1M,且输出价包含 thinking tokens。免费档该项为 Free of charge。Search grounding 在 Gemini 3.x 共享每月 5,000 次免费搜索,超出后每 1,000 次 $14。
反馈要改客户端状态机。继续用 turnComplete 关麦、关“正在输入”,Extended Thinking 会话会在模型还在后台推理时被你当成结束。指南写明:只有看到 IDLE 才能回到空闲 UI。
为什么这会改工作流
实时语音以前常被拆成“ASR → 文本模型 → TTS”。博客把 3.8 Live 写成对级联架构的更精简替代:同一条 Live API 会话里完成听、想、说和工具。工作流变化发生在会话中段——工具不必再把对话卡死。
代价是集成点变多。迁到默认 3.8 Live,主要是换模型字符串、去掉 thinking_level。迁到 Extended Thinking,要同时改三处:状态看 interaction_status、工具改异步、接受中间口语填空。只换模型 ID、不改客户端,会出现“模型还在干活,UI 已经亮起麦克风”的竞态。
客户端内容更新是另一条容易漏的迁移项。模型页写 send_client_content 在整个会话生命周期内都可用,也就是用户开口之后仍能把屏幕、表单或工具结果以客户端内容推进去,而不必重开一条 Live 连接。这对“边看边说”的客服或操作手册场景有用,但把大段视频帧当持续输入时,要按定价页的图像/视频档计费,不能只按音频分钟估算。
Search grounding 虽然在 3.8 Live 上可用,计费却和文本 Gemini 3.x 共用每月 5,000 次免费搜索配额。语音会话里一次用户问题可能触发多次 Google 查询,文档写明按实际查询次数计。人接管点是:语音产品如果默认打开 grounding,要把搜索次数单独做配额告警,不要等音频账单出来才发现搜索项先爆。
会话管理仍要按 Live API 的 ephemeral token 和连接时长来设计。changelog 只宣布模型 GA,没有宣布把 Live 会话变成无限长后台任务。Extended Thinking 可以在一次用户请求里多次开口,但底层仍是同一条实时连接;连接断开后,后台推理不会自动在新连接里续上。需要跨电话、跨页面接着办的工单,还是要把工具结果落到你们自己的后端,而不是指望 Live 会话当工单库。
限制与人接管点
不要把博客里的榜单名次写成产品保证。也不要把 $0.005 / $0.018 理解成与 token 无关的固定分钟价:定价页并列了 /1M tokens 和 /min,输出含 thinking tokens,Extended Thinking 把 thinking_level 拉高时,账单会跟着输出走。
能力缺项要当硬边界:没有 Caching、没有 Code execution、没有 Structured outputs。需要可靠 JSON 或在语音会话里跑代码沙箱,得另接后端,不能指望 Live 模型顺便做。异步函数调用在 3.8 Live 上是默认 NON_BLOCKING,仍可用 BLOCKING 兼容旧工具;Extended Thinking 则要求异步声明,硬塞同步工具会直接不符合指南。
人接管点在模型选择,不在事后微调提示词。低延迟、单次回复、快工具,用 gemini-3.8-live。多步诊断、并行查数、要靠说话掩盖工具延迟,才用 Extended Thinking。博客提到的 Gemini 3.5 Transcribe 是上个月已 GA 的语音转写,不是这次两款 Live 模型的一部分。
如何试用
在 ai.studio/live 先听两款模型的差异,再把 Live API 示例里的模型字符串换成 gemini-3.8-live。若现网是 gemini-3.1-flash-live-preview,先按模型页去掉 thinking_config。要试 Extended Thinking,把工具改成 NON_BLOCKING,并在客户端处理 IN_PROGRESS / IDLE。媒体传输也可以走博客列出的 Agora、LiveKit、Pipecat、Vercel、LangChain 等 Live API 集成方,但会话语义仍以 Gemini 文档为准。
信息来源
- Gemini API changelog(2026-09-15)
- Gemini 3.8 Live 模型页
- Thinking in the Live API
- Gemini API 定价(3.8 Live)
- Google 博客:Build real-time voice applications with Gemini 3.8 Live and 3.5 Transcribe(2026-09-15)
开发必备:API 全流程管理神器 Apifox
介绍完上文的内容,我想额外介绍一个对开发者同样重要的效率工具 —— Apifox。作为一个集 API 文档、调试、设计、测试、Mock、自动化测试于一体的工具,Apifox 是目前提升研发效率的首选。
如果你正在开发项目,不妨试试其极其友好的界面设计,它完全兼容 Postman 和 Swagger 数据格式,导入数据非常方便,,即使是新手也能很快上手,点击这里即可注册使用。
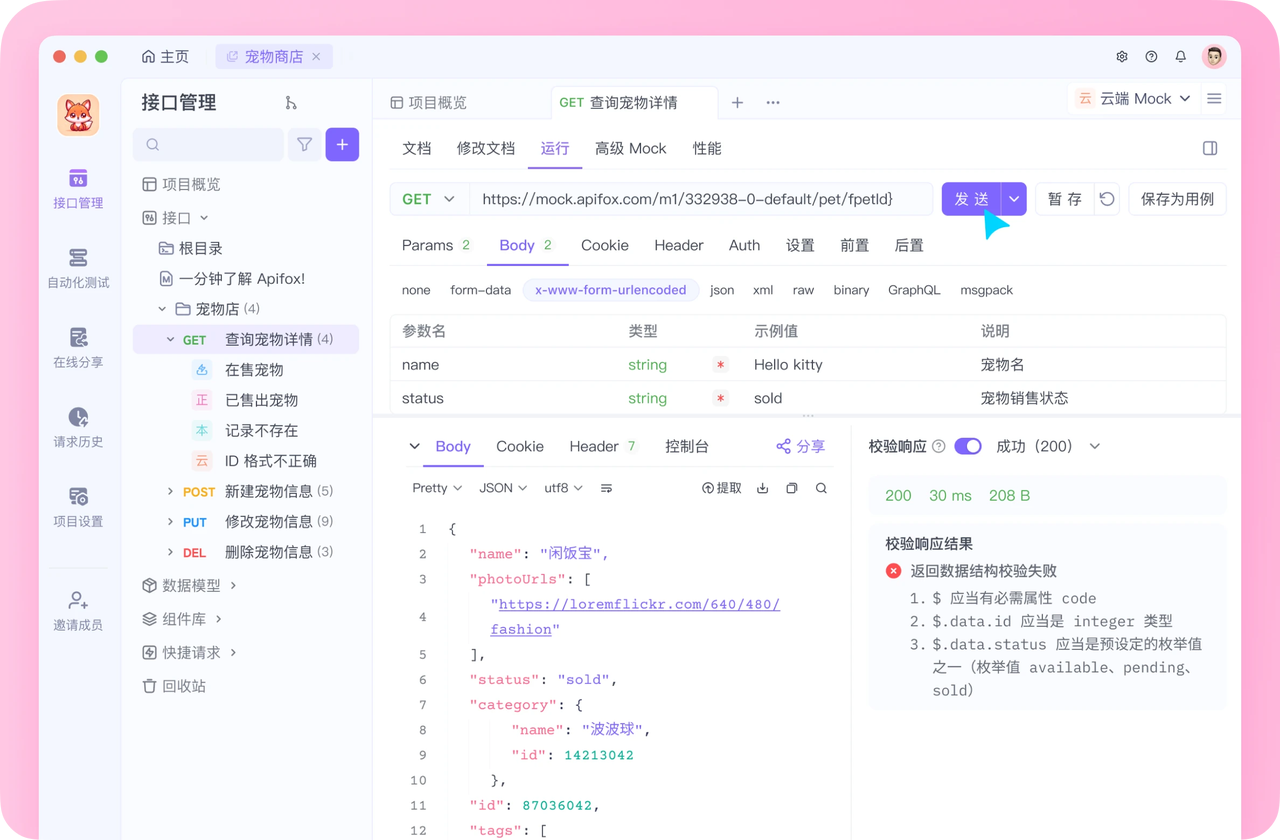
值得一提的是,除了个人和常规团队使用,针对有高安全合规要求、或需要在内网环境协作的企业,Apifox 还提供了深度定制的私有化部署方案。
获取专属报价与部署方案
 详细的私有化部署系统架构与安全白皮书
 针对您公司规模的专属报价单
 免费的 1v1 专属产品演示 (Demo) 机会