DeepSeek 只给了 deepseek-v4-pro 用户四天时间。2026 年 9 月 14 日 04:00 UTC(北京时间 12:00)起,所有指定 deepseek-v4-pro 的请求都会被路由到 DeepSeek-V4.1-Flash,并按 V4.1-Flash 的价格计费。不会报错,也没有任何提示。你的账单变少了,但回答你 prompt 的已经换成了另一个模型。
最后一点才是需要提前规划的。发布说明把这次变更描述为一次升级,从 DeepSeek 自己公布的数据看确实如此。但“被静默改路由”和“已经过测试”是两回事。如果你的产品依赖某种特定的 tool call 结构,或者依赖你针对 V4-Pro 调优出来的延迟预算,那你应该在周日之前、而不是之后,知道到底有哪些变化。
本文涵盖 DeepSeek 公布了什么、如果你什么都不做会发生什么、迁移检查清单,以及如何在 Apifox 中搭建 Pro 与 Flash 的回归测试集,让这次切换平稳无事。关于模型本身,请先阅读 DeepSeek-V4.1-Flash 是什么。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。

TL;DR
- 切换时间:2026 年 9 月 14 日 04:00 UTC。从那一刻起,
deepseek-v4-pro的请求由 V4.1-Flash 处理。 - 你的调用不会失败,也不会再按 Pro 的价格付费。高峰时段 cache miss 输入从每 1M tokens $1.32 降到 $0.30(降低 77%);输出从 $3.96 降到 $1.20(降低 70%)。
- 自行把 model id 改成
deepseek-flash,然后重新测试 function calling、结构化输出、流式输出和 reasoning effort。 - DeepSeek 表示 V4.1-Flash 在所有列出的 benchmark 上都优于 V4-Pro。这些是厂商自己的数据,请跑你自己的评测。
DeepSeek 在 9 月 10 日公布了什么
9 月 10 日的更新日志包含两件事:V4.1-Flash 在 API 上正式 GA,以及 V4-Pro 将在四天后停用。
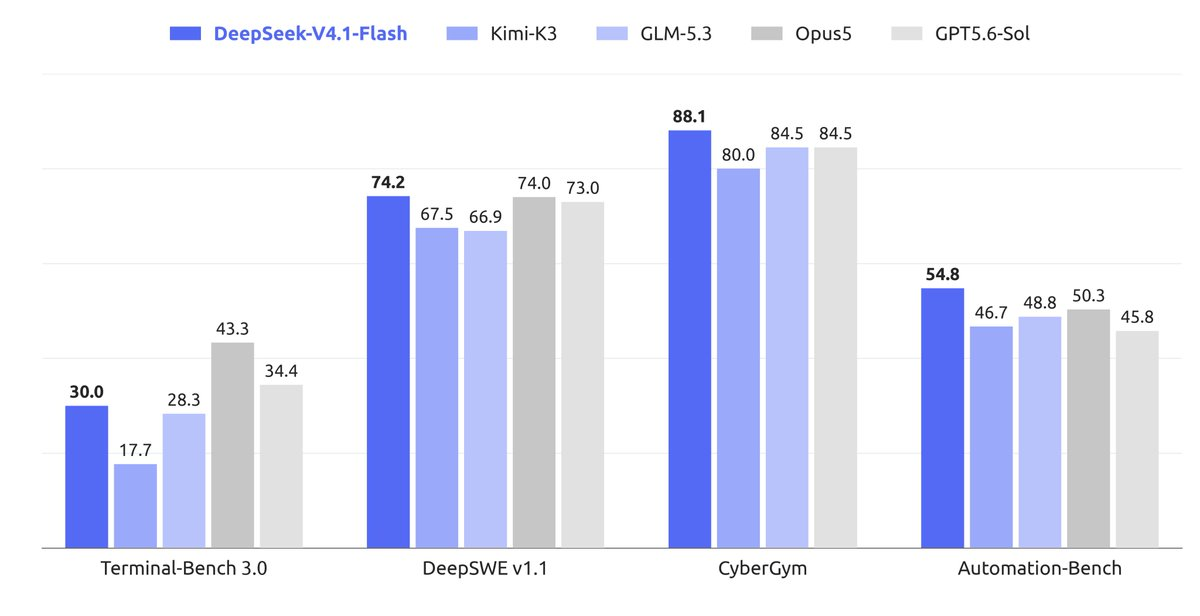
关于 V4-Pro,措辞很直接。DeepSeek 称 V4.1-Flash“在性能、成本、速度和总耗时上已全面超越 V4 Pro”,并援引“多方测试”。从 9 月 14 日 04:00 UTC 起,发往 deepseek-v4-pro 的请求由 V4.1-Flash 提供服务,并按 V4.1-Flash 计费。不存在让 Pro 以旧名称继续运行的宽限期。
这次命名清理不止涉及 Pro:
| 模型名称 | 9 月 10 日之后的状态 |
|---|---|
deepseek-flash |
V4.1-Flash 的新规范 id |
deepseek-v4-flash |
仍可接受,由 V4.1-Flash 提供服务 |
deepseek-v4-flash-vision-exp |
仍可接受,由 V4.1-Flash 提供服务 |
deepseek-v4-pro |
在 9 月 14 日 04:00 UTC 之前由 V4-Pro 提供服务,之后改路由到 V4.1-Flash |
V4-Flash 和 V4-Flash-Vision-Exp 作为模型已停用,只有名字作为别名继续存在。base URL 不变:OpenAI 兼容格式用 https://api.deepseek.com,Anthropic 兼容格式用 https://api.deepseek.com/anthropic。V4.1-Flash API 的用法指南详细介绍了新的 model id、reasoning 控制和图片输入。
如果什么都不做会发生什么
简短版:你的集成继续可用,而且更便宜。详细版:有五个变化会在你脚下发生。
换了一个模型来回答。V4.1-Flash 是一个 552B 参数的 MoE,采用新的 Causal Encoder-Decoder 结构:40 层,20 层 encoder 加 20 层 decoder,prefill 阶段激活 8B 参数,decode 阶段激活 16B。你的 prompt 现在面对的是不同的激活参数预算和不同的注意力设计(Compressed Sparse Attention 2)。可以预期措辞不同、默认详细程度不同,有时在边界情况的 tool call 上判断也会不同。
输出上限相同,推荐设置不同。两个模型都标称 1M 上下文和 384K 最大输出。V4.1-Flash 的 model card 推荐 temperature 1.0、top_p 0.95 或 1.0,以及 256K 或更大的 max tokens。如果你之前在 V4-Pro 上设置了很小的 max_tokens 来控制成本,请检查 reasoning 输出现在是否会在最终答案到来之前就被截断。
Reasoning effort 使用不同的量纲。DeepSeek 把 V4.1-Flash 的 reasoning effort 描述为 1 到 100 的“连续可调”标度。V4-Flash 接受 reasoning_effort 加上 extra_body={"thinking": {"type": "enabled"}}。这个 1 到 100 的标度如何映射到 API parameter,需要对照当前文档 [VERIFY];不要假设像 "high" 这样的命名档位仍代表它在 Pro 上的深度。
价格向有利方向变化,但有高峰时段。高峰时段为周一至周五 01:00–04:00 和 06:00–10:00 UTC。非高峰价格是高峰的一半。被改路由的 Pro 流量在两个时段都按 Flash 价格计费。
并发余量大幅提升。V4-Pro 的限制是 500 个并发请求,Flash 是 2,500 个。被改路由的流量继承更高的限制,所以请重新审视任何针对 500 调优的客户端退避策略。
迁移检查清单
按顺序执行。它们合起来能把一次静默改路由变成一次有意的发布。
- 重命名 model id。在代码库和配置中搜索
deepseek-v4-pro,替换为deepseek-flash。即使别名仍然可以解析,也要这样做:显式的 id 让日后排查故障更容易读懂。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",  # was "deepseek-v4-pro"
    messages=[
        {"role": "system", "content": "You triage support tickets. Return a JSON object with priority, team, and summary."},
        {"role": "user", "content": "Customer reports checkout returns 502 after applying a discount code."},
    ],
    response_format={"type": "json_object"},
)
print(response.choices[0].message.content)
- 检查 reasoning effort 设置。列出所有设置
reasoning_effort或 thinking 开关的地方。逐接口决定你要的是深度还是延迟,然后针对新的标度逐个测试,而不是直接把旧值搬过去。 - 重新运行 function calling 和结构化输出测试。tool call 参数的格式是换模型时最容易出问题的地方。如果你在 V4-Pro 上搭建 function calling 时写过测试,现在就针对
deepseek-flash跑一遍。如果没写过,下面的 Apifox 工作流可以给你一套。 - 检查流式解析器。在 thinking 模式下,V4.1-Flash 会把 reasoning delta 和 answer delta 分开流式返回。确认你的 SSE 处理逻辑没有把它们拼接在一起,并确认你的“首 token”计时器测的确实是你以为的东西。
- 重新确立延迟和成本的基线。本周记录 V4-Pro 的 p50、p95 延迟以及每次请求的 token 数,然后对
deepseek-flash记录同样的数据。当有人问起周一仪表盘为什么变了时,你会同时需要这两组数字。 - 更新仪表盘和预算。按高峰输出 $3.96 校准的成本告警,在你只付 $1.20 之后就不会再触发,而一个永不触发的预算等于没人看。把阈值重置为价格页上的费率,并修正任何按旧 id 过滤的按模型拆分。
如果你调用的是 Anthropic 兼容格式或 Responses API 格式而不是 chat completions,同样适用这些步骤;V4-Pro API 格式对比展示了每种请求的样子,方便你对应字段。
V4-Pro 与 V4.1-Flash 速览
benchmark 数据来自 DeepSeek 自己公布,出处是 V4.1-Flash model card。价格为每 1M tokens 的美元价,2026 年 9 月 10 日起生效。
| deepseek-v4-pro | deepseek-flash (V4.1) | |
|---|---|---|
| 激活参数 | V4.1 的 model card 未重申 | 8B prefill / 16B decode |
| HumanEval | 76.8 | 79.4 |
| GSM8K | 92.6 | 93.0 |
| DeepSWE v1.1 | 62.7 | 74.2 |
| Terminal-Bench 2.1 | 87.9 | 90.6 |
| 输入,cache hit(非高峰 / 高峰) | $0.022 / $0.044 | $0.003 / $0.006 |
| 输入,cache miss(非高峰 / 高峰) | $0.66 / $1.32 | $0.15 / $0.30 |
| 输出(非高峰 / 高峰) | $1.98 / $3.96 | $0.60 / $1.20 |
| 上下文 / 最大输出 | 1M / 384K | 1M / 384K |
| 并发限制 | 500 | 2,500 |
差距最大的是 DeepSWE,提升 11.5 分;最小的是 GSM8K,提升 0.4 分。如果你的负载接近小学算术,可以预期两者持平;如果接近多文件代码编辑,按 DeepSeek 的数据你会获得提升。包含 V4-Flash 的三方对比见 V4.1-Flash vs V4-Pro vs V4-Flash。
风险:厂商 benchmark 衡量的是厂商的任务
表格中的每一个数字都来自 DeepSeek。“多方测试”是 DeepSeek 的说法,而发布说明里没有点名这些方是谁。这并不说明数字是错的,只是说明它们是在 benchmark 套件上测出来的,而不是在你的 prompt、你的 tool schema 或你用户那些杂乱的输入上测出来的。
一个模型可以在 Terminal-Bench 上得分更高,但同时也改变它格式化 tool call 参数的方式,而你的解析器正依赖那种格式。如果模型写出的内容多了一倍,那么输出 token 更便宜也帮不上忙。唯一的办法是在两个模型都还在的时候,把你的真实流量同时跑过它们。你只有到 9 月 14 日为止。
在切换前用 Apifox 搭建回归测试集
下面是一个 Apifox 工作流,可以给你可重复的 Pro 与 Flash 对比,并把运行交给 CI。
- 导入现有的 V4-Pro 请求。导入一份 OpenAI 兼容的 OpenAPI 规范,或者直接粘贴你在生产环境使用的 curl 命令。把
DEEPSEEK_API_KEY放进环境,并在 Authorization header 中以Bearer {{DEEPSEEK_API_KEY}}引用它。再加一个变量{{MODEL_ID}},设为deepseek-v4-pro。 - 为每个请求复制一份改用
deepseek-flash的版本。在第二个环境中把{{MODEL_ID}}设为deepseek-flash,或者在一对请求里把两个 id 写死。相同的 prompt、相同的 tools 数组、相同的max_tokens。唯一的差别应该是模型。 - 对 JSON 结构和 tool call 结构添加断言。对结构化输出,断言
choices[0].message.content能被解析为 JSON 且包含你期望的 key。对 function calling,断言choices[0].message.tool_calls[0].function.name等于你期望的 tool,且arguments能被解析。这些检查能捕捉静默的格式漂移。 - 把两者作为一个测试场景运行。把 Pro 和 Flash 的请求串成单个场景,这样每次运行只产出一份报告。加入一个带
stream: true的流式请求;Apifox 会逐条渲染 SSE 事件,这样你能看到 reasoning delta 和 answer delta 是否按你解析器期望的方式到达。 - 对比结果。比较报告的两半:断言通过率、响应时间和
usage.completion_tokens。一个通过所有断言但多输出 40% token 的模型会改变你的成本计算,而你会在账单之前先看到这一点。 - 用
apidog-cli在 CI 中定时运行。从你的流水线中每天运行该场景,持续到 9 月 14 日,之后继续保留。Pro 停用后,Pro 那一半也返回 Flash 的响应,差异会归零:这就确认了切换已经发生,而你的断言依然成立。
常见问题
9 月 14 日我的 V4-Pro 调用会失败吗?不会。指定 deepseek-v4-pro 的请求会被改路由到 V4.1-Flash。你会收到 200 响应和一个 V4.1-Flash 的回答。失败模式是行为上的,而不是错误码。
切换后还会按 V4-Pro 的价格计费吗?不会。被改路由的请求按 V4.1-Flash 的费率计费:高峰时段每 1M cache miss 输入 token 为 $0.30 而非 $1.32,每 1M 输出 token 为 $1.20 而非 $3.96。
我应该把 id 改成 deepseek-flash,还是保留 deepseek-v4-pro?改名。别名能用,但显式的 id 能让你的日志、仪表盘和成本报告如实反映真正被调用的东西。
V4-Pro-0813 的那套配置还适用吗?V4-Pro-0813 API 指南中的 key、base URL 和请求结构都原样沿用。变化的是它们背后的模型以及 reasoning-effort 控制,所以要重新测试,而不是想当然。
V4.1-Flash 有哪方面不如 V4-Pro 吗?DeepSeek 公布的 benchmark 显示每一项列出的任务都有提升。发布时没有可用的第三方独立结果。把“没有任何方面更差”当作一个待验证的说法。
四天足够了
这次迁移就是改一个字符串加跑一次测试。改字符串只要一分钟。跑测试能告诉你,下周你要付费的那个模型是否还像你当初据以设计的那一个。搭好测试集,趁 deepseek-v4-pro 仍然解析到 Pro 的时候跑一遍,然后看差异。如果差异干净,你就免费拿到便宜 70% 的账单和五倍的并发。如果不干净,你是在自己的时间表上发现的,而不是 DeepSeek 的。
HiFox :将 Agent 变成真正的队友
另外,我们也在思考,AI 如何从个人提效走进团队协作。
HiFox 是一个让人和 AI Agent 在同一个工作现场协作的平台:你可以像给同事分派任务一样指派 Agent,在任务看板中跟踪进度、查看结果,让 Agent 成为团队里的队友。
👉 立即体验 Hifox:https://hifox.com
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。