DeepSeek-V4.1-Flash 于 2026 年 9 月 10 日在 API 上正式 GA,随发布说明一同到来的还有一次降价。缓存命中的输入在低谷时段每百万 token 只要 $0.003,缓存未命中输入 $0.15,输出 $0.60。四天之后,也就是 9 月 14 日,DeepSeek 开始把所有 deepseek-v4-pro 请求路由到 V4.1-Flash,并按 Flash 的价格计费。只要你在 DeepSeek API 上跑了任何东西,这周账单就会变化——无论你有没有动过代码。
这篇文章讲的是价格这一半:完整的 USD 与 CNY 价格表、相对 V4-Flash 和 V4-Pro 的百分比变化、高峰时段落在你所在时区的具体时间,以及两个把算术过程写出来的缓存命中示例。至于模型本身,可以先从 DeepSeek-V4.1-Flash 是什么看起。
先说明一个前提。本系列中所有 benchmark 数字都是 DeepSeek 在 model card 中自行报告的数据。价格来自 pricing 页面,核验时间为 9 月 10 日。最后一节会介绍如何用 Apifox 测量你自己的实际开销:读取每次响应里的 usage 块,而不是相信一个估算值。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。

TL;DR
- 在低谷时段,
deepseek-flash的价格为每百万缓存命中输入 token $0.003、每百万缓存未命中输入 token $0.15、每百万输出 token $0.60。高峰时段正好翻倍。 - 与 8 月 21 日的 V4-Flash 相比:缓存命中输入下降 57%,缓存未命中输入下降 32%,输出下降 9%。
- 与高峰时段的 V4-Pro 相比:从 9 月 14 日起,被重新路由的负载在缓存未命中输入上少付 77%,在输出上少付 70%。
- 高峰时段为周一至周五的 01:00 至 04:00 和 06:00 至 10:00 UTC。周末全部按低谷计价。
完整价格表
以下所有数字均为每百万 token 的价格,自 2026 年 9 月 10 日 04:00 UTC 起生效。
| deepseek-flash 低谷 | deepseek-flash 高峰 | deepseek-v4-pro 低谷 | deepseek-v4-pro 高峰 | |
|---|---|---|---|---|
| 输入,缓存命中 | $0.003 | $0.006 | $0.022 | $0.044 |
| 输入,缓存未命中 | $0.15 | $0.30 | $0.66 | $1.32 |
| 输出 | $0.60 | $1.20 | $1.98 | $3.96 |
| 并发 | 2,500 | 2,500 | 500 | 500 |
deepseek-v4-pro 那两列还有四天的意义。从 9 月 14 日 04:00 UTC(北京时间 12:00)起,发往该模型名的请求将由 V4.1-Flash 处理,并按前两列计费。V4-Pro 下线与迁移指南里介绍了在那之前需要测试的内容。
如果你的账户以人民币结算,zh-cn pricing 页面上 deepseek-flash 的价格如下:
| 低谷(CNY) | 高峰(CNY) | |
|---|---|---|
| 输入,缓存命中 | ¥0.02 | ¥0.04 |
| 输入,缓存未命中 | ¥1.00 | ¥2.00 |
| 输出 | ¥4.00 | ¥8.00 |
CNY 的每一行都是 USD 对应行乘以约 6.67。表格没有提到的两个细节:上下文缓存是自动的,不需要设置任何开关;模型 id 现在是 deepseek-flash。旧名称 deepseek-v4-flash 和 deepseek-v4-flash-vision-exp 仍然可以解析,但会按这些价格落到 V4.1-Flash 上。
相对 V4-Flash 和 V4-Pro 有哪些变化
2026 年 8 月 21 日,deepseek-v4-flash 在低谷时段计费为 $0.007 / $0.22 / $0.66(缓存命中 / 缓存未命中 / 输出),高峰时段为 $0.014 / $0.44 / $1.32。changelog 中称本次发布让价格“相应下调”。以下是“相应”的具体含义,由这两份价格表计算得出:
| 计费项 | V4-Flash(8 月 21 日) | V4.1-Flash(9 月 10 日) | 降幅 |
|---|---|---|---|
| 缓存命中,低谷 | $0.007 | $0.003 | 57% |
| 缓存未命中,低谷 | $0.22 | $0.15 | 32% |
| 输出,低谷 | $0.66 | $0.60 | 9% |
高峰时段的各行对应的百分比完全相同,因为两份价格表在高峰都会翻倍。这个模式是有意为之的:降幅最大的是缓存命中,最小的是输出。DeepSeek 的定价面向的是每一轮都会重读长前缀的 agent loop,而 V4.1 中的 FP4 KV cache(每个 token 890 字节,约为 V4-Flash 占用量的四分之一)正是让 $0.003 的命中价格在他们那边可持续的原因。
对 V4-Pro 用户来说数字更大,因为重新路由后按 Flash 的价格计费:
- 高峰时段的缓存未命中输入:$1.32 变为 $0.30,下降 77%。
- 高峰时段的输出:$3.96 变为 $1.20,下降 70%。
- 高峰时段的缓存命中输入:$0.044 变为 $0.006,下降 86%。
DeepSeek 称 V4.1-Flash“在性能、成本、速度和总耗时上全面超越了 V4 Pro”,这个说法值得在 14 号之前用你自己的 prompt 验证。如果想了解这个系列更长时间跨度的定价变化,包括 DeepSeek 上调 API 价格的那段时间,DeepSeek V4 API 定价全解析里有完整的历史。
你所在时区的高峰时段
高峰只适用于周一至周五,分为两段:01:00 至 04:00 UTC 和 06:00 至 10:00 UTC,即北京时间 9:00 至 12:00 和 14:00 至 18:00。每个工作日有 7 个小时处于高峰,每周 35 小时,也就是说高峰约占 168 小时一周的 21%。其余时间,包括周六和周日全天,都按低谷价格计费。
| 时段 | UTC | 北京(UTC+8) | 美西(PDT,UTC-7) | 中欧(CEST,UTC+2) |
|---|---|---|---|---|
| 高峰 1 | 01:00 至 04:00 | 09:00 至 12:00 | 18:00 至 21:00(前一天傍晚) | 03:00 至 06:00 |
| 高峰 2 | 06:00 至 10:00 | 14:00 至 18:00 | 23:00 至 03:00(跨夜) | 08:00 至 12:00 |
美西和中欧两列使用的是夏令时。夏令时结束后(欧盟 10 月 25 日,美国 11 月 1 日),这两列都要往前挪一小时。UTC 的边界永远不变。
美西的一个工作日完全不会碰到高峰时段。中欧的上午落在高峰 2 之内,而欧洲本地时间 03:00 的夜间批处理要付双倍价格;把它挪到 23:00 CEST(21:00 UTC)就能回到半价。
缓存命中的算术,推演两次
一次命中成本是一次未命中的 1/50($0.003 对 $0.15),因此重复前缀与新鲜 token 的比例,比 token 的绝对数量更能决定你的输入成本。如果你还不了解 prefix caching,prompt caching 入门那篇解释了什么算可缓存前缀:请求开头完全相同的字节。
示例 1:一个带 20K token system prompt 的 agent loop,高峰时段调用 1,000 次。
一个客服分诊 agent 携带 20,000 token 的 system prompt(策略、tool schema、few-shot 示例),每次调用读取 2,000 个新鲜的工单文本 token,并写出 1,000 个输出 token。在 1,000 次调用中:
- 输入总量为 1,000 × 22,000 = 22M token。输出总量为 1M token。
- 第一次调用对全部 22,000 个 token 都是未命中。之后每次调用都在 20,000 token 的前缀上命中,在自己的 2,000 个新鲜 token 上未命中。
- 命中 token:999 × 20,000 = 19.98M。按每百万 $0.006 计算:19.98 × 0.006 = $0.12。
- 未命中 token:22,000 + 999 × 2,000 = 2.02M。按每百万 $0.30 计算:2.02 × 0.30 = $0.61。
- 输出:1M × $1.20 = $1.20。
- 合计:$0.12 + $0.61 + $1.20 = $1.93。
如果完全不做缓存,仅输入就是 22 × $0.30 = $6.60,整个任务要花 $7.80。缓存去掉了 75% 的账单。在低谷时段运行同样的 loop,每一行都会减半:$0.06 + $0.30 + $0.60 = $0.96。
同样 1,000 次调用如果走高峰时段的 V4-Pro(命中 $0.88、未命中 $2.67、输出 $3.96),合计 $7.51。当重新路由生效时,Pro 客户应该把 $1.93 和这个数字放在一起看。
示例 2:一个输出 10M token 的批处理任务,改到低谷时段运行。
一个商品目录团队要生成 10,000 条商品描述。每次调用发送 1,500 个 token 的商品数据(每个商品都不同,因此没有缓存收益),返回 1,000 个 token 的文案。也就是 15M 输入 token,全部未命中,以及 10M 输出 token。
- 高峰时段:输入 15 × $0.30 = $4.50。输出 10 × $1.20 = $12.00。合计 $16.50。
- 低谷时段:输入 15 × $0.15 = $2.25。输出 10 × $0.60 = $6.00。合计 $8.25。
- 仅仅换个时间就省下:$8.25,prompt 完全不用改。
这个任务以输出为主,而输出是本次发布中降幅最小的一项,所以低谷时段才是更大的杠杆。这个窗口相当宽裕:每个工作日从 10:00 UTC 起有 15 个小时,再加上每个周末连续 48 小时。
上下文、输出,以及为什么并发也算在价格里
两个模型名都提供 1M token 的上下文窗口和 384K token 的最大输出。model card 建议 max tokens 设为 256K 或更高,所以要有意识地设置这个上限:一段跑到 384K 输出 token 的响应在高峰时段要花 $0.46,对 agent 对话记录来说没问题,对自动补全来说就是个 bug。
Flash 的并发是 2,500,Pro 是 500。这一点值得写进一篇价格文章,因为低谷折扣只有在你真能把任务塞进那个窗口时才有价值;也因为 9 月 14 日被重新路由的 deepseek-v4-pro 流量会继承 Flash 的上限:一个原本排在 500 个槽位后面的 Pro 集成,不用改任何配置就能获得五倍的余量。
用 Apifox 测量真实开销
价格表告诉你费率,而每次响应里的 usage 对象告诉你实际被计费的内容。下面是一个 Apifox 工作流,把它变成可重复的检查。
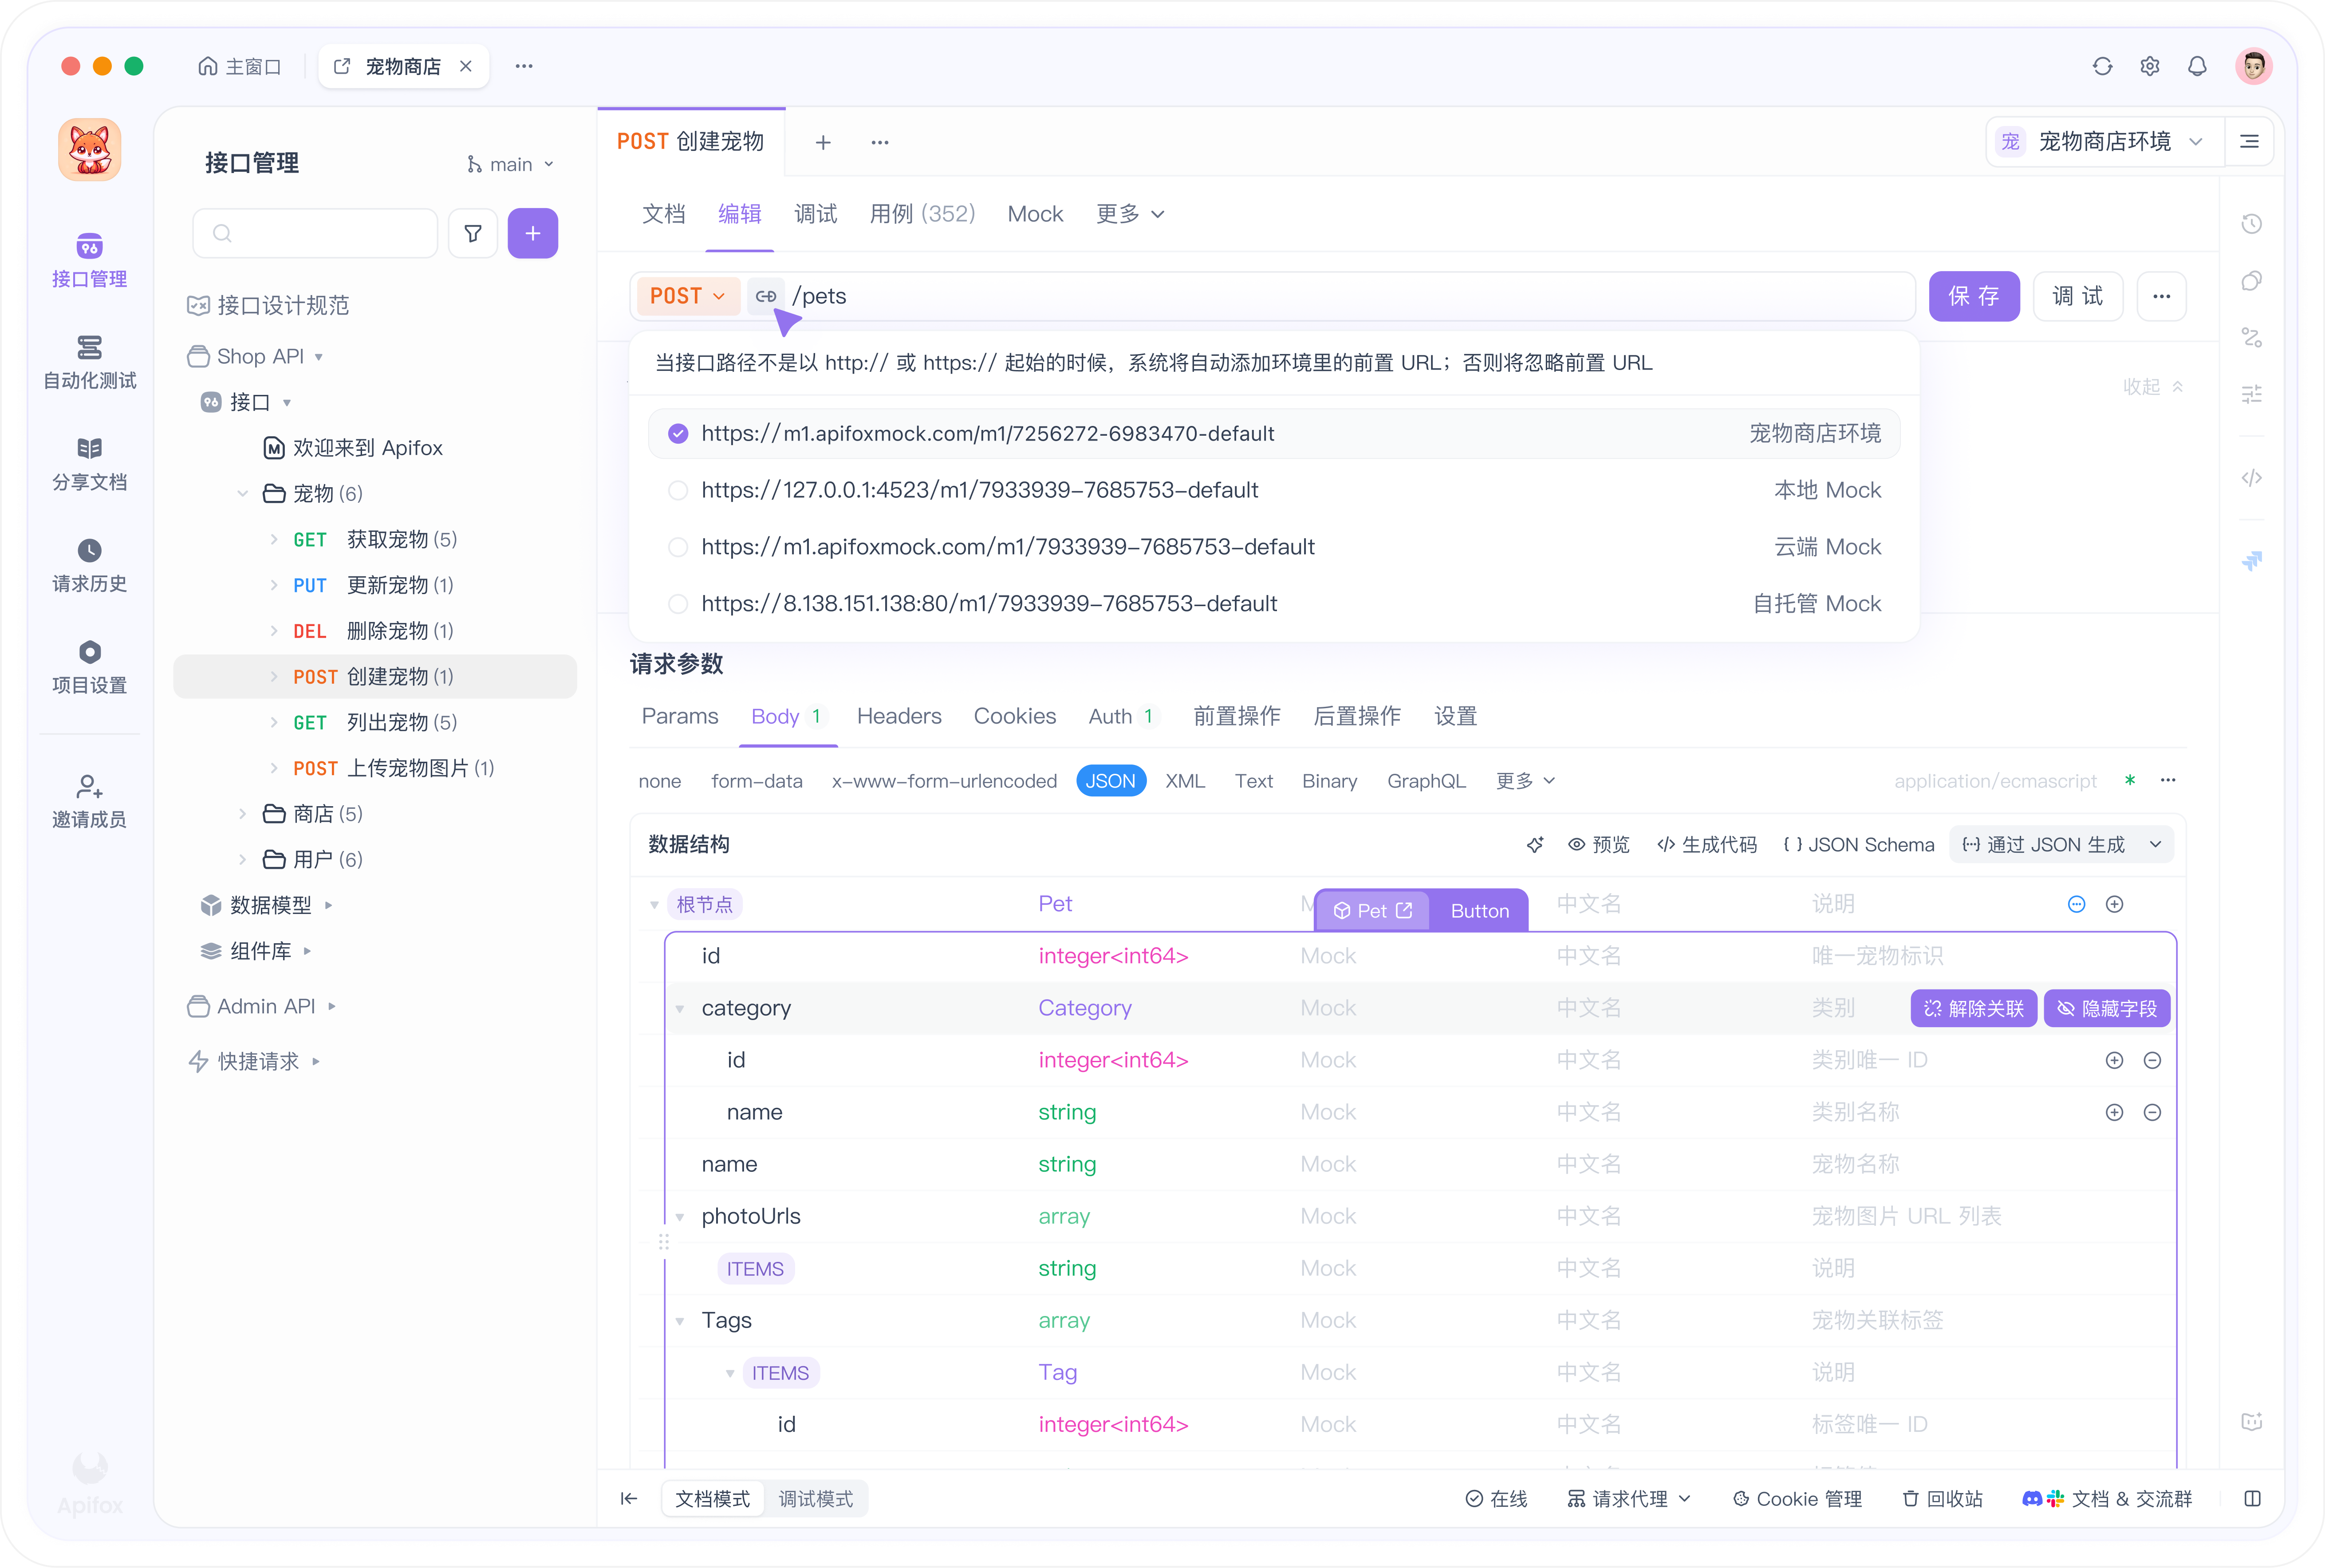
- 添加接口。创建
POST https://api.deepseek.com/chat/completions,或者导入一份 OpenAI 兼容的 OpenAPI spec。 - 把价格放进环境。创建两个 Apifox 环境
deepseek-peak和deepseek-offpeak,各自保存DEEPSEEK_API_KEY,以及PRICE_HIT、PRICE_MISS和PRICE_OUT作为{{variables}}。peak 里放 0.006 / 0.30 / 1.20,off-peak 里放 0.003 / 0.15 / 0.60。 - 发送一次并读取
usage。DeepSeek 会把输入拆分为prompt_cache_hit_tokens和prompt_cache_miss_tokens,与completion_tokens并列返回 [VERIFY]。把这个请求保存为测试用例。 - 构建一个对缓存行为做断言的测试场景。用相同的 20K token system prompt 把保存的请求串联两次。在第二步上断言:命中 token 字段至少为 19,000,并且计算出的成本(hits ×
{{PRICE_HIT}}+ misses ×{{PRICE_MISS}}+ output ×{{PRICE_OUT}},再除以 1M)保持在预算之内。第二步未命中说明前缀变了,这个断言会在账单之前发现问题。 - 对比高峰与低谷。在两个环境下分别运行该场景并对比成本行,或者用
apidog-cli在 CI 中按跨越 UTC 高峰边界的计划运行。
你的账单会因此变成什么样
V4.1-Flash 在每一项上都比 V4-Flash 便宜,并且比它所取代的 V4-Pro 价格便宜 70% 到 86%。有两个杠杆值得关注:让长前缀保持字节完全一致以命中缓存,把批处理任务安排在工作日 7 个小时的高峰时段之外。然后在每次调用时记录 usage,对命中数量做断言,让数字告诉你这次降价是否真的落到了你的发票上。
HiFox :将 Agent 变成真正的队友
另外,我们也在思考,AI 如何从个人提效走进团队协作。
HiFox 是一个让人和 AI Agent 在同一个工作现场协作的平台:你可以像给同事分派任务一样指派 Agent,在任务看板中跟踪进度、查看结果,让 Agent 成为团队里的队友。
👉 立即体验 Hifox:https://hifox.com
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。