每个列表接口最终都会面临同一个问题:如何将 200 万条订单数据拆分成客户端可以逐页浏览的页面?选择偏移量分页,你可以获得简单的 SQL 语句以及用户易于理解的页码;选择游标分页,你可以获得稳定的结果以及在任何分页深度下都一致的延迟,但你必须放弃“跳转到第 47 页”的功能。
大多数团队选择偏移量分页,是因为它是所有教程中的默认方式。然而,当订单表的数据量达到数百万行时,第 4000 页开始超时,用户在滚动浏览时报告看到了相同的重复记录。本指南将介绍这两种分页方式的工作原理、偏移量分页在何处会失效、为什么 Stripe 和 Slack 选择使用游标,以及如何在 Apifox 中通过链式请求测试这两种分页方式。读完本文后,你将准确了解哪一种方式最适合你的接口。
如果你想先了解更广泛的全局视角,我们的 API 分页指南并行对比了每一种策略。本文则深入探讨其中最重要的两种方式。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
偏移量分页的工作原理
偏移量分页直接映射到 SQL。客户端发送页码和每页条数;服务端将其转换为 LIMIT 和 OFFSET。
SELECT id, customer_id, total_cents, created_at
FROM orders
ORDER BY created_at DESC
LIMIT 25 OFFSET 50;
该查询按每页 25 行返回订单列表的第 3 页。请求如下所示:
GET /v1/orders?page=3&per_page=25
典型的响应如下:
{
  "data": [
    {
      "id": "ord_8821",
      "customer_id": "cus_1932",
      "total_cents": 4599,
      "created_at": "2026-08-30T14:22:07Z"
    }
  ],
  "page": 3,
  "per_page": 25,
  "total": 1848203,
  "total_pages": 73929
}
它的吸引力显而易见。客户端可以跳转到任意页面,服务端可以返回总条数,任何开发者都能在半天内构建完成。对于小型后台管理界面数据表来说,这是正确的选择,我们在 REST API 分页分步指南中详细介绍了完整的偏移量构建过程。
但是偏移量分页带有两个结构性问题,这两个问题在开发环境中都不会显现,只有在生产环境中才会暴露出来。
问题 1:页漂移(Page Drift)
OFFSET(偏移量)从排序结果的顶部开始计算行数。它完全不知道客户端已经看过了哪些行。因此,当在两次请求之间插入或删除数据行时,页面会在客户端不知情的情况下发生偏移。
假设用户加载了按最新排序的第 1 页订单(第 1 到 25 行)。在他们浏览时,新增了 3 个新订单。随后用户请求第 2 页,其查询参数为 OFFSET 25。此时,第一次响应中的第 23、24 和 25 行已被推至第 26 到 28 的位置。用户会再次看到它们——即产生了重复数据。
删除操作则相反。如果在用户浏览第 1 页时删除了 3 行,那么 OFFSET 25 将跳过用户从未见过的 3 行数据。这就导致了静默的数据遗漏,而且没有任何人会收到报错信息。
对于没人实时滚动查看的月度报告来说,数据漂移是无害的。但对于动态流(activity feed)、同步接口(sync endpoint)或者任何在持续写入数据的同时由脚本逐页遍历的内容,数据漂移意味着记录会出现重复或遗漏。调用方会察觉到这一点。
问题 2:深分页 OFFSET 会扫描跳过的所有数据
OFFSET 500000 并不会直接传送(跳)到第 500,001 行。数据库会遍历索引中的 50 万条记录,将它们丢弃,然后再返回所需的 25 行数据。开销随着深度的增加呈线性增长:时间复杂度为 O(n),其中 n 是 OFFSET(偏移量)。
用具体的数据来说明更直观。假设在拥有 200 万行记录且包含 created_at 索引的 Postgres orders 表上:
LIMIT 25 OFFSET 0读取 25 个索引条目。耗时仅几毫秒。LIMIT 25 OFFSET 100000读取 100,025 个条目并丢弃 100,000 个。耗时数十毫秒。LIMIT 25 OFFSET 1500000读取 150 万个条目。此时耗时已高达数百毫秒,仅仅为了返回一个页面就在占用缓冲区并消耗大量 CPU。
Markus Winand 在 Use The Index, Luke 上撰写的 no-offset 探讨文章 通过查询计划详细展示了这种开销,非常值得完整阅读。在生产环境中,典型的现象是慢查询日志被高 OFFSET 的请求(通常来自忠实地逐页爬取公共 API 的某个网络爬虫)所占据。仅仅这一个客户端,就能让你的 p99 耗时翻倍。
基于游标的分页是如何工作的
基于游标的分页(Cursor-based pagination,也称为键值集分页 keyset pagination)不再使用行计数器。客户端不再要求“跳过 50 行”,而是说“给我这条特定记录之后的数据”。游标标识了客户端看到的最后一行记录,因此服务端可以直接定位(seek)到下一批数据。
对应的 SQL 语句在排序键上使用行比较,而不是 OFFSET:
SELECT id, customer_id, total_cents, created_at
FROM orders
WHERE (created_at, id) < ('2026-08-30T14:22:07Z', 'ord_8821')
ORDER BY created_at DESC, id DESC
LIMIT 25;
请注意这里的双列比较。单靠 created_at 并不唯一;两个订单可能会落在同一毫秒内,而非唯一的排序键会导致记录在分页边界处被遗漏或重复。将 id 作为决胜键(tiebreaker)加入比较,可以确保排序的完全唯一性以及分页的准确性。在针对 (created_at, id) 建立了复合索引的情况下,数据库会直接定位到边界并读取 25 条记录。第 1 页和第 60,000 页的查询开销是完全一样的。
不过,API 不应该直接暴露这些原始值。实际实现中,通常会将排序键编码为一个不透明的 Token,通常使用 Base64:
GET /v1/orders?limit=25&cursor=eyJjcmVhdGVkX2F0IjoiMjAyNi0wOC0zMFQxNDoyMjowN1oiLCJpZCI6Im9yZF84ODIxIn0
不透明性是一项设计决策,而非为了混淆而混淆。如果客户端无法解析该游标,它们就无法手动构建 URL,这样你就可以自由地更改排序键、添加分片提示(shard hint)或切换存储引擎,而不会破坏任何人的集成。此时契约变为了“把我们提供给你的值传回即可”,仅此而已。
权衡之处在于:没有第 47 页这样的概念。游标(cursor)只知道“在此行之后”,因此客户端每次只能向前(如果提供了上一页游标,则可以向后)逐页遍历。总数也不会自动附带;统计总数是一个单独的查询。对于数据集本身非常庞大的设计,我们关于为数百万条记录设计 API 分页的指南更深入地探讨了扩展方面的内容。
权衡一览
| 维度 | Offset 分页 | 基于游标的分页 |
|---|---|---|
| 跳转到任意页 | 支持,任意页码 | 不支持,仅支持按顺序遍历 |
| 总数 / 总页数 | 包含开销低 | 需要单独查询总数 |
| 深分页性能 | O(n),随深度增加而下降 | 任何深度下每页均为 O(1) |
| 写入时的稳定性 | 漂移:出现重复和遗漏 | 稳定,锚定到特定行 |
| 构建成本 | 极低 | 中等:包含编码、平局决胜(tiebreaker)、索引设计 |
| 排序要求 | 任何 ORDER BY 均可 | 需要唯一且建有索引的排序键 |
| 缓存页面 URL | 简单,URL 可预测 | 较难,每次遍历的游标均不相同 |
| 客户端复杂度 | 低 | 低(在响应外壳结构干净的情况下) |
表格中有一个细节值得特别强调:游标分页需要确定性的排序。如果你的接口允许客户端根据可变且不唯一的列(例如 status)进行排序,键集(keyset)逻辑很快就会变得十分棘手。Offset 可以容忍随意不严谨的排序;游标则对此要求严格。
应该选择哪种方式?
根据数据的消费方式来匹配相应的分页模式。
管理后台表格与仪表盘:Offset。 适用于只有几千行数据的内部工具、用户手动点击页码、且界面上展示明确的“1,848 条结果”计数的场景。数据漂移并不重要,翻页深度较浅,且“跳转到指定页”是刚需功能。Offset 在构建成本上胜出。
无限滚动 Feed 流:游标。 没有人会在 Feed 流中直接跳转到第 47 页。用户只会不断加载“更多”,数据写入频繁发生,出现重复数据不仅显而易见而且体验糟糕。这是使用游标的教科书级场景。
开放 API:游标。 你无法控制你的 API 调用方。总会有人写循环去遍历每一个页面,如果是 Offset,深分页性能问题就会在凌晨 3 点变成你的噩梦。游标能让每一页的查询成本保持极低,并允许你在不透明的 Token 背后演进内部架构。我们的 REST API 分页指南详细介绍了 URL 和 header 规范。
数据导出与同步任务:游标。 拉取全部 200 万条订单的批处理任务需要两个保证:即使存在并发写入也不会遗漏数据,以及每页固定的查询成本。Offset 这两点都无法提供。此外,当任务在第 140 万行挂掉时,游标还能天然提供一个断点续传的恢复点。
简而言之的大致原则:对于小型、人工浏览、重度依赖计数的界面,使用 Offset;对于任何海量数据、实时变化或开放对外的情况,使用游标。
真实 API 是如何处理的
Stripe 完全基于游标(cursor)。每个列表接口都接受 starting_after(对象 ID)和 limit 参数,并且响应中包含 has_more。要获取下一页扣款记录(charges),你只需传入上一页接收到的最后一个扣款记录的 ID。Stripe 分页文档展示了这种模式;注意其中完全没有提供总条数(total count),在他们庞大的写入量级下,这是刻意为之的设计。
GitHub 的 REST API 在大多数接口上仍然提供 page 和 per_page 参数,并通过 Link header 指向下一页和最后一页。但仔细阅读 GitHub 分页文档会发现:他们指导客户端直接使用 Link header 中的原样 URL,而不是手动拼接页面 URL。而且更新的接口已经转向了游标(cursor)机制,正是因为在超大型仓库上进行深层偏移量(offset)遍历会严重影响性能。
Slack 将其 Web API 迁移到了游标分页(cursor pagination),并将其标注为所有新方法推荐使用的方案。像 conversations.history 这样的方法会返回 response_metadata.next_cursor,空字符串游标表示已到达末尾,如 Slack 分页文档所述。
这三个高流量 API 的演进方向非常一致:全面拥抱游标(cursor)。
设计响应 Envelope
基于游标的 API 设计成败在于其响应结构(envelope)。保持其简单且可预测:
{
  "data": [
    {
      "id": "ord_8846",
      "customer_id": "cus_2201",
      "total_cents": 12900,
      "created_at": "2026-08-30T16:01:44Z"
    }
  ],
  "has_more": true,
  "next_cursor": "eyJjcmVhdGVkX2F0IjoiMjAyNi0wOC0zMFQxNjowMTo0NFoiLCJpZCI6Im9yZF84ODQ2In0"
}
四条规则能让它足够健壮:
- 始终返回
has_more。 客户端不应该通过单页条数较少来推断分页结束;如果在获取数据后进行了过滤,列表中途的单页数据量也可能变少。 - 在最后一页返回
next_cursor: null,并在文档中加以说明。Slack 采用空字符串的习惯也同样可行;选择一种并保持统一,绝不要混用。 - 对无效的 cursor 返回 400,而不是返回一个空的 200 响应。损坏的游标属于客户端 bug,隐瞒这个错误会让排查人员多花一天时间去调试。
- 如果 cursor 载荷编码了排序键之外的更多信息,请对其进行签名或版本控制。 在下一次数据模型(schema)迁移时,你会感谢自己做出了这个决定。
在 Apifox 中测试这两种模式
分页相关的 bug 往往隐藏在边界条件中:最后一页、空数据页、锚点行被删除的游标等。手动点击测试很难发现这些问题,但串联的测试场景(test scenario)可以,这正是 Apifox 在工作流中发挥价值的地方。
对于游标接口,可以构建一个包含两个步骤的测试场景:
- 调用接口并提取 cursor。 为第一个请求添加后置操作,使用 JSONPath
$.next_cursor并将其存储在类似于nextCursor的变量中。Apifox 支持直接从响应面板复制 JSONPath;完整步骤请参考如何设置断言及使用 JSONPath 提取变量。 - 循环请求下一页。 将第二个请求包裹在 ForEach 或循环步骤中,传入
{{nextCursor}}作为 cursor parameter,在每次迭代中重新提取$.next_cursor,并在has_more为 false 时退出循环。在每次遍历中断言上一页的id没有重复,且单页数量决不超过limit。
对于基于 offset 的接口,也可以采用相同的结构并配合计数器变量:递增 page,断言 data 的长度等于 per_page(直到最后一页),并断言 total 在整个遍历过程中保持一致。
然后将边界用例作为独立步骤添加,每个步骤都附带明确的断言:
- 空页:请求匹配 0 行数据的筛选条件;断言
data为[],has_more为 false,且状态码为 200。 - 无效 cursor:发送
cursor=not-a-real-cursor;断言状态码为 400 并返回机器可读的错误码。 - 锚点行被删除:创建一个订单,获取锚定到该订单的 cursor,删除该订单,然后使用该 cursor;断言遍历过程从正确的位置继续,而不是报错。Keyset 比较机制天然支持这种情况,而测试也证实了这一点。
一旦测试场景在本地通过,即可在每次合并时于 CI 中运行。免费下载 Apifox,你就能在半小时内建立并运行包含循环和断言的完整 cursor 遍历测试场景。
FAQ
Cursor 分页总是更好吗?
并不是。当用户需要在适度规模的数据集上进行页码翻页、查看总数以及随机访问时(大部分内部后台管理工具均属此类),Offset 更为合适。当数据集较大、写入频繁或 API 为公开接口时,Cursor 的效果更好。最容易踩坑的情况是在公开列表接口上默认使用 offset,直到上线后才发现其 O(n) 的性能开销。
使用 cursor 分页时如何获取总数?
使用相同的筛选条件单独执行一条 SELECT COUNT(*),可以作为一个独立的接口,或者作为一个可选的 query 参数(如 include_count=true)。对其进行强缓存;每分钟刷新一次的近似总数几乎能满足所有 UI 需求。Stripe 则完全跳过了总数展示,这足以说明客户端真正需要总数的频率有多低。
我可以在同一个接口上同时提供这两种分页方式吗?
可以,GitHub 在过渡期间也确实是这么做的,但在新 API 中应尽量避免。两种方式意味着两套边界用例、两套测试矩阵,以及客户端对于该使用哪种方式的困惑。每个接口选择其中一种即可。如果你正在从零开始设计 API 契约,我们 REST API 分页指南中的设计模式有助于在你的所有接口中保持 parameter 命名的一致性。
如果 cursor 锚定的行被删除了会怎样?
使用 keyset 分页时,一切都能正常运转。WHERE (created_at, id) < (?, ?) 比较操作并不要求锚点行必须存在;它会直接定位到边界位置并继续向下检索。相比“将游标用于行查找”的设计,这是一个真正的优势,也恰恰是在接口调用方发现问题之前,值得在你的 Apifox 测试场景中进行断言验证的边界情况。
开发必备:API 全流程管理神器 Apifox
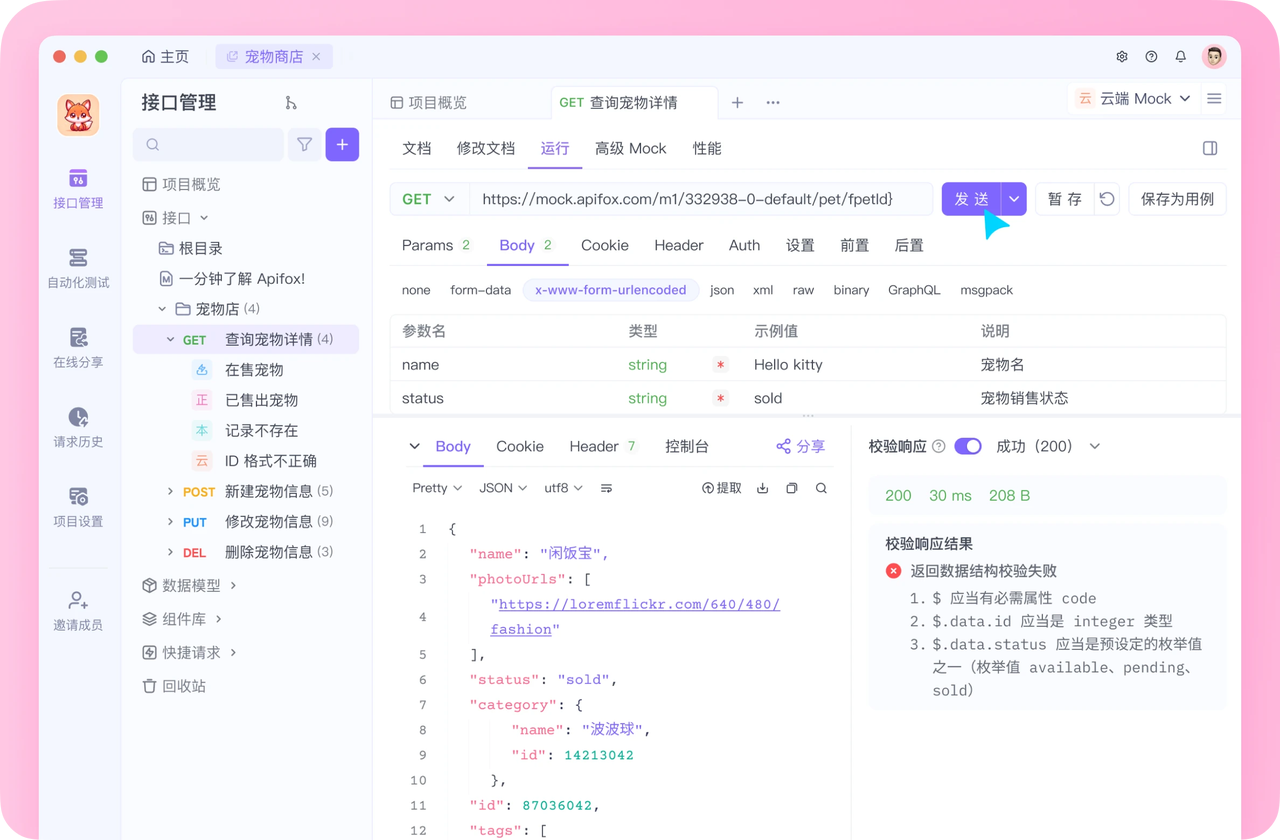
介绍完上文的内容,我想额外介绍一个对开发者同样重要的效率工具 —— Apifox。作为一个集 API 文档、调试、设计、测试、Mock、自动化测试于一体的工具,Apifox 是目前提升研发效率的首选。
如果你正在开发项目,不妨试试其极其友好的界面设计,它完全兼容 Postman 和 Swagger 数据格式,导入数据非常方便,,即使是新手也能很快上手,点击这里即可注册使用。
值得一提的是,除了个人和常规团队使用,针对有高安全合规要求、或需要在内网环境协作的企业,Apifox 还提供了深度定制的私有化部署方案。
获取专属报价与部署方案
 详细的私有化部署系统架构与安全白皮书
 针对您公司规模的专属报价单
 免费的 1v1 专属产品演示 (Demo) 机会