摘要:GitHub 在 9 月 25 日给 Copilot 用量指标报告加了一层 PR 审查耗时拆分:在新的 pull_request_review_times 数组里,分别给出“就绪到首次审查”“首次到最终审查”“最终审查到合并”三段的中位数与 P90。机器人和 Copilot 代码审查的时间不计入。
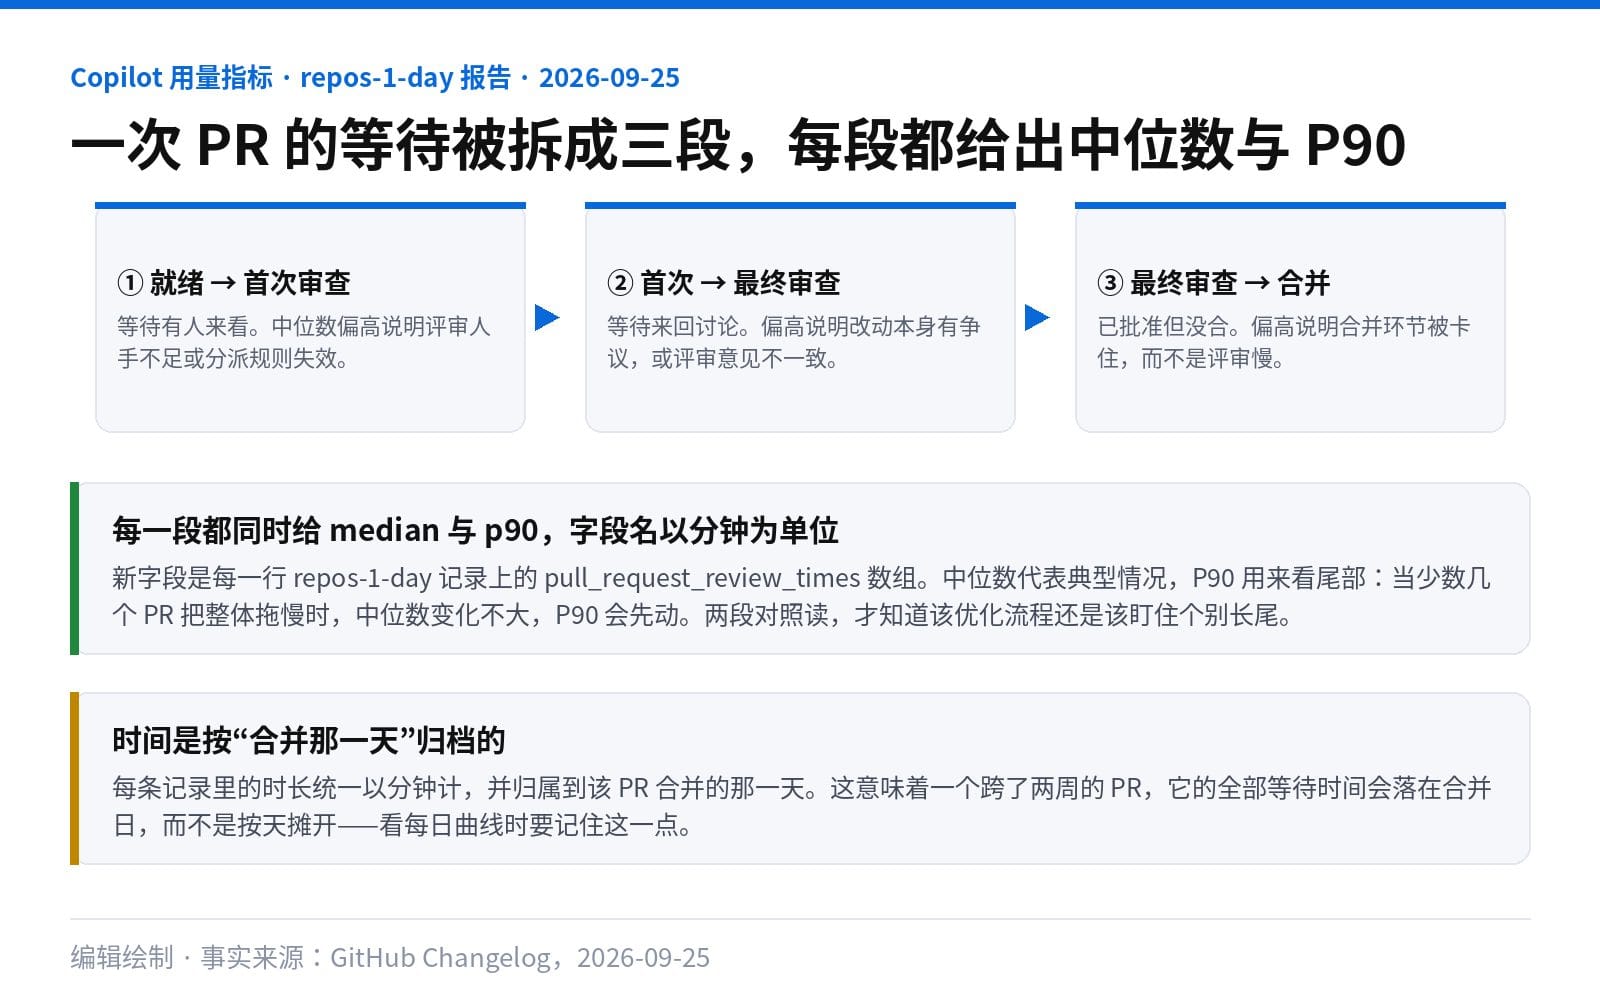
“我们的 PR 平均要等两天才合”这句话,几乎无法直接指导行动——等两天可能是在等人看一眼,也可能是评审来回了五轮,还可能是批了但没人点合并。这三种情况的解法完全不同:第一种要调整分派与人力,第二种要改评审范围或拆小改动,第三种只需要提醒合并。GitHub 这次的改动,就是把这条总等待时间切开。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。

发生了什么:新的 pull_request_review_times 数组
企业和组织的仓库级 Copilot 用量指标报告,现在会细分 pull request 在审查各阶段停留的时间。新增的 pull_request_review_times 数组挂在每一行 repos-1-day 记录上,每条记录包含三组指标,每组都有中位数和 90 分位数:
median_minutes_ready_to_first_review与p90_minutes_ready_to_first_review:从 PR 变为“可审查”到第一次审查。median_minutes_first_to_final_review与p90_minutes_first_to_final_review:第一次审查到最终审查之间。median_minutes_final_review_to_merge与p90_minutes_final_review_to_merge:从最终审查到合并。
每条记录还带有 authored_by、reviewed_by(本次发布中两者都是人)以及 total_merged,也就是当天在该仓库里合并的、符合条件的 PR 数量。时长统一以分钟计,并归属到该 PR 合并的那一天。原有的 pull_requests 字段保持不变。
为什么中位数旁边还要放一个 P90
官方给出的理由很具体:团队本来就能看到 PR 合得慢,但看不出慢在哪一段。拆成三段之后,等待是在等人看、在评审来回、还是批了没合,分别指向不同的修复动作;而 90 分位数放在中位数旁边,是为了显示“什么时候是少数几个慢 PR 在拖累整体”。
这两个数字的读法值得提前说清楚。中位数反映典型情况,改动流程后它才会整体移动;P90 反映尾部,如果只有个别 PR 卡了很久,中位数几乎不动,P90 会先抬头。所以正确的用法是成对看:中位数抬升说明流程有系统性问题,中位数平稳但 P90 抬升说明有长尾个案需要单独处理,两者的动作完全不同。
一个具体的读法:两个仓库的中位数一样,结论却相反
假设两个仓库的“就绪到首次审查”中位数都是 900 分钟,也就是大约半天多。单看这个数字,两个仓库的问题看起来一样。但把 P90 放进来就会出现分歧:A 仓库的 P90 是 1,100 分钟,紧贴中位数,说明绝大多数 PR 都在等着有人看,这是评审人力或分派机制的系统性问题;B 仓库的 P90 是 4,000 分钟,中位数却被少数快 PR 拉低,说明整体流程没问题,卡的是个别长期没人认领的 PR。前者适合调整评审轮值与分派规则,后者适合加一个“超过阈值自动提醒”的机制。同一张表里两个数字并排,才能把这两种情况分开。
需要提醒的是,原有的 pull_requests 字段保持不变,因此已经在消费这些报告的流水线不会因为这次更新而报错;新增字段是增量信息,你可以先把它接进看板观察一段时间,再决定是否纳入考核口径。
计数口径:谁被计时,谁被排除
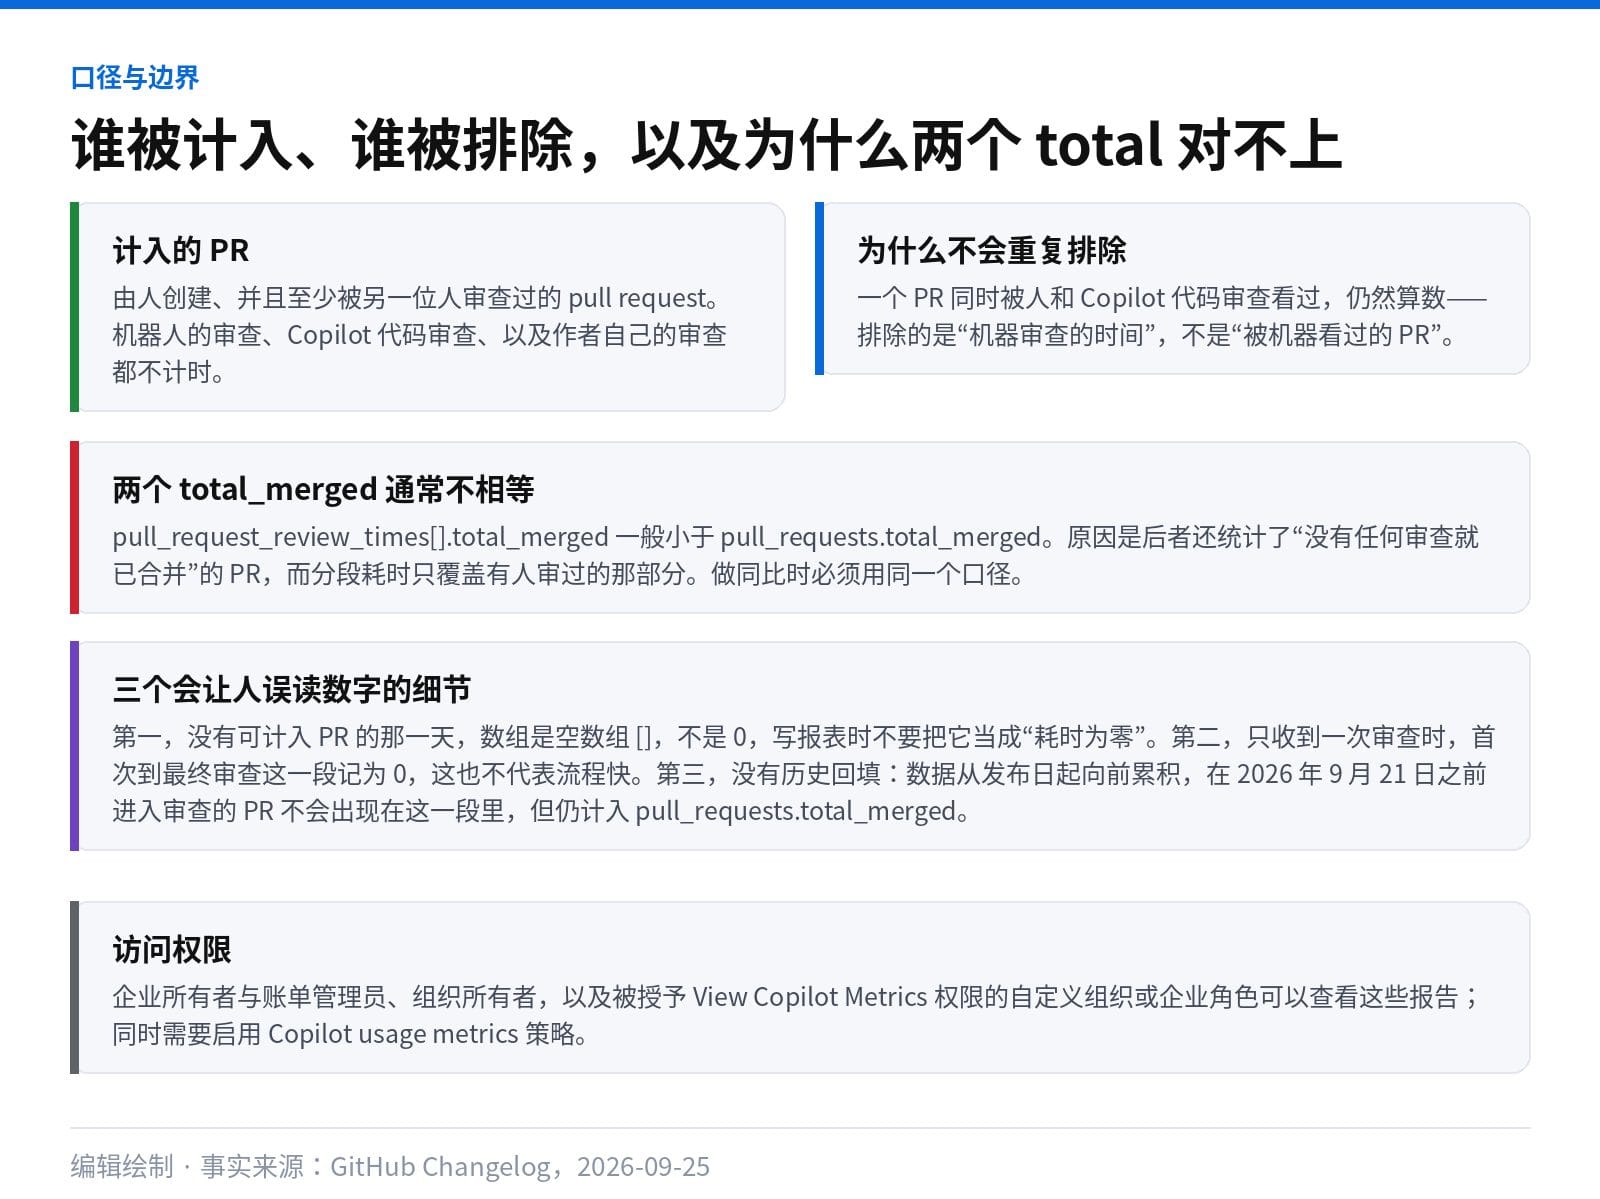
这一段的定义需要逐字读,因为它决定了数字能不能用。被计入的是“由人创建、并且至少被另一位人审查过”的 pull request;只有人的审查被计时,Copilot 代码审查、其他机器人的审查以及作者自己的审查都被忽略。由此推出一处容易误读的地方:一个 PR 同时被人和 Copilot 代码审查看过,它仍然算数——被排除的是机器审查的时间,而不是被机器看过的 PR。
这也解释了为什么两个 total 通常不相等:pull_request_review_times[].total_merged 一般小于 pull_requests.total_merged,因为后者还统计了没有任何审查就直接合并的 PR。做同比或把两个数放进同一张表时,必须确认口径一致,否则差异会被误读成流程变化。
限制与人应该在哪儿接管
有三个细节会在看数字时误导人。第一,某一天没有符合条件的 PR 时,数组是空数组而不是 0——写报表时不能把它当成“耗时为 0”。第二,PR 只收到一次审查时,“首次到最终审查”这一段记为 0,这并不代表流程快,而是这一阶段不存在。第三,没有历史回填:数据从发布日向前累积,在 2026 年 9 月 21 日之前进入审查的 PR 不会出现在这一段里,但仍会计入 pull_requests.total_merged。也就是说,刚上线这段时间的数据是薄的,不适合立刻当作基线。
访问权限同样需要先确认:企业所有者与账单管理员、组织所有者,以及被授予 View Copilot Metrics 权限的自定义组织或企业角色可以查看这些报告,同时需要启用 Copilot usage metrics 策略。如果组织里报表由数据团队而非管理员维护,权限申请要提前走。
至于指标之外的部分——某个 PR 到底卡在谁身上、评审来回是不是因为需求没写清楚——仍然要人去读具体的 PR 记录。这个数组能告诉你“哪一段慢”,不会告诉你“为什么慢”。把人力和流程的调整决策寄托在指标自动给出答案上,是把工具用错了位置。
如何试用
在企业或组织的仓库级 Copilot 用量指标报告里找到 repos-1-day 行,读取新增的 pull_request_review_times 数组即可。建议先按仓库分组,把三段的中位数放在一起对比,再对中位数最高的那一两个仓库去看对应的 P90——从“哪一段最慢”入手,比从总时长入手更容易找到可改的动作。
信息来源
- GitHub Changelog:Usage metrics API adds pull request review stages(2026-09-25,字段清单、计数口径、归档规则、回填与权限说明均出自该条)
开发必备:API 全流程管理神器 Apifox
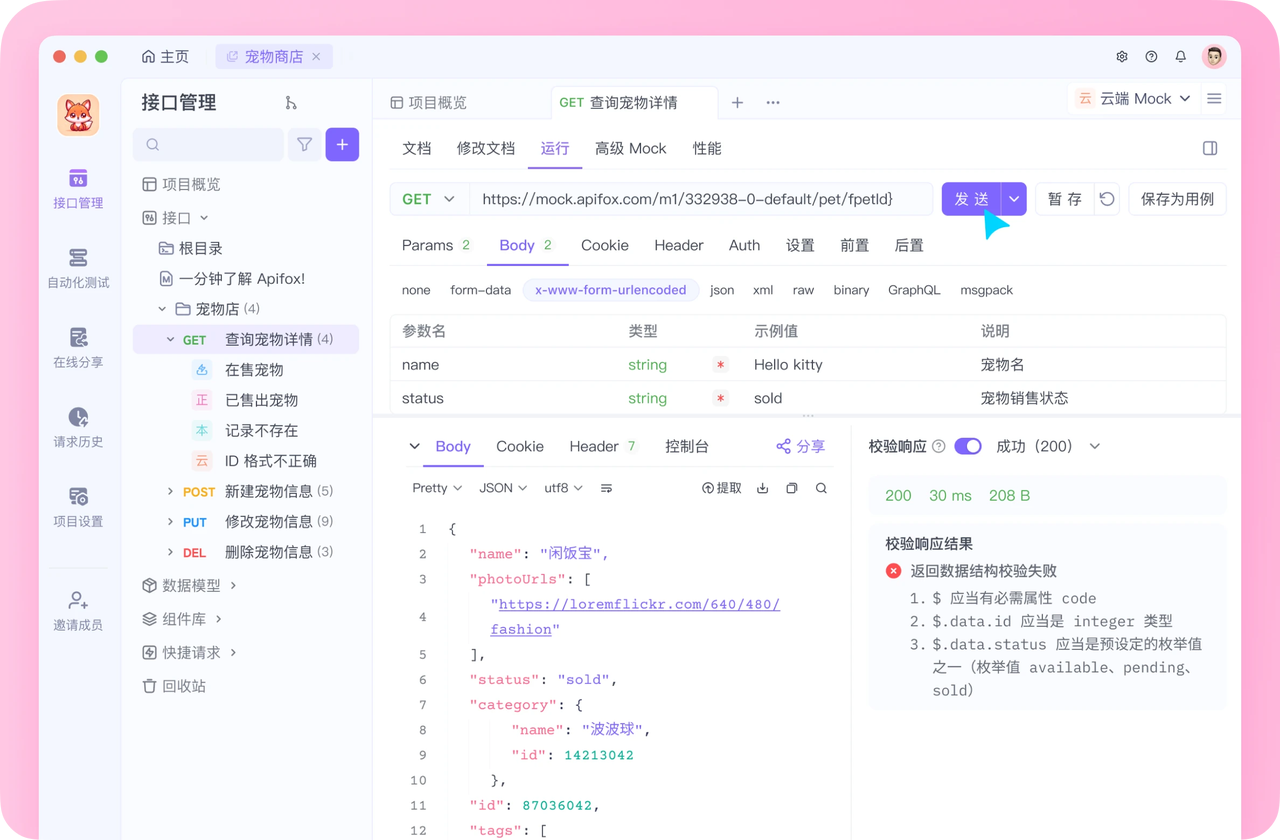
介绍完上文的内容,我想额外介绍一个对开发者同样重要的效率工具 —— Apifox。作为一个集 API 文档、调试、设计、测试、Mock、自动化测试于一体的工具,Apifox 是目前提升研发效率的首选。
如果你正在开发项目,不妨试试其极其友好的界面设计,它完全兼容 Postman 和 Swagger 数据格式,导入数据非常方便,,即使是新手也能很快上手,点击这里即可注册使用。
值得一提的是,除了个人和常规团队使用,针对有高安全合规要求、或需要在内网环境协作的企业,Apifox 还提供了深度定制的私有化部署方案。
获取专属报价与部署方案
 详细的私有化部署系统架构与安全白皮书
 针对您公司规模的专属报价单
 免费的 1v1 专属产品演示 (Demo) 机会