摘要
2026 年 9 月 22 日,GitHub 在 Changelog 里发布了一条针对 C++ 的更新:Copilot CLI 的 C++ 代码智能开始支持"全代码库索引"(whole codebase indexing,WCI),由 Microsoft C++ Language Server 驱动,并且默认开启。它解决的问题很具体——C++ 仓库动辄几十万到上百万行、源文件与头文件层层互相引用,过去每一次"这个函数在哪被调用"的提问都要现场重新推导一遍项目信息。
代价同样明确:首次为整个项目建索引会额外花时间,并临时抬高内存占用,仓库越大越明显。这篇文章讲清三件事:索引到底索引了什么、它替 agent 省掉了哪一步、以及哪些仓库现在还不该打开它。
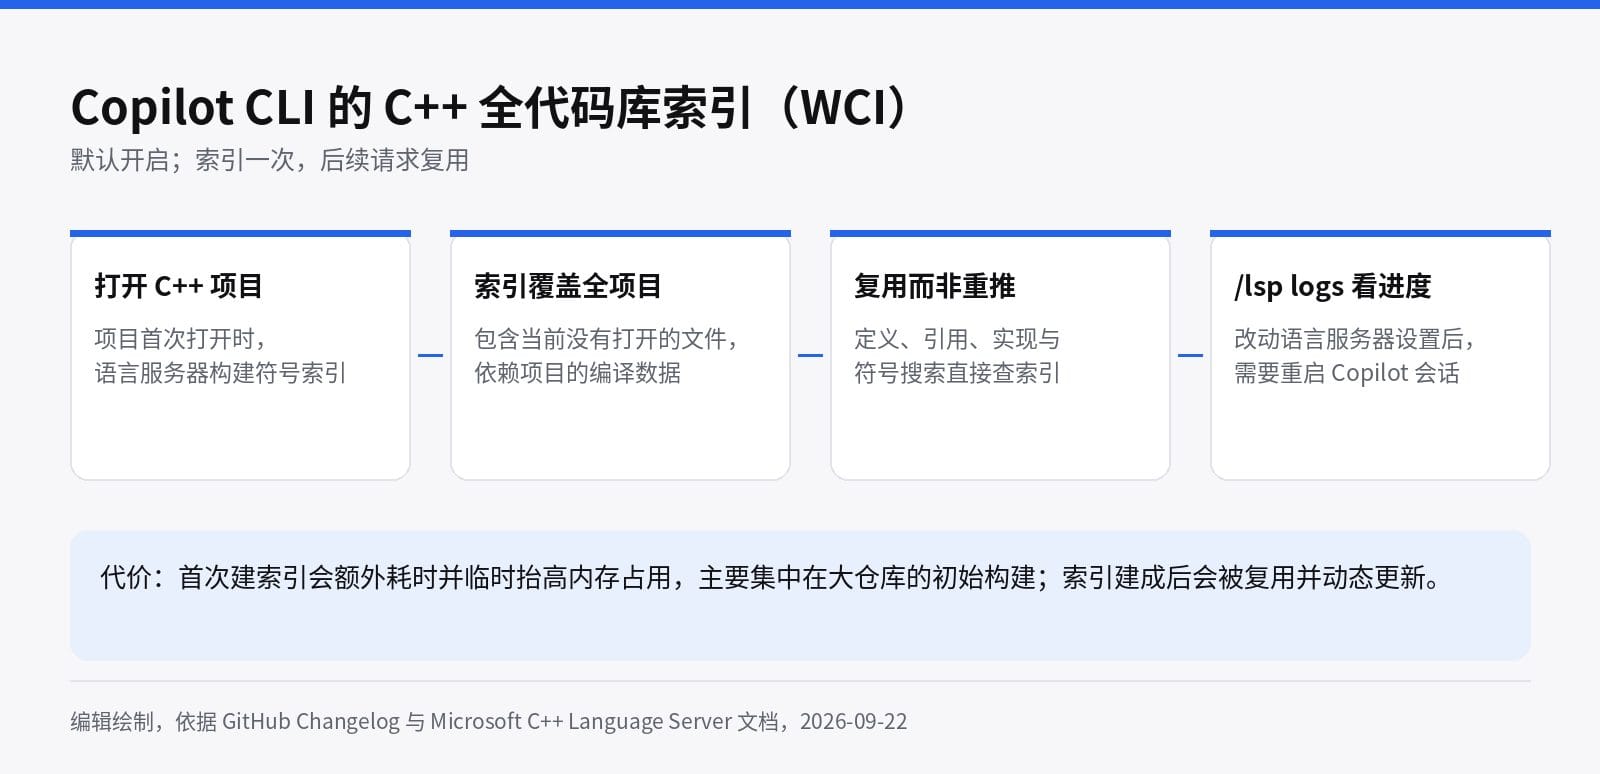
要判断这次更新值不值得开,得先分清"索引"和"上下文"是两件事。模型能看到的上下文是你主动喂进去的代码和工具输出,而语言服务器的索引是编辑器侧的符号数据库——它决定 agent 能不能在几秒内回答"这个类型在哪定义、这个函数被谁调用",而不是靠 grep 加猜测。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。

发生了什么:为整个项目建一份可复用的符号索引
GitHub 的表述是:"C++ code intelligence in GitHub Copilot CLI is now faster with support for whole codebase indexing."。背景在原文里也写得很直白:C++ 仓库可能包含数百万行代码,源文件与头文件之间深度互联;如果没有一份可复用的索引,代码智能请求就必须在导航过程中反复推导项目信息,定义跳转、引用查找和理解陌生代码都会变慢。
WCI 的做法是建一份持久的符号索引,覆盖整个 C++ 项目,包括当前没有打开的文件。语言服务器会借助项目的编译数据去解析类型、符号、include 关系和文件之间的引用,之后这些符号信息被复用,而不是每来一个请求就重新发现一次。索引在 C++ 项目第一次打开时加载,进度可以随时用 /lsp logs 查看。GitHub 列出它改善的四类结果:定义、引用、实现和符号搜索结果。
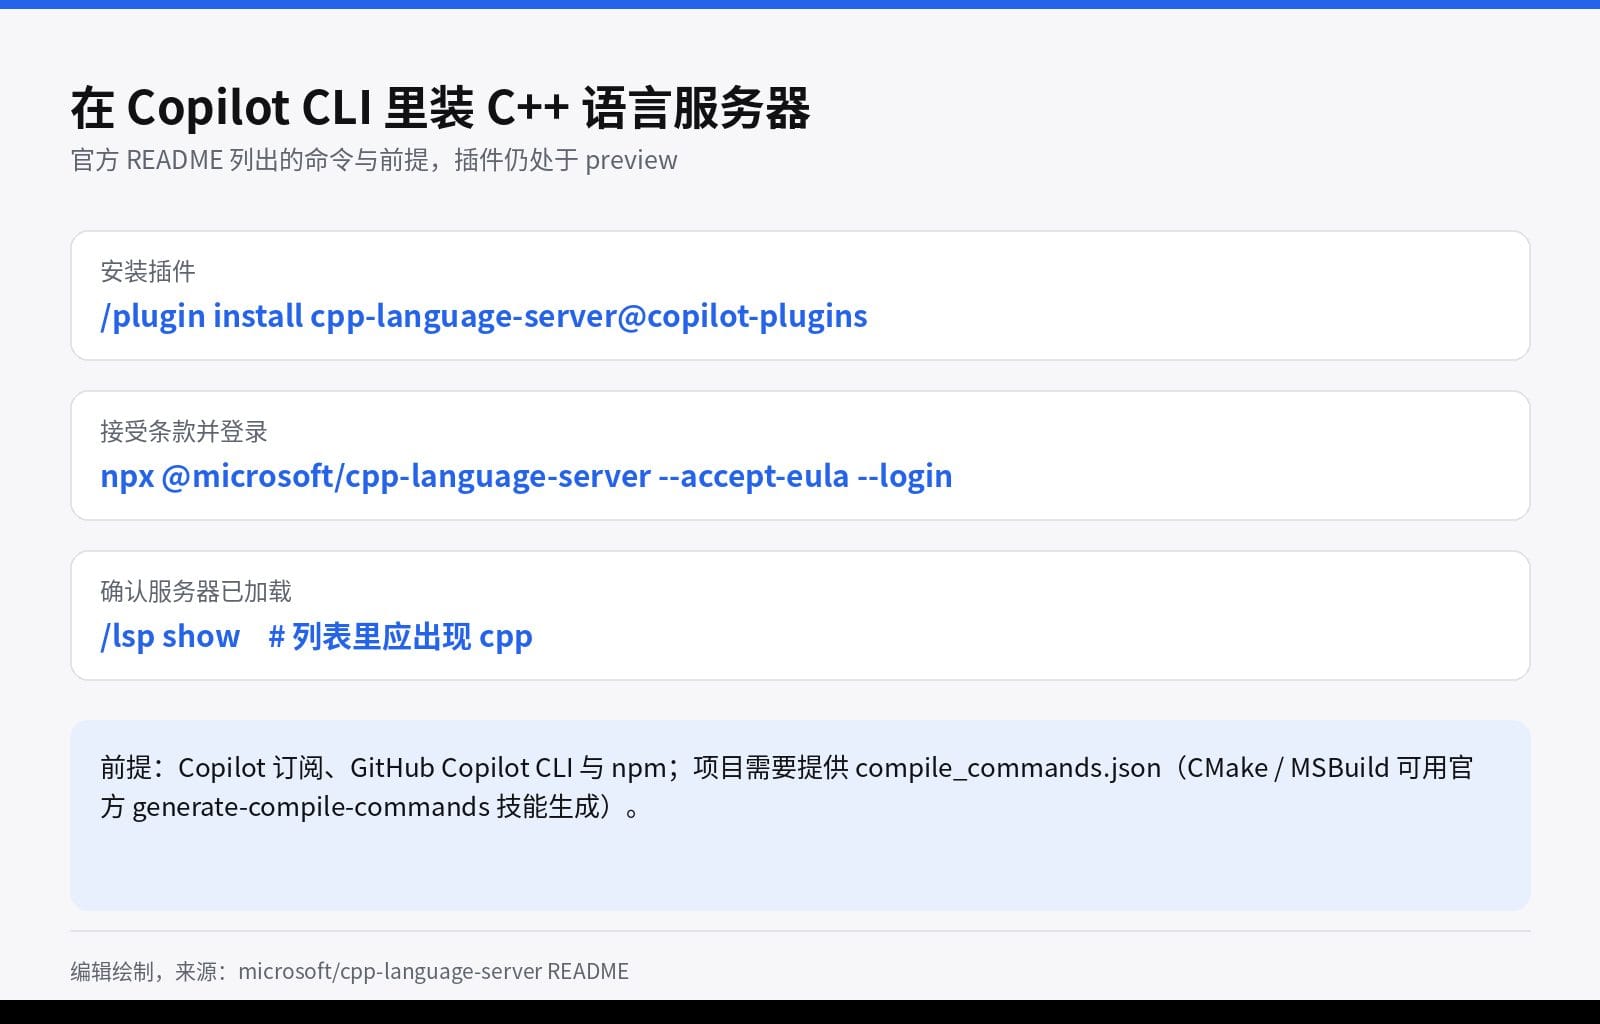
这个语言服务器本身是微软的项目,安装方式写在它的 README 里:在 Copilot CLI 中执行 /plugin install cpp-language-server@copilot-plugins,然后用 npx @microsoft/cpp-language-server --accept-eula --login 接受条款并登录,从项目根目录启动 CLI 后,/lsp show 的列表里应该出现一个 cpp 服务器。前提是 Copilot 订阅、GitHub Copilot CLI 和 npm,另外项目需要提供 compile_commands.json;CMake 或 MSBuild 项目可以用官方提供的 generate-compile-commands 技能生成并完成配置。该项目目前标注为 preview,官方说明后续版本可能变化。
完整工作场景:一次跨模块的调用链排查
设想一个典型的 C++ 现场:你在一个多层仓库里排查某个结构体字段被谁改坏,通过一层封装调用了三个模块。过去的流程是,你在对话里让 agent 去找引用,agent 用文本搜索在几十个头文件里翻,很可能漏掉宏展开和模板特化产生的调用点;你补一轮上下文,它再搜一轮。每次提问都要重新做一遍这件事。
开启 WCI 之后,第一次打开项目时语言服务器就把整个项目的符号关系建好,后面每一次"这个函数在哪被调用、这个接口在哪些平台被实现"都变成查索引。对 agent 来说,变化不是"更聪明了",而是少了一类要走弯路才能完成的子任务:它不必再用搜索去重建编译器早就知道的信息。这也是 GitHub 在原文里强调"包含未被打开的文件"的原因——真正的调用链往往落在你根本没打开过的文件里。
为什么它改变工作流:把"搜索"换成"查表"
代码搜索和符号索引的区别,在小型仓库里感知不到,在大型 C++ 仓库里是数量级差异。搜索是按文本匹配,索引是按编译语义匹配;前者会说"这里有 47 个同名匹配",后者能告诉你"这个定义在哪个文件、被哪几个翻译单元使用"。当 agent 的每一个动作都要先做一次这样的判断时,索引省下的是每一轮的往返。
另一个变化是默认值。WCI 默认开启,意味着升级 Copilot CLI 之后,团队不需要任何配置就会获得这份索引,也不会有配置被忘记打开的问题;但反过来说,本地开发机和 CI 机器会在大仓库上自动承担一次索引构建的开销,这一点往往是团队读到更新说明时最容易忽略的。
限制、边界与人应该在哪儿接管
官方给出的代价写得比较克制但足够明确:索引的初始构建"会花费额外时间并临时增加内存使用,在大型或复杂仓库上尤其明显",并且"在第一次构建之后,它会被复用并动态更新,所以这部分开销主要与初始建立相关"。也就是说,这是笔一次性成本,不是持续税;但对于内存紧张的自托管 runner 或容器化环境,第一次打开大型 C++ 项目的峰值内存需要提前留量。
需要留意的边界还有几条。第一,索引依赖项目的编译数据,compile_commands.json 缺失或过期时,符号解析的覆盖面会打折,构建脚本生成这份文件的方式也需要纳入仓库的日常维护。第二,GitHub 的这条 Changelog 没有给出索引速度、内存占用数字,也没有说明多大规模以上算"大型仓库",更没有说明其他编辑器里的行为,所以这些都需要在自己的仓库上量一次。第三,语言服务器目前仍是 preview。第四,要临时关掉 WCI,需要按语言服务器索引文档修改设置,并且改动之后要重启 Copilot 会话——设置不会在当前会话里立刻生效,这一点容易误判为"关了没用"。
人应该在哪儿接管:把 WCI 当成加速器而不是正确性保证。索引只描述符号之间的关系,不判断这些关系是否符合你的架构约束;涉及跨模块重构、需要在多个团队之间对齐接口的改动,仍然要由人确认边界。
如何试用
先确认版本与前提:Copilot 订阅、GitHub Copilot CLI、npm,然后在项目根目录执行上面三条命令,用 /lsp show 确认 cpp 服务器已经加载。首次打开项目时用 /lsp logs 观察索引进度,同时记录这一次构建的耗时和内存峰值,作为后续判断是否需要在部分仓库关闭 WCI 的依据。反馈渠道是官方的 C++ Language Server 仓库 issue 和 aka.ms/cpp-lsp-survey 问卷。
信息来源
- GitHub Changelog:Faster C++ code intelligence with whole codebase indexing(2026-09-22)https://github.blog/changelog/2026-09-22-faster-c-code-intelligence-with-whole-codebase-indexing
- microsoft/cpp-language-server README(安装、命令、preview 状态)https://github.com/microsoft/cpp-language-server
开发必备:API 全流程管理神器 Apifox
介绍完上文的内容,我想额外介绍一个对开发者同样重要的效率工具 —— Apifox。作为一个集 API 文档、调试、设计、测试、Mock、自动化测试于一体的工具,Apifox 是目前提升研发效率的首选。
如果你正在开发项目,不妨试试其极其友好的界面设计,它完全兼容 Postman 和 Swagger 数据格式,导入数据非常方便,,即使是新手也能很快上手,点击这里即可注册使用。

值得一提的是,除了个人和常规团队使用,针对有高安全合规要求、或需要在内网环境协作的企业,Apifox 还提供了深度定制的私有化部署方案。
获取专属报价与部署方案
 详细的私有化部署系统架构与安全白皮书
 针对您公司规模的专属报价单
 免费的 1v1 专属产品演示 (Demo) 机会

