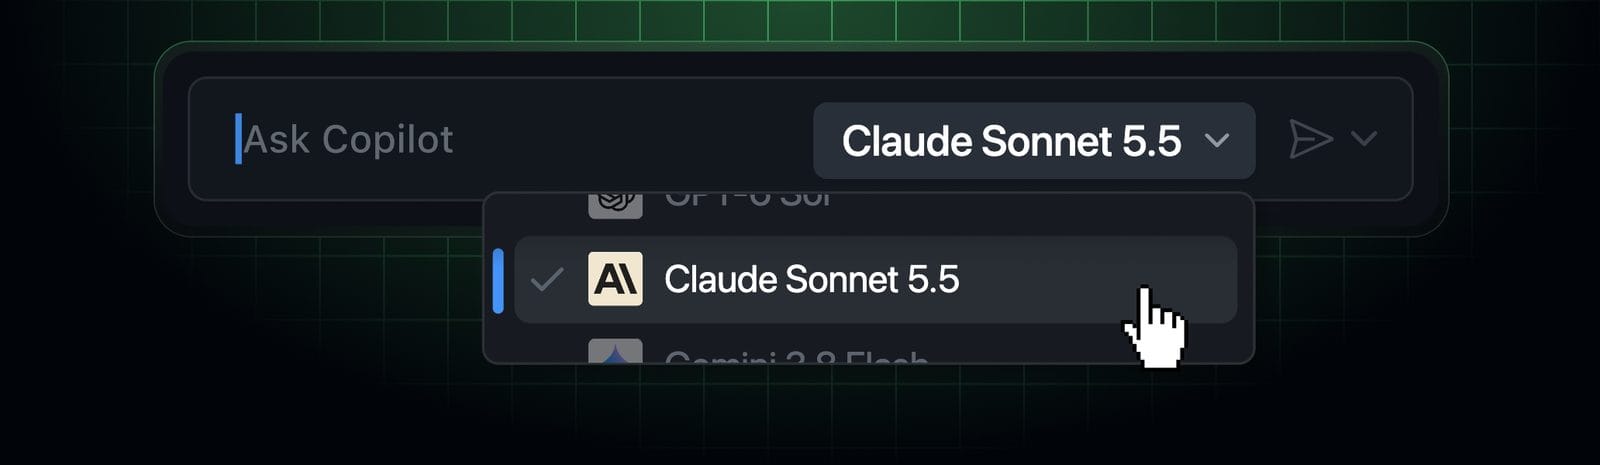
GitHub 在 9 月 28 日的 Changelog 里宣布,Anthropic 的 Claude Sonnet 5.5 已经在 GitHub Copilot 中全面可用。官方把它定位在「范围明确的日常活儿」上——做功能、修 bug——并称早期测试中它在编码任务上与 Claude Sonnet 5 打平,但「用了明显更少的步骤、token 和工具调用」,完成任务也「明显更快」。
这条更新值得单独拿出来讲,是因为它的档位门槛和上一条模型公告不一样:它把新模型放进了 Copilot Pro 这一档,也就是最便宜的那个付费档。对个人开发者来说,这是一次不需要加钱的能力更新;对团队来说,它改变了「用什么模型」这场讨论的起点。这篇文章把可用范围、计费口径和边界拆开说。
发生了什么:覆盖五档,含入门付费档
按公告列出的范围,可以使用 Claude Sonnet 5.5 的档位是 Copilot Pro、Pro+、Max、Business 和 Enterprise。和 9 月 29 日上架的 GPT-6.1 Sol 相比,多出来的就是 Copilot Pro——后者只覆盖 Pro+ 及以上。这个差别在实际使用里很实在:还在个人付费入门档的开发者,这次直接拿到了新模型,而 GPT-6.1 Sol 需要先升档。
可以在模型选择器里切到它的入口包括:Visual Studio Code、Visual Studio、Copilot CLI、GitHub Copilot coding agent、GitHub Copilot 应用、github.com 网页端、iOS 和 Android 上的 GitHub Mobile、JetBrains IDE、Xcode 以及 Eclipse。计费口径与 GPT-6.1 Sol 一致:按 provider list pricing 在使用量计费下结算,公告没有给出 premium request 倍数。
工作流变化:从「换不换得起」变成「换划不划算」
把它放回一条真实链路:开发者提一个「给某个接口加上分页」的需求,agent 需要读现有实现、改 handler、补测试、跑一遍、再开 PR。官方说的「更少的步骤和工具调用」,落在这条链路上就是 agent 少绕几圈——少读一次无关文件,少试一次错误的改法,少调用一次工具。步骤少意味着两件事同时下降:每一轮重新发送的上下文变短,以及需要付费的轮次变少。这两者在使用量计费下是同一个乘数。
把「步骤」再拆细一点会更实用。一个 agent 回合里的步骤通常是:决定要读哪个文件、真正读它、决定改哪里、生成改动、跑测试、根据测试结果决定下一步。官方说 Sonnet 5.5 用了更少的步骤和更少的工具调用,对应的是这条链上的读文件和跑测试次数减少。对开发者来说,可见的变化是同一个需求下 agent 少绕几圈,你需要审核的中间动作也变少——这一点对审核成本比对 token 成本更明显,因为每一步都要人看一眼才能确认它没跑偏。
真正改变的是决策方式。以前个人开发者在入门档里能选的模型有限,讨论的默认前提是「我够不够得着」。现在 Sonnet 5.5 下探到 Pro 档,前提变成了「在我的仓库上它是不是真的更省」。这是一个需要用自己代码去回答的问题,而不是看公告能回答的问题。
算一笔账:list pricing 与缓存读取
公告把计费指向 GitHub 的 models and pricing 文档,没有在正文里给数字。要估算成本,可以借 Claude Code 那一侧的一手信息作参照:Claude Code 2.1.284 的 Changelog 写明 Sonnet 5.5(claude-sonnet-5-5)作为默认 Sonnet 模型,带 1M 上下文,价格为每百万 token 输入 2 美元、输出 10 美元,缓存读取为每百万 token 0.20 美元。
按这组数字做一个粗略的口径推演:假设一条 agent 任务在旧模型上要 20 轮、每轮输入上下文平均 30 万 token、输出 2 千 token,输入侧就是 600 万 token。如果新模型把轮数压到 15 轮,输入侧降到 450 万 token,省下的是四分之一。若其中大部分输入能命中缓存,按 0.20 美元每百万 token 计,缓存部分的成本本身已经很低,真正的节省来自少跑的那几轮里无法命中缓存的新增内容。这个推演只说明量级,实际数字必须用你自己仓库的上下文长度和缓存命中率去替换——Copilot 侧的结算价仍以 GitHub 文档为准,不能直接套用 Claude Code 的价目表。
需要说清楚的是,这是 Claude Code 侧的定价,不是 Copilot 侧的结算价——Copilot 走的是 provider list pricing 加上它自己的使用量计费规则,具体数字仍以 GitHub 文档为准。但缓存读取与输入的价差(0.20 对 2 美元,差十倍)解释了一件事:为什么「更少的步骤」在长任务里节省得比直觉更多。多步 agentic 任务每轮都要重发上下文,能被缓存命中的部分越便宜,减少轮数带来的收益就越大。
限制,以及人必须在哪一步接管
这份公告的信息边界同样清楚:没有给出上下文窗口大小在 Copilot 侧的落地形态,没有 premium request 倍数,也没有独立的第三方基准。所有关于「更少步骤」「明显更快」的表述都来自 GitHub 产品方的早期测试,需要在自己的仓库上验证。铺开是渐进的,各入口出现的时间可能不一致,看不到属于预期状态。
另外要区分两件事:Sonnet 5.5 在 Copilot 里可用,和 Claude Code 把 Sonnet 5.5 设为默认 Sonnet 模型,是两个产品的两个独立变更,各有各的来源和生效范围。前者管的是你在 Copilot 的模型选择器里能不能选到它,后者管的是 Claude Code 在没有指定模型时用哪个。不要因为看到其中一条,就以为另一条也同步生效了。
需要人接管的判断还是那一句:官方说的效率优势是在「范围明确的日常活儿」上测出来的。如果你的任务本身是模糊的、需要大量探索的,步骤数的比较前提就不成立。合理的做法是挑一条重复度高、有测试覆盖的任务链,切过去对比 token 消耗和返工率,再决定要不要把它写成团队的默认值。
如何试用
个人用户:Copilot Pro 及以上档位,在任意支持的入口打开模型选择器,选中 Claude Sonnet 5.5 即可。企业用户:先由管理员在 Copilot 设置的 model policy 中确认该模型已启用,再在模型选择器中选择——企业侧的默认启用行为是「新模型自动启用,除非管理员关闭了全局默认或显式禁用了这个模型」。
信息来源
GitHub Changelog《Claude Sonnet 5.5 in GitHub Copilot》,2026 年 9 月 28 日:
https://github.blog/changelog/2026-09-28-claude-sonnet-5-5-in-github-copilot/
Anthropic《Claude Code CHANGELOG》2.1.284 条目(Sonnet 5.5 定价与上下文,为 Claude Code 侧口径):
https://github.com/anthropics/claude-code/blob/main/CHANGELOG.md
HiFox:将 Agent 变成真正的队友
另外,我们也在思考,AI 如何从个人提效走进团队协作。
HiFox 是一个让人和 AI Agent 在同一个工作现场协作的平台:你可以像给同事分派任务一样指派 Agent,在任务看板中跟踪进度、查看结果,让 Agent 成为团队里的队友。
👉 立即体验 HiFox:https://hifox.com
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,
欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
