摘要:2026 年 9 月 28 日,GitHub 宣布 Claude Sonnet 5.5 在 Copilot 全面可用,覆盖 VS Code、Visual Studio、Copilot CLI、Copilot coding agent、Copilot app、github.com、GitHub Mobile(iOS 与 Android)、JetBrains IDE、Xcode、Eclipse 共 11 个入口,Pro、Pro+、Max、Business、Enterprise 都能选,按用量、按模型供应商标价结算。Anthropic 同日发布该模型,称输出速度比 Sonnet 5 快 30% 以上、多数任务成本最多低 30%,但每百万 token 标价不变。对企业管理员来说,真正需要现在就做决定的是模型策略里那个默认开关。
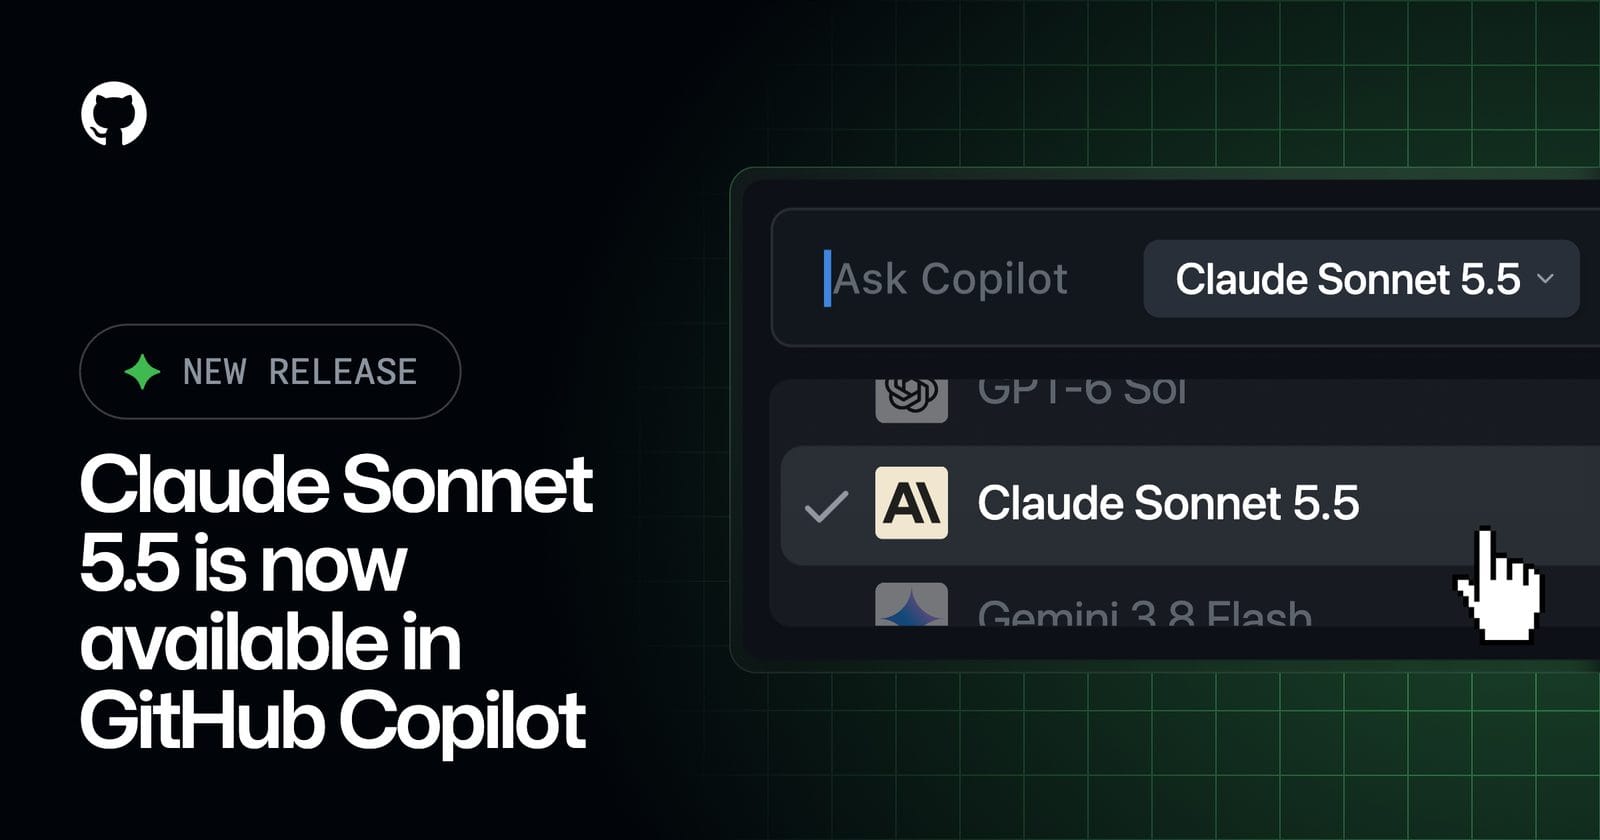
这不是一次预览,而是一次 GA。GitHub 给它的定位是「范围明确的日常工作,比如实现功能和修 bug」,并从 9 月 28 日起按批次逐步推送到各个入口——如果你在模型下拉框里暂时看不到它,官方给出的说法是再等等。
更值得注意的是 GitHub 自己的早期测试结论:Claude Sonnet 5.5 在编码任务上追平 Claude Sonnet 5,但用掉的步骤、token 和工具调用明显更少,任务完成得也更快。在按用量结算的 Copilot 里,这句话同时指向两件事——每一次 agent 回合变得更短,以及账单的口径需要重新算一遍。
下面把「能选什么」「谁来付」「谁来决定」这三件事分开说清楚,因为这一次它们分别落在了不同的地方。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。

发生了什么:11 个入口同日可选,费用按用量结算
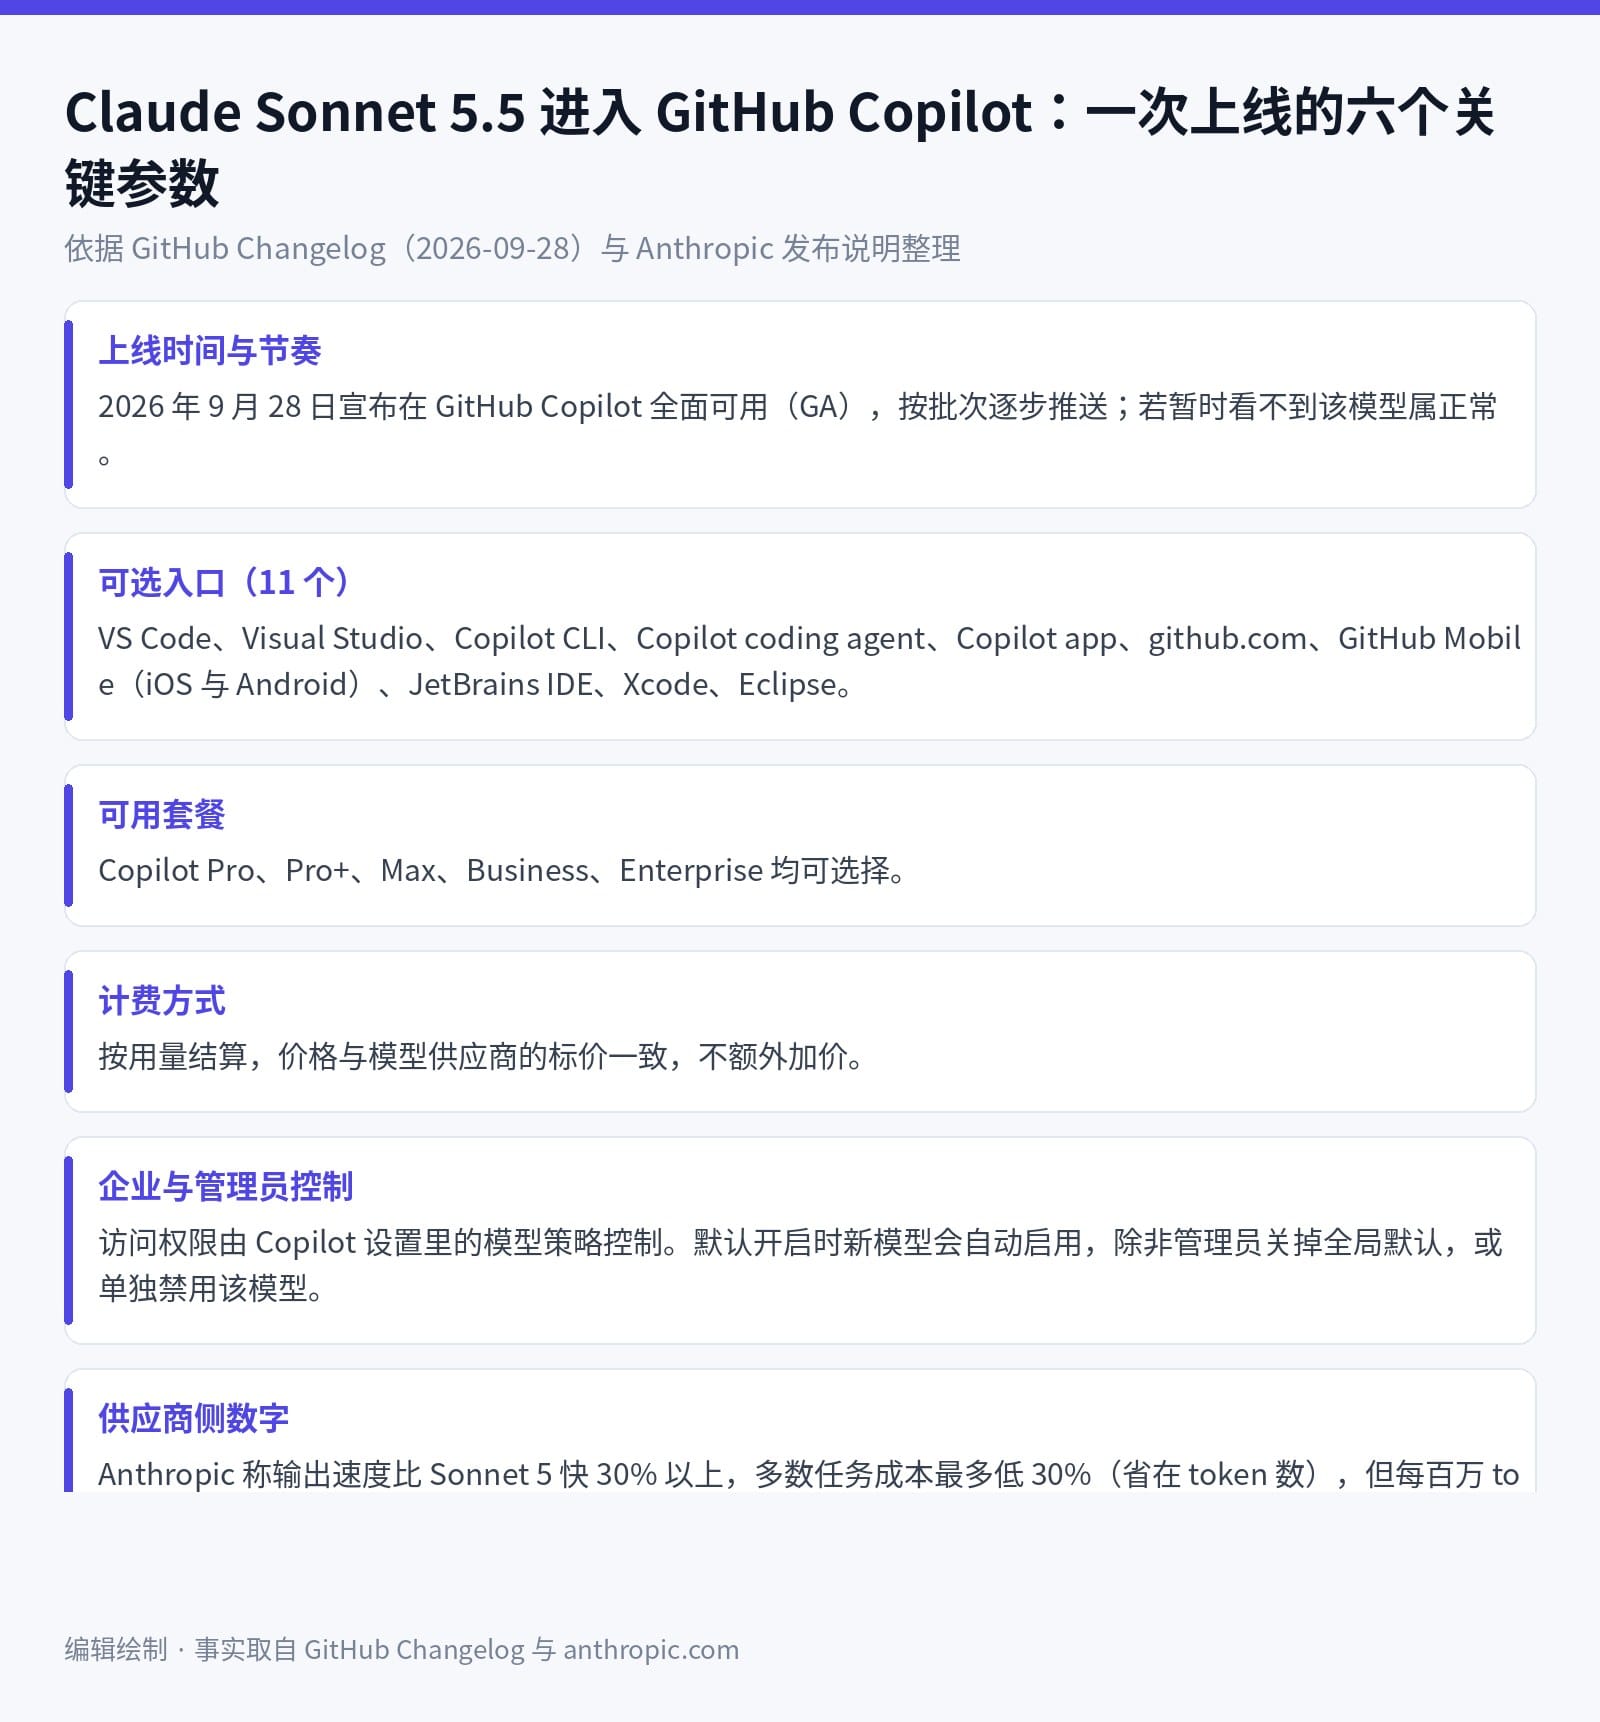
GitHub 在 9 月 28 日的 Changelog 里写明,Claude Sonnet 5.5 已在 GitHub Copilot 全面可用。可选入口覆盖 VS Code、Visual Studio、Copilot CLI、Copilot coding agent、Copilot app、github.com、GitHub Mobile 的 iOS 与 Android 客户端、JetBrains IDE、Xcode 和 Eclipse,合计 11 个。套餐侧没有做限制:Copilot Pro、Pro+、Max、Business、Enterprise 都在可用范围内。
计费方式值得单独记一笔:它是按用量结算,价格与模型供应商的标价一致,也就是说 GitHub 在这一层没有加价。同一天 Anthropic 发布了这个模型,给出的数字是输出速度比 Sonnet 5 快 30% 以上,多数任务成本最多降低 30%——但这个 30% 不是降价,而是「同样的活儿用的 token 更少」。每百万 token 的标价没有动:输入 2 美元、输出 10 美元、缓存读取 0.20 美元、缓存写入 2.50 美元。
把两个来源的信息叠在一起看,逻辑就清楚了:标价不变、单任务 token 变少,所以成本下降发生在用量那一侧,而不是价目表那一侧。这也意味着,如果你的团队是按席位付费而非按用量付费,账面上不会立刻看到变化。
一个具体场景:从「顺手修个 bug」到账单口径
设想一个后端小组在 VS Code 里处理一个空指针问题。过去他们会在模型下拉框里选一个熟悉的模型,让 Copilot 读几个文件、定位调用链、给出补丁。这个流程里,agent 的回合数取决于它需要多少次工具调用才能把上下文拼齐——而「步骤、token 和工具调用更少」正好砍在这一段。
第二个场景发生在 CI 里。如果同一个任务交给 Copilot coding agent,模型消耗就会直接进用量账。这时「单任务成本下降」不再是体感,而是可以按任务数乘出来的数字。团队真正要做的是换一个对比口径:不要比每百万 token 的单价,要比完成任务的总消耗。
第三个场景是反馈路径。GitHub 在这条公告里把反馈入口指向了 Copilot 的社区讨论区,也就是说这个模型的行为还在调整期,早期使用者的反馈是有出口的。
为什么这会改变工作流:入口的「能选」和策略的「能开」被拆开了
第一个变化是入口数量本身。同一个模型同时出现在 IDE、CLI、编码 agent、网页端和移动端,意味着团队不必再为不同入口维护各自的模型选择——模型在哪儿用,跟你平时在哪儿写代码一致。
第二个变化更关键,也更容易被忽略:模型策略是集中在 Copilot 设置里管的,而不是每个入口各管各的。GitHub 明确写了默认模型启用策略的行为——新模型会自动启用,除非管理员关掉了全局默认,或者单独把某一个模型禁用掉。换句话说,在管理员没有主动做决定的情况下,Sonnet 5.5 会自己出现在组织里。
这跟 9 月 24 日 GitHub 把 Copilot 功能默认开启给 Business 与 Enterprise 是同一套治理思路,但不是同一件事:那次动的是功能开关,这次动的是模型清单。对管理员来说,需要现在就确认的是那个全局默认开关当前处于什么取值,而不是等下个季度的评审会。
第三个变化发生在成本结构上。模型供应商标价不变、单任务消耗下降,结果是用量结算的对象变得更划算,但预算仍然是随使用量走的浮动值。对于习惯按席位做预算的团队,这是个需要重新对齐的口径。
限制、边界与人应该在哪儿接手
Anthropic 自己在发布说明里划了线:尽管 Sonnet 5.5 在部分基准上追平甚至超过 Opus 5.5,但 Opus 5.5 在「复杂、开放式」的工作上仍然明显更强。Sonnet 5.5 的定位是限定范围的日常任务,不要因为几个数字好看就把复杂任务的主力模型换掉。
官方脚注里还有一条值得记的边界:在 FrontierCode 1.1 上,Sonnet 5.5 在 Max 推理档位反而低于 Xhigh 档位,原因被描述为审阅类编辑过于宽泛。这说明「把推理档位拉到最高」不总是最优解,档位选择需要按自己的场景验证,而不是默认拉满。
迁移侧有一个容易踩的细节:如果调用方关闭了 thinking,Anthropic 要求先切换到 between_tools 设置再迁移。安全侧则有两处实质变化——这是第一个带网络能力防护与回退的 Sonnet,更高风险的网络任务会回退到 Sonnet 5;也是第一个带分类器防止推理提取的 Sonnet。生物学防护与 Sonnet 5 相同,官方同时提示部分微生物学与病毒学请求可能被误判,做相关方向的团队需要预留人工复核。
人的接管点有三个:管理员要在模型策略里明确 Sonnet 5.5 是开还是关;团队要决定哪些任务从 Opus 类模型迁到 Sonnet 类模型;做安全与生命科学方向的团队要把误判复核流程补上。
如何试用
在支持的入口把模型下拉框切到 Claude Sonnet 5.5 即可,看不到就等逐步推送完成。
企业版与商业版管理员:进入 Copilot 设置的模型策略,确认该模型的启用状态,尤其是全局默认开关当前的取值,避免默认开启带来未经评审的用量。
API 调用方:平台 ID 是 claude-sonnet-5-5,AWS、Google Cloud、Azure 上均可调用,支持零数据保留。关闭 thinking 的调用方,迁移前先切到 between_tools。
按 Anthropic 的说法,Haiku 5.5 将在未来几周加入这个家族,届时这个模型档位的选择会再变一次。
信息来源
- GitHub Changelog:Claude Sonnet 5.5 in GitHub Copilot(2026-09-28,Release)— https://github.blog/changelog/2026-09-28-claude-sonnet-5-5-in-github-copilot/
- Anthropic:Introducing Claude Sonnet 5.5(2026-09-28)— https://www.anthropic.com/claude-sonnet-5-5
- GitHub Docs:Supported models for GitHub Copilot(模型清单与模型策略)
HiFox :将 Agent 变成真正的队友
另外,我们也在思考,AI 如何从个人提效走进团队协作。
HiFox 是一个让人和 AI Agent 在同一个工作现场协作的平台:你可以像给同事分派任务一样指派 Agent,在任务看板中跟踪进度、查看结果,让 Agent 成为团队里的队友。
👉 立即体验 Hifox:https://hifox.com
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。