Claude Sonnet 5.5(claude-sonnet-5-5,2026 年 9 月 28 日发布)与 Sonnet 5 同价:每百万输入 token $2、每百万输出 token $10,并使用相同的分词器。它强得多,Anthropic 称其速度提升 30% 以上。在发布表格中,Terminal-Bench 4.0 从 10.3% 升至 70.6%,CursorBench 4.0 从 34.1% 升至 55.5%,OSWorld 2.1 从 57.0% 升至 80.1%。问题出在 API 上。五种在 Sonnet 5 上正常工作的请求结构现在会返回 400,另有一项变更会在不报错的情况下改变响应结构。结论:可以升级,但先修好这六处。
下文逐一给出每项破坏性变更、确切的报错信息以及修改前后的 JSON,最后是一份检查清单。规格详见什么是 Claude Sonnet 5.5;上一次代际跃迁见 Claude Sonnet 5 vs Sonnet 4.6。Apifox 可以在你测试时把新旧请求并排保留。
Sonnet 5 与 Sonnet 5.5 一览
| Claude Sonnet 5 | Claude Sonnet 5.5 | |
|---|---|---|
| 每百万 token 价格(输入 / 输出 / 缓存读取) | $2 / $10 / $0.20 | $2 / $10 / $0.20 |
| 上下文与输出 | 100 万上下文 | 100 万上下文,128K 输出 |
接受的 thinking.type |
adaptive, disabled |
adaptive, between_tools |
默认 display |
omitted |
omitted |
| Effort 等级 | low 到 max |
名称相同但已重新校准;API 默认 high |
| 最小可缓存提示词 | 1,024 token | 512 token |
| 按消息设置 effort、对话中途的 system 消息 | 否 | 是 |
强制 tool_choice |
支持 | 400 错误 |
| Opus 风格的 cyber 安全防护 | 否 | 是;高风险的 cyber 请求会回退到 Sonnet 5 |
| thinking 块 | 不校验对话 | 绑定模型、对话和账号 |
| Terminal-Bench 4.0 | 10.3% | 70.6% |
| CursorBench 4.0 | 34.1% | 55.5% |
| FrontierCode 1.1 (Main) | 42.4% | 46.2% (max), 52.1% (xhigh) |
| GDPval-AA v2.1 (Elo) | 1449 | 1844 |
| OSWorld 2.1(部分) | 57.0% | 80.1% |
| HLE(带工具) | 54.9% | 64.5% |
| 退役 | 仍作为 cyber 回退模型继续提供 | 不早于 2027 年 9 月 28 日 |
Terminal-Bench、HLE 和 OSWorld 由 Anthropic 运行;CursorBench 由 Cursor 运行,FrontierCode 由 Cognition 运行,GDPval-AA 由 Artificial Analysis 运行。Artificial Analysis 自己跑的 Terminal-Bench 结果为 63.6% 对 14.1%,可见差距依然成立。FrontierCode 有两个 5.5 的数字,是因为在 max 档下它更常展开 review 子代理,而该基准测试会惩罚超出范围的改动。详见 Claude Sonnet 5.5 benchmarks。
五项破坏性变更
对于在 Sonnet 5 上运行正常的代码,每一项都会返回 400 invalid_request_error。
1. thinking: disabled 已被移除,请改用 between_tools
Sonnet 5.5 会拒绝 thinking: {"type": "disabled"}:
"thinking.type.disabled" is not supported for this model. Use "thinking.type.between_tools" for the lowest thinking setting, or "thinking.type.adaptive" and "output_config.effort" to control thinking behavior.
请发送最低档设置 between_tools。它会跳过前置思考;工具调用之间的进度说明仍会以 thinking 块返回,你需要原样回传。它仅在 low、medium 或 high effort 下可用,不接受其他字段(display、budget_tokens 或 block_binding 都会返回 400),并且会锁定整个对话的 effort。
// Before (claude-sonnet-5)
{"model": "claude-sonnet-5", "max_tokens": 16000,
 "thinking": {"type": "disabled"},
 "output_config": {"effort": "xhigh"}}

// After (claude-sonnet-5-5)
{"model": "claude-sonnet-5-5", "max_tokens": 16000,
 "thinking": {"type": "between_tools"},
 "output_config": {"effort": "high"}}
如果你需要 xhigh 或 max,请省略 thinking,让自适应思考生效。
2. 强制 tool_choice 会返回 400
tool_choice 设为 any 或 tool 会失败,在 token 计数接口上也是如此:
tool_choice: type "tool" and "any" are not supported for this model.
请发送 auto,把工具标记为 strict: true(每个 object 都需要 additionalProperties: false),并在提示词中说明何时使用它。模型现在可以选择改用文本回复,因此要处理没有工具调用的回合。
// Before (claude-sonnet-5)
"tool_choice": {"type": "tool", "name": "get_weather"}

// After (claude-sonnet-5-5)
"tools": [{"name": "get_weather",
  "input_schema": {"type": "object",
    "properties": {"location": {"type": "string"}},
    "required": ["location"], "additionalProperties": false},
  "strict": true}],
"tool_choice": {"type": "auto"},
"messages": [{"role": "user",
  "content": "What's the weather in Paris? Use the get_weather tool."}]
每个请求最多 20 个 strict 工具。在 Amazon Bedrock 上,Sonnet 5.5 不支持 strict 工具:请发送 auto 但不带 strict,并在代码中校验输入。
3. thinking 块与模型、对话和账号绑定
每个 Sonnet 5.5 thinking 块都会对其之前的所有内容签名:system、tools 以及更早的消息。对于在 2026 年 8 月 31 日(00:00 UTC)当天或之后创建的账号,编辑后再回放某个块会在 Claude API、Bedrock 和 Google Cloud 上返回 400:
messages.1.content.0: Invalid `signature` in `thinking` block. The block is bound to a different conversation. Remove the block, or set `thinking.block_binding.prefix_mismatch_behavior` to "drop_block".
较旧的账号默认不强制执行这一规则,因此在旧密钥上跑通并不能说明问题。请保持对话只追加,改用对话中途的 system 消息来更改指令或工具。如果必须编辑,请发送 anthropic-beta: thinking-binding-controls-2026-08-01 并丢弃不匹配的块:
"thinking": {"type": "adaptive",
  "block_binding": {"prefix_mismatch_behavior": "drop_block"}}
这只在自适应思考下有效;使用 between_tools 时,需要从被编辑的那一轮起去掉 thinking 块。Sonnet 5.5 可以读取来自 Sonnet 5、Opus 4.8、Haiku 4.5 及更早版本的块;它会丢弃 Opus 5、Opus 5.5、Fable 和 Mythos 的块,以及其他账号的 Sonnet 5.5 块,且不会让请求失败。没有其他模型能读取它的块。参见 Claude Fable 5.1 preserved thinking。
4. computer_20251124 在 Claude API 和 Google Cloud 上会失败
在这两个平台上,computer use 需要使用新的工具集。错误信息开头是:
'claude-sonnet-5-5' does not support tool types: computer_20251124.
// Before (claude-sonnet-5)
"tools": [{"type": "computer_20251124", ...}]

// After (claude-sonnet-5-5, Claude API and Google Cloud)
"tools": [{"type": "computer_toolset_20260801"}]
请去掉旧的 computer-use beta header,并更新你的循环以处理成员 tool_use 块、批量操作以及结果上的 toolset_name。Bedrock 仍然接受 computer_20251124;computer_20250124 在所有平台上都会失败。
5. 部分 advisor 组合会被拒绝
使用 advisor 工具(beta)时,Sonnet 5.5 作为执行方只接受 Opus 5、Opus 5.5、Sonnet 5.5、Fable 5、Fable 5.1、Mythos 5 或 Mythos 5.1 作为 advisor。Sonnet 5、Opus 4.8 和 Opus 4.7 作为 advisor 现在会返回 400。建议还会以加密形式作为 advisor_redacted_result 块返回,因此解析建议文本的代码什么也拿不到。
静默变更:工具调用之间的文本移入 thinking 块
这一项不会让任何东西报错。在 Sonnet 5 上,工具调用之间的说明会以 text 返回。在 Sonnet 5.5 上,超过一两句话的内容会以进度更新 thinking 块的形式返回,而在默认的 display: "omitted" 下该块为空。那些流式展示这些说明的 Agent 界面会变得一片安静,且没有任何报错。三种修复方式:
display: "updates"(自适应思考,beta headerthinking-display-updates-2026-08-18)只返回更新内容。不带该 header 会被拒绝。display: "summarized"会把更新内容与推理摘要混在一起。between_tools会返回文本,无需设置display。
// Header: anthropic-beta: thinking-display-updates-2026-08-18
"thinking": {"type": "adaptive", "display": "updates"}
无需改代码的行为变更
这些不会让请求失败,但会改变输出和成本。提示词指南给出了修复方法。
- Effort 已重新校准。名称相同,思考量不同。请重新做一遍扫描:从
high开始,定义明确的 agentic coding 用medium,聊天用medium或low;把xhigh和max留给有可量化收益的场景。 - 在请求之间更改顶层
effort会使提示词缓存失效。请改用 beta 的按消息 effort。 - 它几乎每次回复前都会思考(从
medium起)。请降低 effort;靠提示词让它少思考并不可靠。 - 它会较早请示确认,在长时 agentic 任务下的
low和medium档位如此。 - 它会添加未经要求的测试、文档和文件,在
xhigh和max下还会添加 reviewer 子代理。Anthropic 建议的提示词把max下的会话成本削减了约三分之一。 - 拒答更多。它是首个带有 Opus 风格 cyber 安全防护的 Sonnet。拒答是 HTTP 200,带有
stop_reason: "refusal"和一个stop_details类别;Claude API 上的 beta 服务端回退(fallbacks: "default")会把cyber和frontier_llm类型的拒答在 Sonnet 5 上重试。 - 采样参数。非默认值的
temperature、top_p或top_k会返回 400。Anthropic 把这一条列在从 Sonnet 4.6 及更早版本迁移的说明下,所以你很可能早已移除它们。
单任务成本:价格相同,每个结果的花费更低
Anthropic 的发布博客称,在其测试中 Sonnet 5.5「每个任务的成本比上一代最多低 30%」。价格完全相同,因此节省来自更少的 token 和步骤。它的分 effort 图表显示,5.5 在较低 effort 下就能胜过 Sonnet 5 的最佳成绩:
| 基准测试(Anthropic 的图表) | Sonnet 5.5 | Sonnet 5,最佳成绩 |
|---|---|---|
| Terminal-Bench 4.0 | medium 下 28.8%,$0.83 | max 下 10.3%,$11.62 |
| FrontierCode 1.1 | high 下 49.4%,$0.42 | xhigh 下 42.7%,$10.07 |
| CursorBench 4.0 | low 下 35.8%,$0.50 | max 下 34.1%,$7.17 |
CursorBench 的成本是 Anthropic 按目录价估算的。另一面是 max:根据 OfficeChai 对 Artificial Analysis 数据的报道,Sonnet 5.5 在 max 下每个 index 任务约使用 193,000 个输出 token,单任务成本比 Sonnet 5 高约 50%。节省只存在于 high 及更低档位;参见 Claude Sonnet 5.5 定价。
迁移检查清单
把 claude-sonnet-5 换成 claude-sonnet-5-5,然后执行 Anthropic 迁移指南中的六项检查:
- 把
disabled替换为between_tools,effort 取high或更低。 - 把强制的
tool_choice换成auto、strict: true和一句提示词(在 Bedrock 上改为在代码中校验)。 - 保持历史只追加;需要变更时使用对话中途的 system 消息。
- 在 Claude API 和 Google Cloud 上把 computer use 迁到
computer_toolset_20260801。 - 选择受支持的 advisor,并停止解析建议文本。
- 如果你的界面会展示工具调用之间的文本,请设置
thinking.display。
然后重新做一遍 effort 扫描。Claude Code 可以自动完成迁移:
/claude-api migrate this project to claude-sonnet-5-5
Opus 对应的迁移是 Claude Opus 5.5 vs Opus 5。
在 Apifox 中把这次迁移变成回归测试
在 Apifox 中,把三个指向 https://api.anthropic.com/v1/messages 的请求保存在同一个项目、同一个环境下:
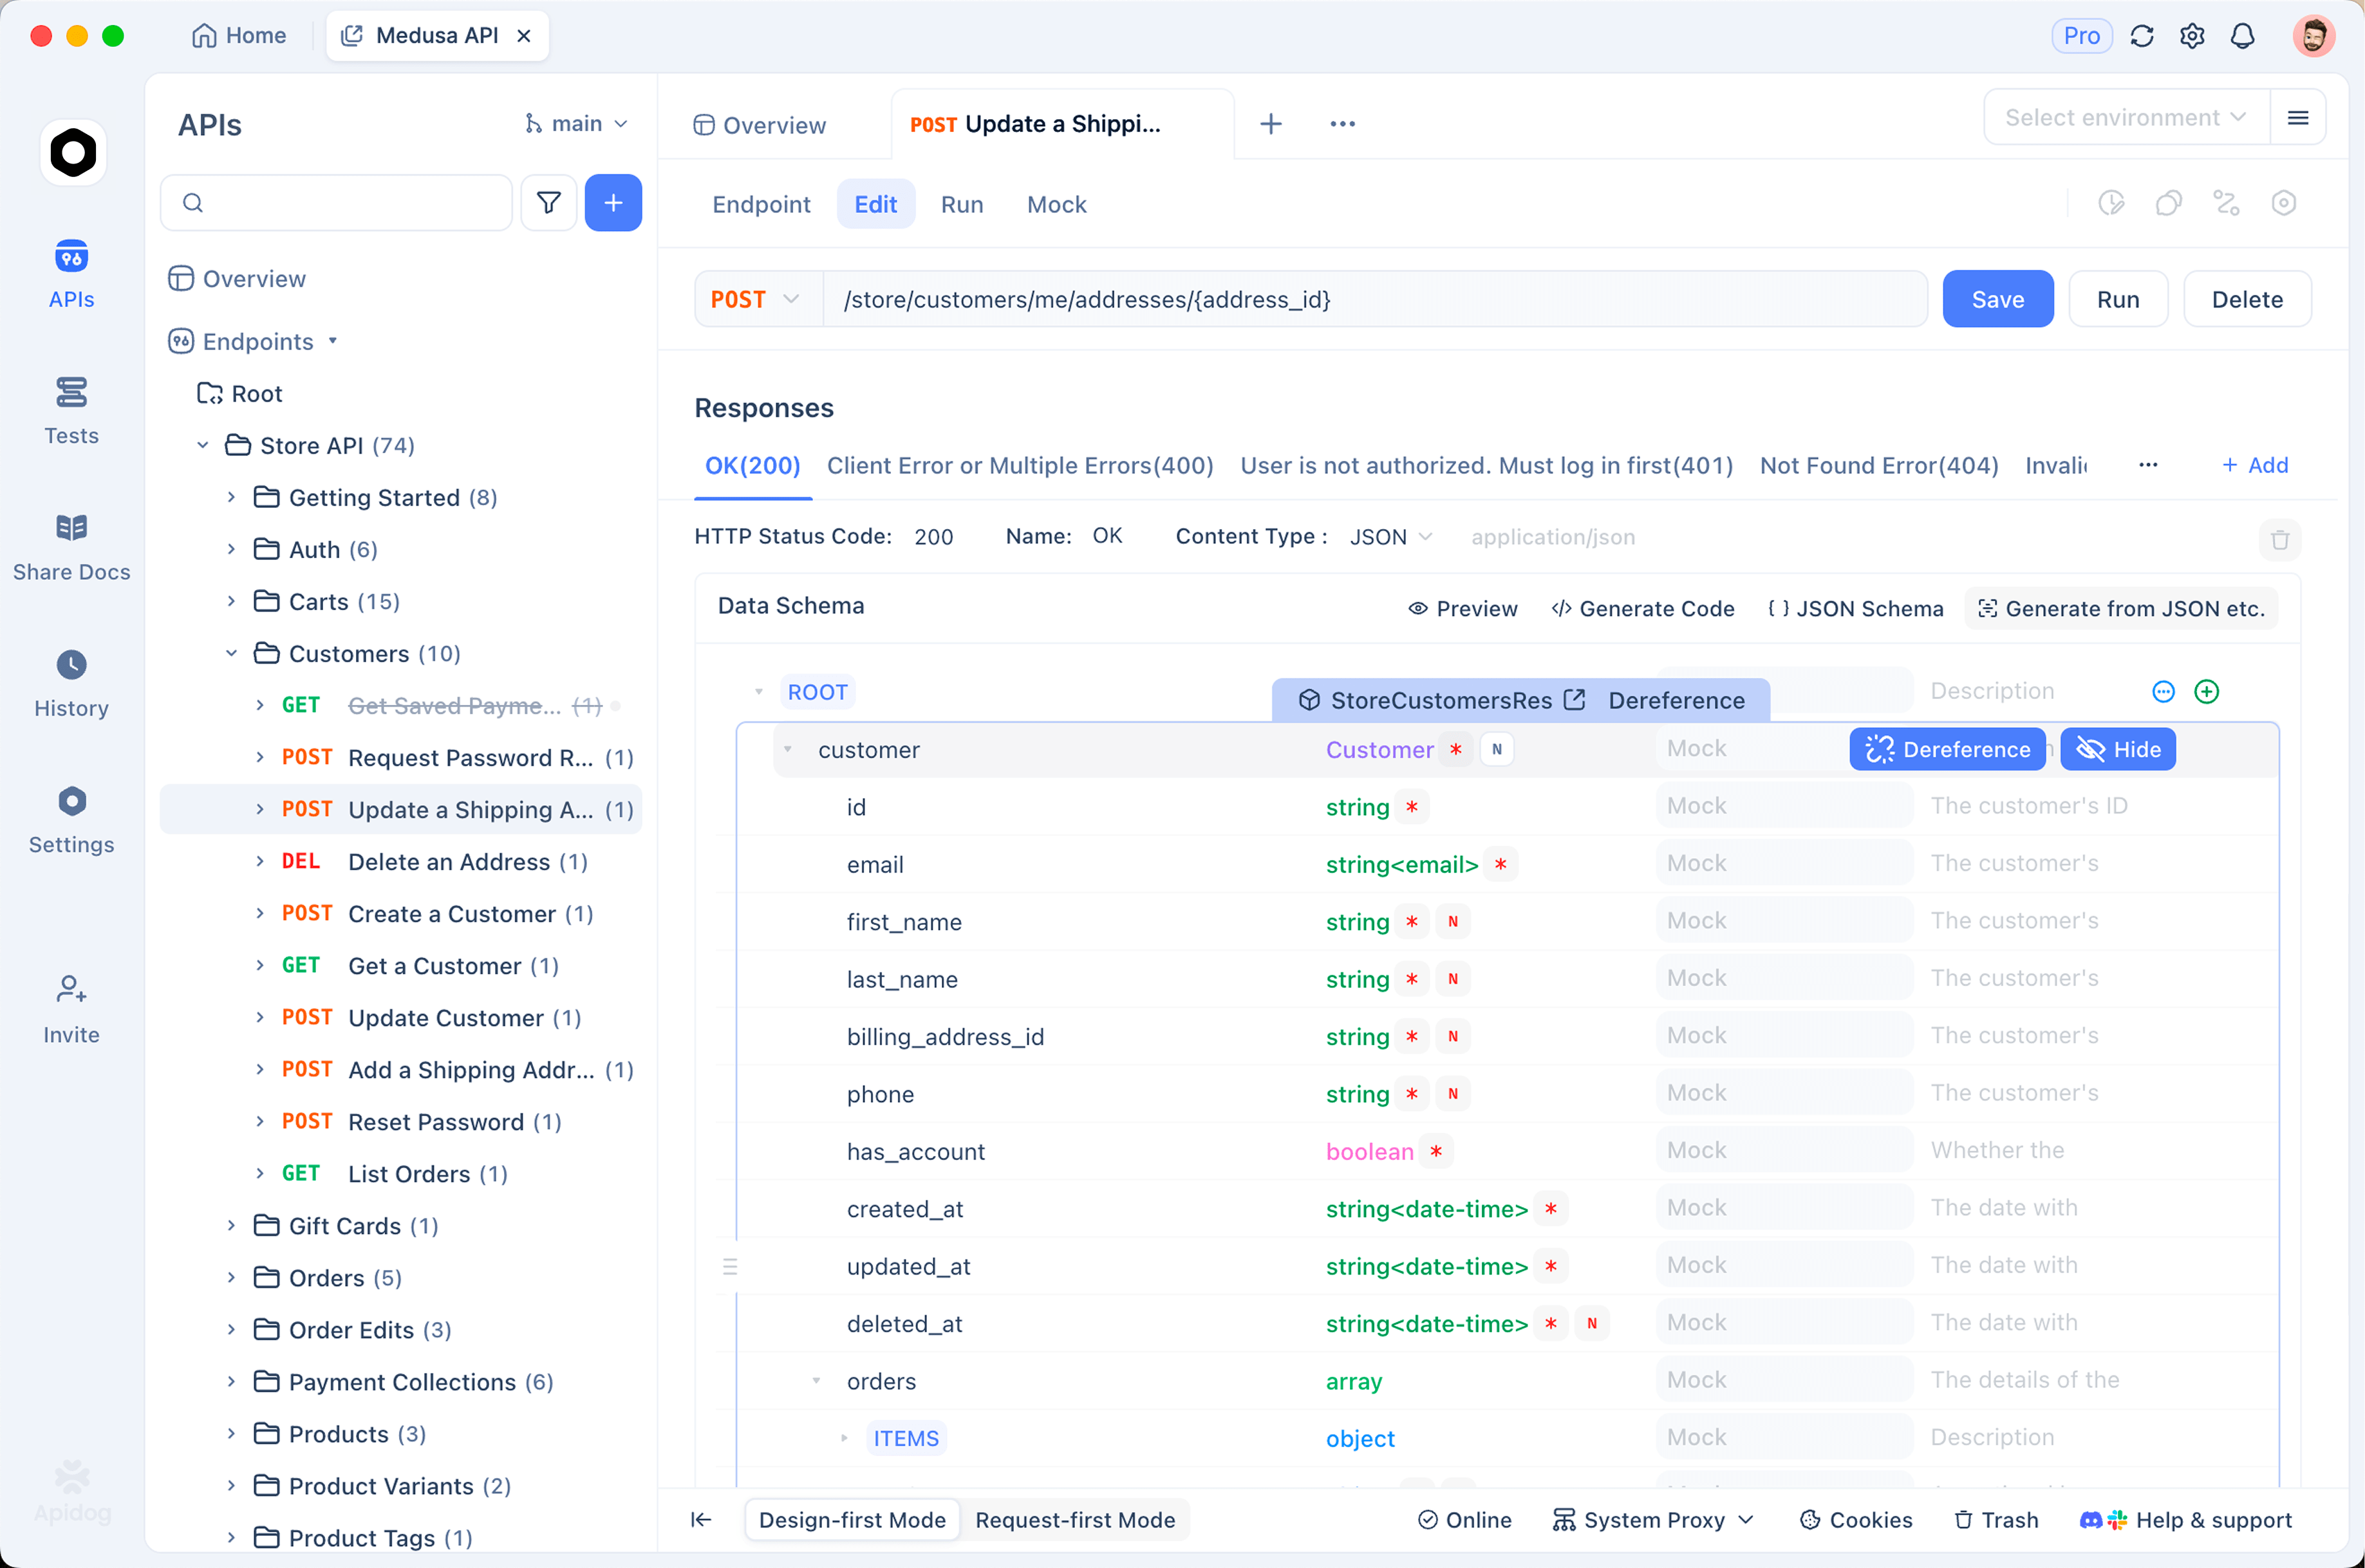
- 基线:你当前 Sonnet 5 的 body。
- 旧 body、新模型:只把
model改成claude-sonnet-5-5。断言状态码为 400,且错误信息中提到between_tools或tool_choice。 - 迁移后:修好的 body。断言状态码为 200、
stop_reason不是refusal或max_tokens,并且工具请求会返回tool_use块。
把 ANTHROPIC_API_KEY 放在环境中,并以 {{ANTHROPIC_API_KEY}} 的形式在 x-api-key header 中引用它。对比不同 effort 下的 usage.output_tokens,得出你自己的单任务成本。保存为测试场景后,回退到 disabled 的回归会在运行中失败,而不是在生产环境失败。请求基础:如何使用 Claude Sonnet 5.5 API。
常见问题
Claude Sonnet 5.5 比 Sonnet 5 更贵吗?不会。两者都是每百万 token $2/$10,缓存读取 $0.20,且分词器相同。
为什么在 Sonnet 5.5 上会报「thinking.type.disabled is not supported」?disabled 已被移除。请发送 thinking: {"type": "between_tools"},effort 取 low、medium 或 high,且不要带其他 thinking 字段。
Sonnet 5 的对话能沿用到 Sonnet 5.5 吗?可以。Sonnet 5.5 能读取 Sonnet 5 的 thinking 块。切回去则会丢失它们:没有其他模型能读取 Sonnet 5.5 的块。
我应该把所有东西都迁到 Sonnet 5.5 吗?对大多数工作负载来说,是的。要留意与 cyber 相关的工作,它可能会回退到 Sonnet 5,以及 Bedrock 上的工具调用,那里会失去 strict 模式。我们的 Claude Sonnet 5 指南介绍了你正在离开的那个模型。
下一步
把 Sonnet 5 的请求和它的 5.5 版本并排保存,确认那个 400 报错,修好它,等修复通过后再切流量。
HiFox:将 Agent 变成真正的队友
另外,我们也在思考,AI 如何从个人提效走进团队协作。
HiFox 是一个让人和 AI Agent 在同一个工作现场协作的平台:你可以像给同事分派任务一样指派 Agent,在任务看板中跟踪进度、查看结果,让 Agent 成为团队里的队友。
👉 立即体验 HiFox:https://hifox.com
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,
欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
