Claude Sonnet 5.5 在 Claude API 上的价格是每百万输入 token $2、每百万输出 token $10,与 Sonnet 5 相同。缓存读取为每百万 $0.20,批处理 API 把两项费率都减半为 $1 和 $5,完整的 1M 上下文窗口按标准费率计费,并且不提供快速模式。Sonnet 5 原定 9 月 1 日涨到 $3/$15 的计划已取消,所以 $2/$10 现在就是标准价格。
本指南列出 Claude Sonnet 5.5 价格的每一项明细,用三道成本算例展示计算过程,并解释为什么 effort 对你的账单影响比每 token 费率更大。刚接触这个模型?请先从什么是 Claude Sonnet 5.5 开始,或阅读如何免费使用 Claude Sonnet 5.5。想把数字与自己的流量对照,可以在 Apifox 中发送请求,并读取每个响应中的 usage 字段。
Claude Sonnet 5.5 API 价格表
每百万 token(MTok)的价格,来自Anthropic 的定价文档:
| 计费项 | 每 MTok 价格 |
|---|---|
| 输入 | $2.00 |
| 5 分钟缓存写入 | $2.50 |
| 1 小时缓存写入 | $4.00 |
| 缓存读取 | $0.20 |
| 输出 | $10.00 |
| 批处理输入 | $1.00 |
| 批处理输出 | $5.00 |
有三个细节会改变你的实际支出:
- 仅限美国境内推理。在 Claude API 和 Claude Platform on AWS 上,
inference_geo: "us"会让每一类 token 的价格变为 1.1 倍(输入 $2.20、输出 $11、缓存读取 $0.22)。Foundry 的美国数据区部署同样是 1.1 倍;Bedrock 和 Google Cloud 单独定价。 - 没有长上下文附加费。一个 900k token 的请求与一个 9k token 的请求每 token 价格相同。
- 与 Sonnet 5 使用相同的分词器。你的 token 计数可以原样沿用。
Sonnet 5.5 在标价上的对比
| 模型 | 输入 | 输出 | 说明 |
|---|---|---|---|
| Claude Sonnet 5.5 | $2 | $10 | 缓存读取 $0.20;1M 上下文;不支持快速模式 |
| Claude Sonnet 5 | $2 | $10 | 缓存读取 $0.20;$3/$15 涨价已取消 |
| Claude Opus 5.5 | $4 | $20 | 缓存读取 $0.20;快速模式 $8/$40 |
| Claude Haiku 4.5 | $1 | $5 | 200k 上下文 |
| GPT-6 Sol | $2 | $10 | 缓存输入减免 90%;872k 上下文 |
| GPT-6 Luna | $0.10 | $0.50 | 1M 上下文 |
Sonnet 5.5 在输入、输出和缓存写入上的成本是 Opus 5.5 的一半。它与 GPT-6 Sol 的标价完全相同,都是 $2/$10,因此在这两者之间做选择取决于每个任务的实际效果。想看背景,请参阅 Claude Sonnet 5 价格、2026 年 9 月的价格战和 GPT-6 Sol 价格。
算例:真实请求要花多少钱
每一项的公式都是:token 数 ÷ 1,000,000 × 每 MTok 价格。先给每个计费项定价,再相加。
算例 1:一次聊天式请求
3,000 输入 token、800 输出 token,无缓存。
- 输入:3,000 ÷ 1,000,000 × $2 = $0.006
- 输出:800 ÷ 1,000,000 × $10 = $0.008
- 合计:$0.006 + $0.008 = $0.014
一千次这样的请求需要 $14。输出占 token 数的 21%,却占了账单的 57%,所以输出长度比提示词长度更关键。
算例 2:agent 反复读取 50,000 token 的前缀
一个 agent 循环在 20 次调用中发送相同的 50,000 token 前缀(系统提示词、工具、代码库上下文)。这里只计算该前缀的费用。
不缓存:20 × 50,000 = 1,000,000 token;1,000,000 ÷ 1,000,000 × $2 = $2.00
使用缓存,并采用 5 分钟写入:
- 第 1 次调用写入缓存:50,000 ÷ 1,000,000 × $2.50 = $0.125
- 第 2 到 20 次调用读取缓存:19 × 50,000 = 950,000 token;950,000 ÷ 1,000,000 × $0.20 = $0.19
- 合计:$0.125 + $0.19 = $0.315
这样节省了 $1.685,约 84%。5 分钟写入只有在调用都落在时间窗口内时才划算;对于较慢的循环,1 小时写入的成本是 50,000 ÷ 1,000,000 × $4 = $0.20,总计为 $0.20 + $0.19 = $0.39,仍比不缓存低约 80%。我们在提示词缓存成本测算中为 Opus 做过同样的推演;$0.20 的读取费率完全相同。
算例 3:一个 10,000 次请求的批处理任务
形态与算例 1 相同,通过批处理 API 发送。
- 输入:10,000 × 3,000 = 30,000,000 token;30 × $1 = $30
- 输出:10,000 × 800 = 8,000,000 token;8 × $5 = $40
- 批处理合计:$70,而按标准费率为 30 × $2 + 8 × $10 = $140
批处理还通过 output-300k-2026-03-24 beta 把输出上限从 128K 提升到 300K token。
按任务算成本,而不是按 token 算
费率表告诉你一个 token 多少钱,而不是你的任务会烧掉多少 token。后一个数字随 effort 变化的幅度,远超过模型之间的任何费率差距。
Anthropic 表示,在其测试中 Sonnet 5.5“每个任务的成本比上一代最多低 30%”。发布文章还绘制了每个 effort 等级的成本。Terminal-Bench 4.0 的数据由 Anthropic 自己跑出,FrontierCode 由 Cognition 运行,指数成本来自 Artificial Analysis:
| Effort | Terminal-Bench 4.0(得分,$/次) | FrontierCode v1.1(得分,$/任务) | AA 指数(得分,运行成本) |
|---|---|---|---|
| low | 20.0%,$0.76 | 29.3%,$0.19 | 35.8,$544 |
| medium | 28.8%,$0.83 | 36.5%,$0.24 | 40.7,$701 |
| high | 43.0%,$1.94 | 49.4%,$0.42 | 46.7,$1,176 |
| xhigh | 61.5%,$5.30 | 52.1%,$1.59 | 51.9,$2,738 |
| max | 70.6%,$12.54 | 46.2%,$20.78 | 56.0,$8,977 |
值得注意的几点:
- max 在 Terminal-Bench 上的成本约为 high 的 6.5 倍($12.54 ÷ $1.94 = 6.46)。Artificial Analysis 指数在 max 下的运行成本约为 low 的 16.5 倍($8,977 ÷ $544)。
- 更高的 effort 并不总是更好。FrontierCode 从 xhigh 的 52.1% 降到 max 的 46.2%,而每任务成本却上涨 13 倍($20.78 ÷ $1.59)。Anthropic 的脚注指出,在 max 下模型更常运行会展开 subagent 的评审 skill,这在 Cognition 检查的案例中导致了超时或超出范围的编辑。
- 较低 effort 的 Opus 同样有竞争力。Opus 5.5 在 medium 下以 $2.94 在 Terminal-Bench 上取得 57.6%,而 Sonnet 5.5 在 high 下以 $1.94 取得 43.0%。我们的 Sonnet 5.5 对比 Opus 5.5 详细分析了这一权衡。
max 下的冗长是另一个陷阱。OfficeChai 对 Artificial Analysis 数据的整理显示,Sonnet 5.5 在 max 下每个指数任务约输出 193,000 个 token,每任务成本比 Sonnet 5 高约 50%。Simon Willison 在 Hacker News 上报告称,一次 max effort 的运行消耗了 128,000 个思考 token,还没给出答案就用完了。
六个削减账单的手段
- 有意识地设置 effort。API 默认为
high;Claude Code 和 Claude 应用默认为medium。Anthropic 的提示词指南建议聊天场景用medium或low,只有在质量提升可被测量时才用xhigh或max。不要把 Sonnet 5 的设置沿用过来;等级刻度已经重新校准。 - 在原先关闭思考的地方改用
between_tools。thinking: {"type": "disabled"}现在会返回 400;{"type": "between_tools"}可在low、medium和high下替代它。 - 缓存任何会被复用的内容。可缓存的最小提示词为 512 token(Sonnet 5 上为 1,024)。在请求之间更改顶层的
effort会使缓存失效,所以要保持不变。 - 把可以等待的任务改成批处理。输入和输出都是半价。
- 让
max_tokens保持合理。Anthropic 的指南把stop_reason: "max_tokens"视为失败的响应,所以被截断的答案是花了钱却交付不了东西。 - 削减未被要求的工作。Sonnet 5.5 会添加你并未要求的测试、文档和文件,并在
xhigh和max下启动额外的评审轮次。Anthropic 建议的系统提示词段落能在max下把会话成本降低约三分之一,而质量没有变化。
还有哪些地方要为 Sonnet 5.5 付费
- Claude 套餐(claude.com/pricing):Free 为 $0,聊天中包含 Sonnet,但没有 Claude Code。Pro 按年付费为每月 $17,按月付费为 $20。Max 起价每月 $100。Team 席位为 $20/$25(标准)或 $100/$125(高级),分别为年付/月付。它们都不包含 API 访问。
- GitHub Copilot:Pro(每月 $10)、Pro+、Max、Business 和 Enterprise,按提供方标价计费。Copilot Pro 每月包含 1,500 个 AI 额度,每个 $0.01,约合 $15 的 token,大致相当于 1,070 次算例 1 的请求($15 ÷ $0.014)。Copilot Free 和 Student 无法选择它。
- Cursor:从 Other Models 额度池按相同费率计费(Pro、Pro Plus 和 Ultra),仅限美国的 endpoint 另加 10%($2.20/$11)。
- OpenRouter:$2/$10,
:batch版本为 $1/$5。没有:free版本。 - Vercel AI Gateway:$2/$10,缓存读取 $0.20。$5 的免费额度不覆盖 Sonnet 5.5。
- Bedrock、Google Cloud、Foundry:以各自云厂商的价格页面为准。Bedrock 仅支持 Standard 层,没有批处理。
更想找额度?参见有没有免费的 Claude Sonnet 5.5 API。
在 Apifox 中跟踪每次请求的成本
每个 Messages 响应都带有 usage 对象,包含 input_tokens、output_tokens 和缓存计数。这足以在 Apifox 中为任何一次调用计价:
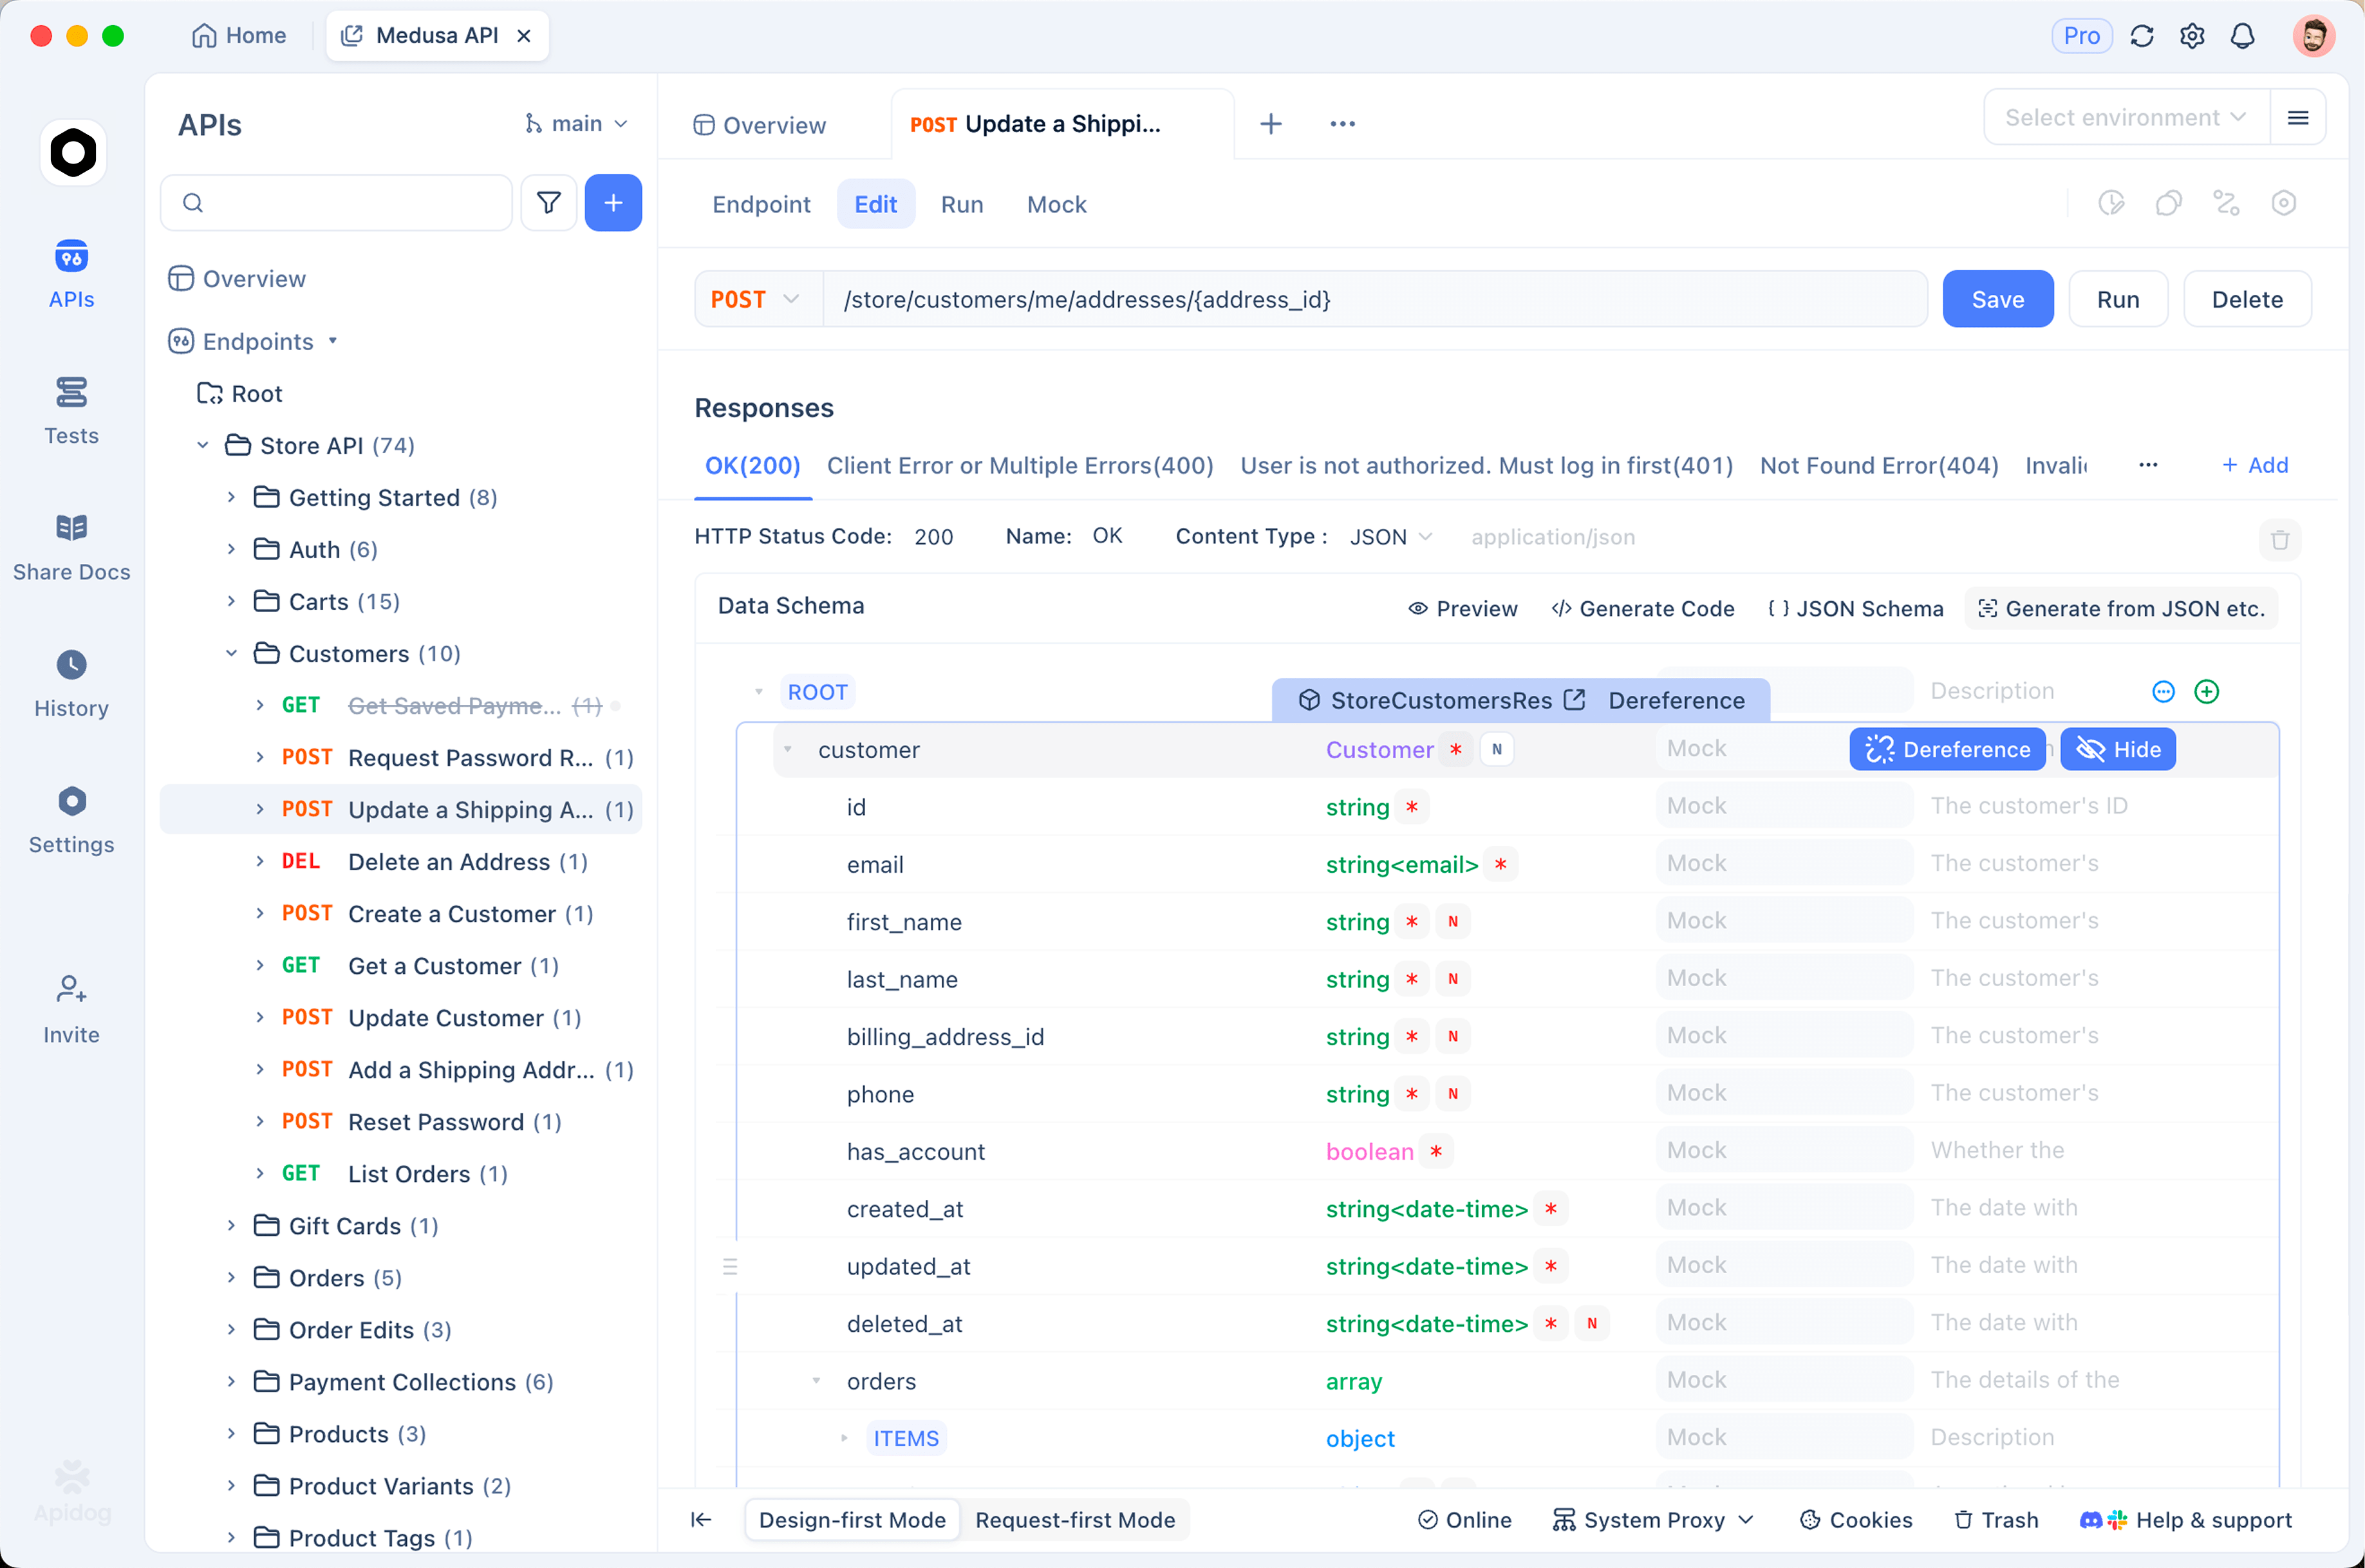
- 把 key 存为
ANTHROPIC_API_KEY环境变量。 - 使用相同的提示词,为每个 effort 等级(
low、medium、high)各保存一次这个请求:
curl https://api.anthropic.com/v1/messages \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-sonnet-5-5",
    "max_tokens": 4000,
    "thinking": {"type": "between_tools"},
    "output_config": {"effort": "medium"},
    "messages": [{"role": "user", "content": "Classify this support ticket: ..."}]
  }'
- 添加一个后置操作,为调用计价并在被截断时判定失败:
const body = pm.response.json();
const u = body.usage;
const cost = (u.input_tokens * 2 + u.output_tokens * 10) / 1e6;
pm.environment.set("last_call_usd", cost.toFixed(5));
pm.test("not truncated", () => pm.expect(body.stop_reason).to.not.eql("max_tokens"));
- 运行这三个请求,并排比较
usage.output_tokens和成本。如果使用了缓存,还要按各自的费率加上缓存计数。
完整的请求演练见如何使用 Claude Sonnet 5.5 API。
常见问题
Claude Sonnet 5.5 每百万 token 多少钱?在 Claude API 上输入 $2、输出 $10。缓存读取为 $0.20;批处理 API 收费 $1 和 $5。
Sonnet 5.5 比 Sonnet 5 更贵吗?不贵。每 token 价格相同,而且 Anthropic 表示在其测试中 Sonnet 5.5 每个任务的成本最多低 30%。
超过 200k token 会有附加费吗?不会。完整的 1M 窗口都按标准费率计费。
Sonnet 5.5 有快速模式吗?没有。快速模式仅在 Opus 5.5、Opus 5 和 Opus 4.8 上提供。
Claude Sonnet 5.5 免费吗?在 Claude 聊天应用中免费:任何人都可以在 Free 套餐中与它对话。API 基于预付费额度运行;免费 API 指南介绍了各项额度项目。
下一步:为你的工作负载定价
挑出你最常用的三种请求形态,各跑两个 effort 档位,再把 usage 里的数字乘以上面的表格。你很快就能看出 medium 是否守得住你的质量底线,或者 high 是否值得多花那些 token。
HiFox:将 Agent 变成真正的队友
另外,我们也在思考,AI 如何从个人提效走进团队协作。
HiFox 是一个让人和 AI Agent 在同一个工作现场协作的平台:你可以像给同事分派任务一样指派 Agent,在任务看板中跟踪进度、查看结果,让 Agent 成为团队里的队友。
👉 立即体验 HiFox:https://hifox.com
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,
欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。