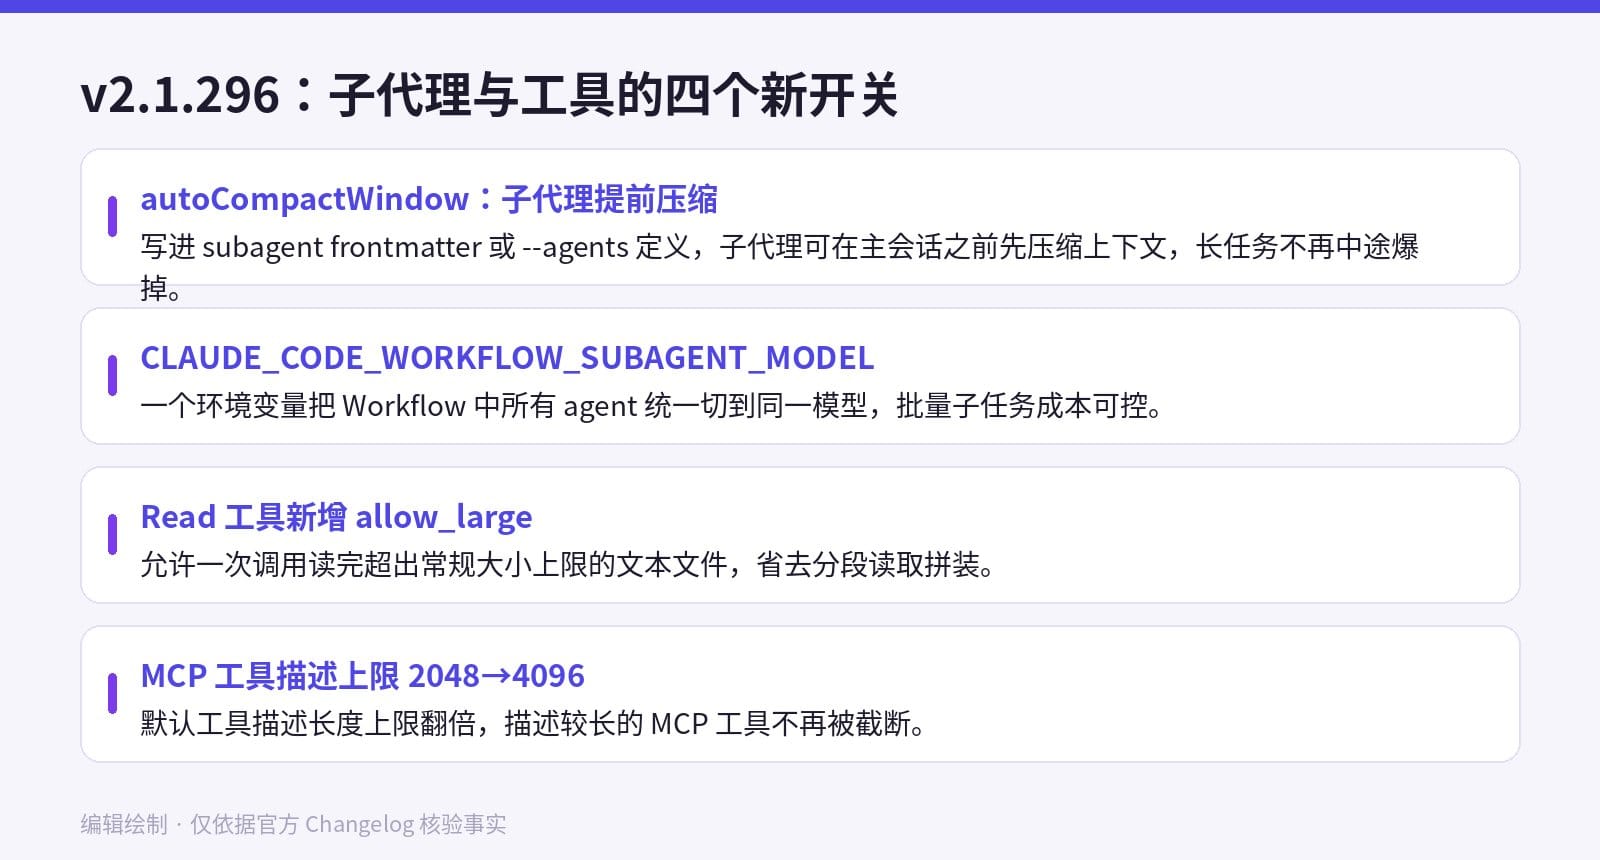
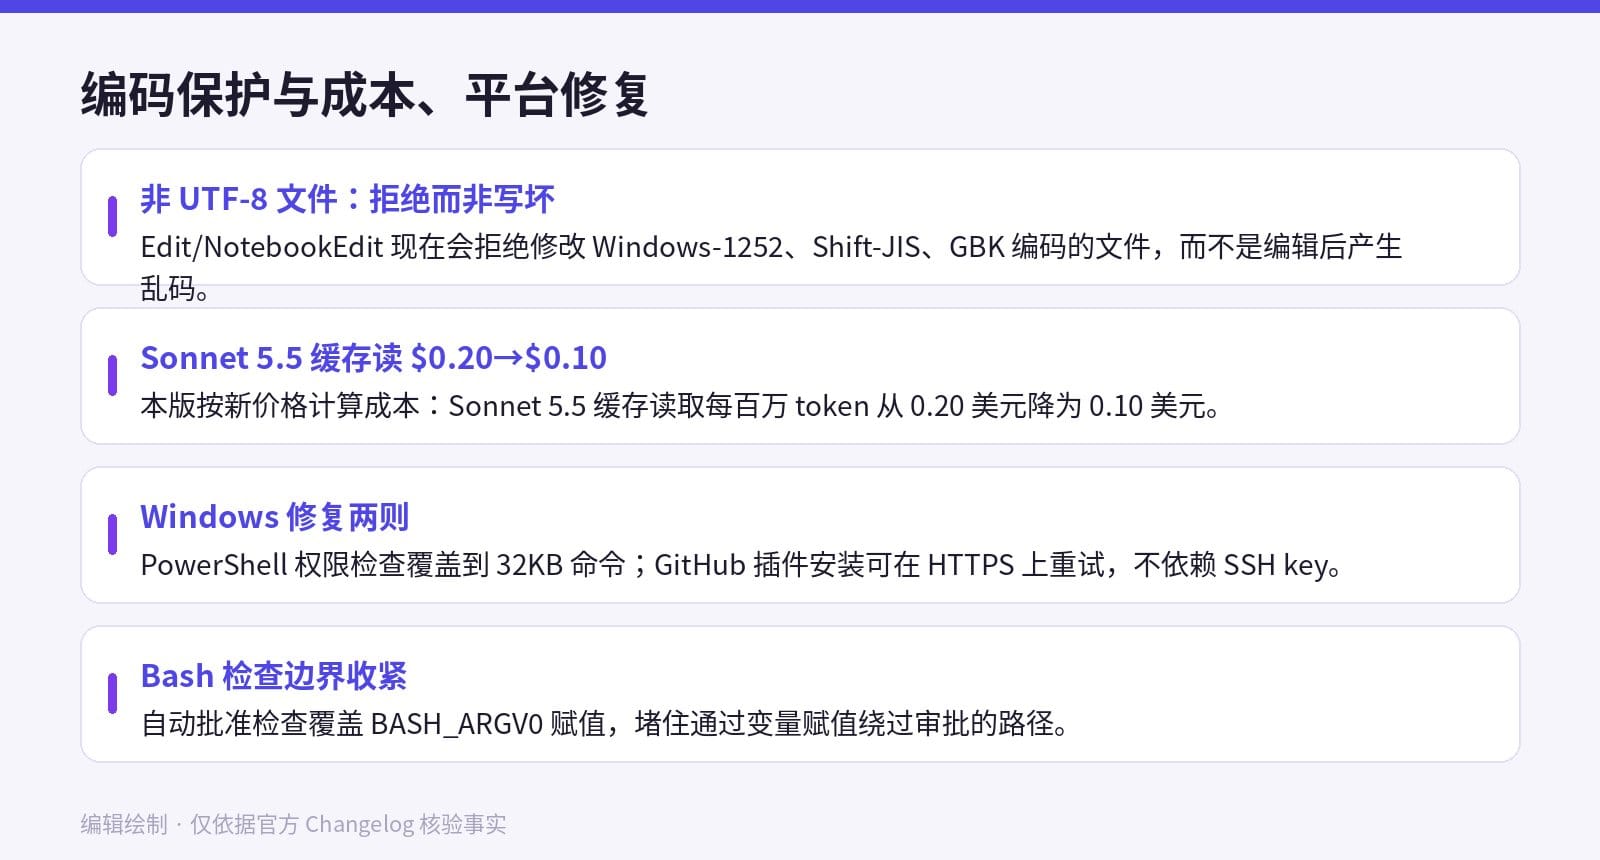
2026 年 10 月 9 日,Anthropic 把 Claude Code 推到 v2.1.296。官方 CHANGELOG 列出的更新集中在四件事:子代理获得提前压缩上下文的 autoCompactWindow 配置、Read 工具新增 allow_large 选项、MCP 工具描述默认上限从 2048 提到 4096 字符,以及一批编码与平台修复——其中最值得中文开发者注意的是:Edit 和 NotebookEdit 现在会拒绝修改 GBK、Windows-1252、Shift-JIS 等非 UTF-8 编码的文件,而不是编辑后把文件写坏。
如果你维护过任何有历史的中文项目——十年前的 ERP、证券或者政企系统——大概率见过这样的场面:让 AI 改一个 GBK 编码的 Java 文件,模型把补丁打得完全正确,但保存时按 UTF-8 写回,整个文件的中文注释一夜之间变成乱码,diff 里几千行“变更”里只有三行是真的。这次更新回答的问题很具体:子代理跑长任务能不能不中途爆上下文,以及 AI 到底还要不要为编码问题背锅。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
发生了什么:四组更新分别落在哪一层
按官方 CHANGELOG 逐条核对,v2.1.296 的更新可以分成四层。第一层是子代理控制:autoCompactWindow 可以写进 subagent 的 frontmatter 或 --agents 定义,让子代理在比主会话更早的时机自动压缩上下文;配套的 CLAUDE_CODE_WORKFLOW_SUBAGENT_MODEL 环境变量则让一次 Workflow 里的全部 agent 统一跑在同一个模型上,不必逐个指定。
第二层是输入能力:Read 工具增加 allow_large 选项后,Claude 可以在一次调用里读完整超出常规大小限制的文本文件,而不是分多次读取再拼装;MCP 工具描述的默认长度上限从 2048 字符翻倍到 4096,那些参数说明写得长的 MCP 工具不再被截断。
第三层是计费口径:Changelog 明确写的是“成本数字现在按 Sonnet 5.5 缓存读取每百万 token 0.10 美元计算(此前为 0.20 美元)”。缓存读取价格减半,直接拉低长会话、多轮迭代场景的持续成本。
第四层是修复:除编码保护外,Bash 的自动批准检查现在覆盖 BASH_ARGV0 赋值;Windows 上 PowerShell 权限检查覆盖到 32KB 以内的命令,GitHub 插件安装失败时可以在 HTTPS 上重试、不再强制依赖 SSH key。
完整工作场景:一个 GBK 老仓库的一天
把更新放进真实流程里看差别。之前的工作流是:接到一个 GBK 编码的老仓库需求 → 让 Claude Code 改三个文件 → 其中一个文件保存后中文全部乱码 → 回滚、手工转码、再重跑。修复生效后的流程变成:Claude Code 尝试 Edit 时检测到文件不是 UTF-8 → 直接拒绝这次编辑并说明原因 → 开发者用 iconv 或 IDE 把文件转成 UTF-8 → 再让 Claude Code 重跑。输入还是那个输入,交付物从“可能损坏的补丁”变成“明确的拒绝加原因”,返工环节被前置消掉。
子代理那组配置的收益在另一个场景:跑一个“扫描全仓并生成迁移报告”的 Workflow,以前子代理上下文撞上限就中断,人只能重开;现在在 subagent 定义里加一行 autoCompactWindow,子代理在接近上限时先压缩再继续,整条任务链不断。官方对这项能力的表述是“子代理可以比主会话更早压缩”,也就是说压缩时机被拆成了两个独立档位:主会话有主会话的节奏,子代理按自己的窗口提前收缩,两边互不迁就。若同时设 CLAUDE_CODE_WORKFLOW_SUBAGENT_MODEL,可以让几十个并行子任务全部跑在同一个模型上,主会话仍保留强模型把关——这对按模型分工控制预算的团队是直接可用的开关。
再把缓存价格放进同一张账单看:这类全仓扫描任务的特点是重复读同一批文件,缓存命中率高。缓存读取从每百万 token 0.20 美元降到 0.10 美元,意味着“先读一遍建缓存、再让子代理反复引用”的策略成本直接减半,长会话多轮迭代的单次试错也更便宜。价格数字是 Changelog 里 Claude Code 成本口径的原文,做预算时以官方定价页为最终依据。
为什么这批更新改变工作流
“拒绝写坏”比“修得更准”更值得写进流程。模型对代码语义的理解再好,也拦不住编码层的事故;把“检测到非 UTF-8 就拒绝”做成工具层硬规则,等于给自动化加了一道不依赖模型判断的保险丝。对团队来说,这意味着可以把 GBK 仓库重新纳入 AI 辅助范围,不需要先做全仓转码。子代理自动压缩则是把“长任务必须人盯着”的约束往回退了一格——压缩时机可配置,中断点变少,挂机跑批的信心才会真正建立。
边界与人工接管点
四个边界要认清。第一,autoCompactWindow 和 CLAUDE_CODE_WORKFLOW_SUBAGENT_MODEL 都是显式配置项,不配置就维持原行为,团队需要自己决定压缩阈值,压得太早会丢上下文细节。第二,非 UTF-8 文件被拒绝编辑不等于问题被解决——转码本身仍要人来决策,尤其当仓库的构建脚本还按 GBK 读取源文件时,盲目转 UTF-8 会把事故从编辑层挪到编译层,先在 CI 里验证转码后的构建再合入。第三,allow_large 是“允许读”,不是“鼓励读”:超大文件一次进上下文会显著增加 token 消耗,日志类文件更适合先用 grep 定位再局部读取。第四,0.10 美元的缓存读取价是 Changelog 中 Claude Code 成本数字的口径,实际账单以 Anthropic 官方定价页为准,跨模型对比时别只看单一数字。
如何升级试用
已安装用户执行 claude update,或用 npm install -g @anthropic-ai/claude-code@latest 安装最新版,安装后用 claude --version 确认是 2.1.296。子代理压缩配置写在 subagent 文件的 frontmatter 里,Workflow 统一模型用环境变量 CLAUDE_CODE_WORKFLOW_SUBAGENT_MODEL 设置。升级前建议先在一个非关键仓库验证 Read 的 allow_large 行为,确认它对大日志文件的读取符合预期,再铺开到日常仓库。
信息来源
本文全部功能事实来自 Anthropic 官方仓库的 Claude Code CHANGELOG(v2.1.296 条目);发布时间依据 npm registry 中 @anthropic-ai/claude-code 包 2.1.296 版本的时间戳(2026-10-09)。文中价格、平台行为如与官方文档冲突,以官方文档为准。
HiFox :将 Agent 变成真正的队友
另外,我们也在思考,AI 如何从个人提效走进团队协作。
HiFox 是一个让人和 AI Agent 在同一个工作现场协作的平台:你可以像给同事分派任务一样指派 Agent,在任务看板中跟踪进度、查看结果,让 Agent 成为团队里的队友。
👉 立即体验 Hifox:https://hifox.com
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。