很多团队第一次做 API 平台私有化,会把它理解成“把 SaaS 搬到机房”:装好应用、连上数据库、能登录,就算完成。
真正上线后才发现问题不在安装,而在架构:高峰期文档打不开、Runner 任务堆住、数据库备份没验证、升级窗口没人敢定、出了故障不知道该先恢复哪一层。
这篇文章给一套可以拿去和运维、安全、厂商对齐的架构方法。具体组件和配置以 Apifox 官方部署方案为准,这里重点讲评估维度和容易漏掉的坑。
一、先把架构画成 6 个平面
不要一上来就问“几台服务器”。先把系统拆成六个平面,再逐层决定高可用和扩容方式。
| 平面 | 作用 | 高可用做法 | 常见坑 |
|---|---|---|---|
| 接入层 | 域名、VIP、反向代理、TLS | 双实例、健康检查、证书轮换 | 只做应用高可用,入口仍是单点 |
| 应用层 | Web、API、文档、Mock | 多实例、无状态、滚动升级 | 会话/文件落本地,扩容后不一致 |
| 数据层 | 关系库、缓存、对象存储 | 主备、备份、容量监控 | 只备份数据库,漏了文件和配置 |
| 执行层 | 自托管 Runner、定时任务 | 多节点、队列、失败重试 | Runner 单点,任务堆积 |
| 身份层 | SSO、LDAP、OAuth/OIDC | IdP 高可用、超时降级 | 身份源故障导致全员登不上 |
| 可观测层 | 日志、指标、审计、告警 | 集中采集、保留策略 | 出故障时没有足够日志定位 |
这张表的价值在于:高可用不是“应用多开一个实例”,而是每一层都不能是单点。
二、服务器怎么估:先给输入,再谈配置
“最低配置”只能用于演示。生产环境要按真实负载估。
建议先整理下面这些输入,再让厂商出配置建议:
| 输入 | 为什么要问 |
|---|---|
| 活跃用户数、峰值并发 | 决定应用实例数和连接数 |
| 项目数、接口数、文档数 | 决定数据库容量和检索压力 |
| 文档访问量、分享链接访问量 | 文档页面可能是流量大头 |
| Mock QPS | Mock 被打爆会直接影响联调 |
| Runner 并发任务数、定时任务频率 | 决定执行层资源 |
| 是否启用 AI、是否接私有模型 | AI 推理可能单独占资源 |
| 日志/审计保留天数 | 决定存储和查询成本 |
| 备份保留周期、RTO/RPO | 决定备份介质和恢复方案 |
一个常见的误区是只按“研发人数”估。实际上,文档访问、Mock 调用、Runner 任务、日志保留经常比登录用户更吃资源。
建议的容量评估顺序
- 先算存储:数据库、对象存储、日志、备份。
- 再算应用:峰值并发、文档页面、Mock QPS。
- 再算执行层:Runner 并发、定时任务、失败重试。
- 最后算网络:入口带宽、跨机房复制、备份传输。
- 用压测验证,而不是只看厂商表格。
三、高可用:先定义 RTO 和 RPO
高可用不是越贵越好,而是和业务目标匹配。先和业务方确认两个数字:
- RTO(恢复时间目标):故障后多久必须恢复。
- RPO(恢复点目标):最多能接受丢多少数据。
| 级别 | 参考架构 | 大致 RTO/RPO | 适合场景 |
|---|---|---|---|
| 基础 | 单应用 + 单数据库 + 定期备份 | 小时级 | 试点、非核心团队 |
| 标准 | 应用多实例 + 数据库主备 + 每日备份 | 分钟到小时 | 大多数企业生产 |
| 高可用 | 多可用区 + 数据库主备 + 对象存储冗余 | 分钟级 | 核心研发平台 |
| 容灾 | 同城/异地副本 + 定期演练 | 按业务定义 | 金融、政务、运营商 |
注意三个细节:
1. 会话和文件不能落单机
如果应用多实例,但会话、上传文件、Mock 配置落在本地磁盘,扩容后会出现“有时能登录、有时 404”。应用层要尽量无状态,文件走共享存储或对象存储。
2. 定时任务和 Runner 要防重复执行
多个 Runner 同时跑同一个定时任务,可能造成重复告警、重复写入。要确认任务调度是集中式还是带锁的。
3. 身份源也是单点
SSO 挂了,平台再高可用也进不去。IdP 本身要高可用,同时要有超时、重试和应急管理员账号策略。
四、备份与恢复:备份不是目的,恢复才是
私有化平台里,至少要备份四类东西:
- 数据库:项目、接口、用例、权限、审计等核心数据。
- 对象存储/文件:文档附件、图片、导入导出文件。
- 配置:环境变量、集成配置、证书、密钥引用。
- 部署清单:镜像版本、容器配置、网络策略、升级记录。
建议的备份策略
- 数据库:每日全量 + 增量/日志备份,保留周期按合规要求。
- 文件:对象存储版本化或跨桶复制。
- 配置:纳入 Git 或配置管理系统,变更可追溯。
- 备份介质:至少一份离线/异地,避免勒索软件一锅端。
- 恢复演练:每季度至少一次,记录实际 RTO。
恢复时要回答的问题
- 恢复的是整个平台,还是单个项目?
- 数据库恢复到某个时间点,文件是否同步?
- 恢复后 SSO、Webhook、Runner 的密钥是否还有效?
- 恢复期间用户访问什么?是否有维护页?
- 谁有权批准恢复?谁执行?谁验证?
没有演练过的备份,只能算“有一份副本”,不能算“可恢复”。
五、扩容与升级:别等告警才想
扩容
- 应用层:优先水平扩容,确认无状态。
- 数据库:先看慢查询和索引,再考虑升配/只读副本。
- 对象存储:按容量和请求数扩容。
- Runner:按任务队列长度扩容,不要只看 CPU。
- 日志:按保留天数扩容,避免把磁盘打满。
升级
私有化升级最怕两件事:没有回滚方案、没有兼容性验证。
建议固定一套升级流程:
- 阅读版本说明,确认数据库变更和配置变更。
- 在预发环境按生产数据量演练。
- 备份数据库、文件和配置。
- 选择低峰窗口,先升级非核心节点。
- 验证登录、文档、Mock、测试、Runner、Webhook。
- 保留旧版本镜像和回滚脚本。
- 升级后 24 小时重点观察错误率和延迟。
六、上线前 15 项架构评审清单
| # | 检查项 | 通过标准 |
|---|---|---|
| 1 | 入口是否高可用 | 反向代理/负载均衡无单点 |
| 2 | 应用是否无状态 | 扩容后会话、文件不丢 |
| 3 | 数据库是否有主备 | 故障可切换 |
| 4 | 是否有备份 | 数据库、文件、配置都有 |
| 5 | 是否做过恢复演练 | 有记录、有 RTO 实测 |
| 6 | Runner 是否多节点 | 任务不堆、不重复 |
| 7 | 身份源是否高可用 | IdP 故障有预案 |
| 8 | 日志是否集中采集 | 可按用户/项目/时间检索 |
| 9 | 审计是否开启 | 关键操作可追溯 |
| 10 | 监控是否覆盖 | 应用、数据库、存储、Runner |
| 11 | 告警是否到人 | 有值班和升级路径 |
| 12 | 容量是否有余量 | 峰值 CPU/内存/磁盘有缓冲 |
| 13 | 升级是否有回滚 | 旧镜像和脚本保留 |
| 14 | 网络策略是否最小化 | 只开必要端口 |
| 15 | 文档是否齐全 | 架构图、部署图、Runbook |
七、结论
Apifox 私有化部署的架构,核心不是“买多大服务器”,而是把接入、应用、数据、执行、身份、可观测六个平面拆清楚,再按 RTO/RPO 决定高可用级别。
一个可执行的推进顺序是:
- 先用真实输入做容量评估。
- 再定高可用级别和备份策略。
- 然后做一次恢复演练和压测。
- 最后才谈扩容和升级流程。
如果你正在做私有化选型,可以对照 Apifox 私有化部署方案 获取架构说明、安全材料和 1v1 演示。把用户规模、并发、集成清单和合规要求准备好,方案沟通会快很多。
开发必备:API 全流程管理神器 Apifox
介绍完上文的内容,我想额外介绍一个对开发者同样重要的效率工具 —— Apifox。作为一个集 API 文档、调试、设计、测试、Mock、自动化测试于一体的工具,Apifox 是目前提升研发效率的首选。
如果你正在开发项目,不妨试试其极其友好的界面设计,它完全兼容 Postman 和 Swagger 数据格式,导入数据非常方便,,即使是新手也能很快上手,点击这里即可注册使用。
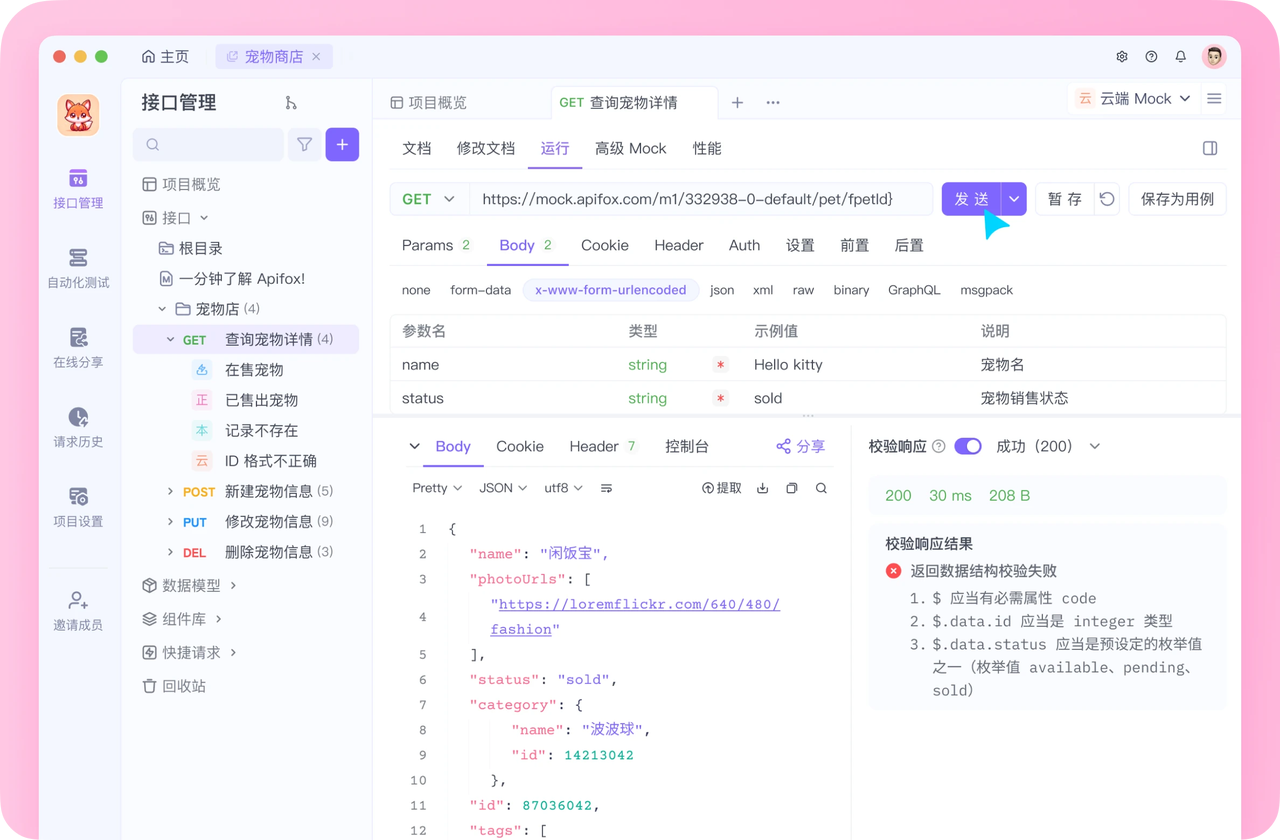
值得一提的是,除了个人和常规团队使用,针对有高安全合规要求、或需要在内网环境协作的企业,Apifox 还提供了深度定制的私有化部署方案。
获取专属报价与部署方案
 详细的私有化部署系统架构与安全白皮书
 针对您公司规模的专属报价单
 免费的 1v1 专属产品演示 (Demo) 机会