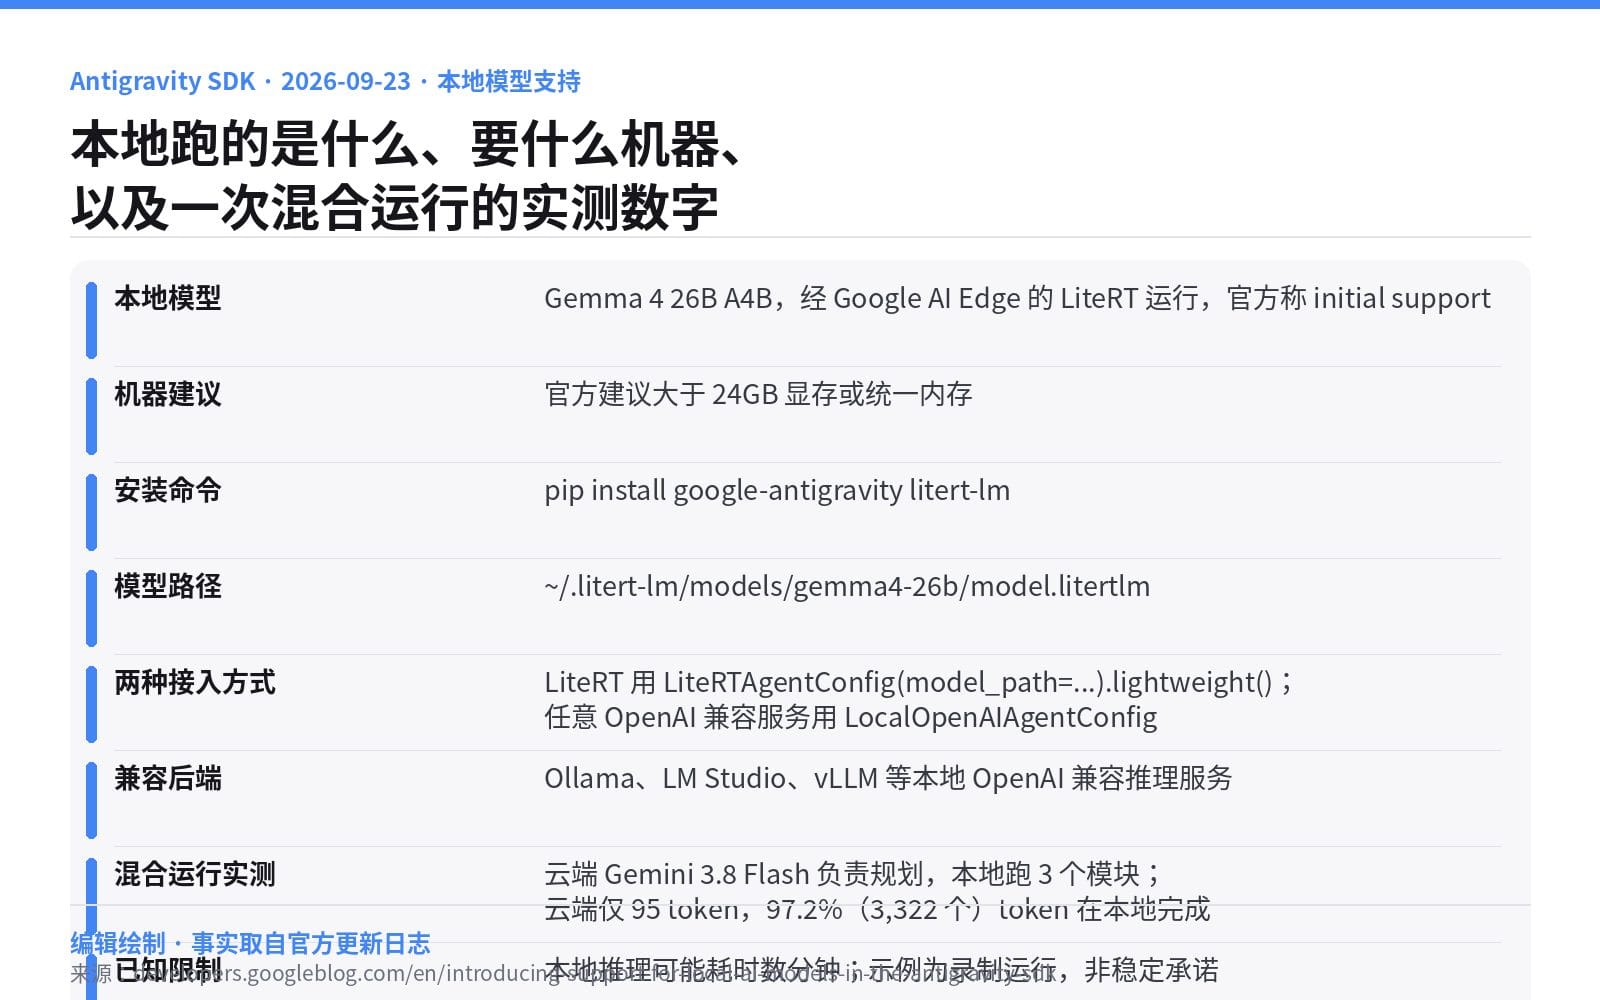
摘要:2026 年 9 月 23 日,Google 宣布 Antigravity SDK 支持本地模型与本地执行,首批支持经 Google AI Edge 的 LiteRT 运行的 Gemma 4 26B A4B,让 agentic 能力可以完全离线运行。安装命令为 pip install google-antigravity litert-lm,官方建议机器具备大于 24GB 显存或统一内存。除 LiteRT 外,SDK 通过 LocalOpenAIAgentConfig 接入任意 OpenAI 兼容的本地推理服务,例如 Ollama、LM Studio 与 vLLM。官方给出的混合运行实测中,云端只消耗 95 个 token,97.2% 的 token 在本地完成。
AI Coding 工具的成本结构里,有一块始终不太好解释:读代码、改文件、跑测试这些动作本身并不需要顶级模型的推理能力,但它们消耗的 token 数量最大。一个 agent 在一次重构里可能发起几十次工具调用,每一次都要把上下文重新送进云端。
9 月 23 日,Google 在 Antigravity SDK 里给出了另一种切法:把执行留在本地,把规划留给云端。这篇公告值得细看的地方不在于「支持本地模型」这个结论,而在于它给出的具体数字——97.2% 的 token 没有离开开发机。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。

发生了什么:SDK 增加本地执行路径
公告由 Sachin Kotwani 与 Taylor Mullen 撰写,内容是 Antigravity SDK 现在支持「跨多种本地模型与执行选项的本地工作流」,首批支持的是 Gemma 4 26B A4B,通过 Google AI Edge 的 LiteRT 在本地 GPU 与内存上运行。SDK 本身提供的是 Google Antigravity 背后那套 agentic 能力,本地路径的加入让它可以完全离线使用。
官方给出的动机有四条,其中两条对团队决策影响最大:一是省掉 API 费用与速率限制;二是代码与请求留在开发机上,适用于有合规限制的环境。另外两条分别是网络不可靠时仍能工作,以及混合使用本地与云端步骤。
接入方式有两类。走 LiteRT 时用 LiteRTAgentConfig(model_path=MODEL_PATH).lightweight() 构造配置,再通过 Agent(config) 打开,之后调用 agent.chat(...) 并流式接收 token;模型文件预期位于 ~/.litert-lm/models/gemma4-26b/model.litertlm。如果不想用 LiteRT,可以用 LocalOpenAIAgentConfig 接入任何 OpenAI 兼容的本地服务,公告点名了 Ollama、LM Studio 与 vLLM——这意味着编排、工具与工作流定义保持不变,只换推理后端。
一个具体场景:把三个模块的改造放在本地跑
公告里给了一个混合运行的示例:云端由 Gemini 3.8 Flash 担任「架构师」角色,负责规划与拆解任务;本地则由多个 Gemma 4 26B 实例组成执行队列,在三个模块 auth.py、billing.py、database.py 上动手。
关键数字有两个。规划阶段消耗了 95 个云端 token,并且官方强调「没有任何源码离开这台机器」;整轮下来 97.2% 的 token(3,322 个)在本地离线完成,没有调用云端 API。这两个数字放在一起,说明混合模式的成本结构完全不同于全云端:贵的那部分被压缩到只做拆解,做得多但不需要高智能的部分留在本地。
为什么这会改变工作流
第一个改动在成本模型上。过去用 agent 做大规模代码改动时,成本近似正比于「工具调用次数 × 上下文长度」,而且很难在事前估算。把执行层放到本地之后,边际成本变成电费与时间,只有规划部分需要按 token 付费。对经常跑批量重构或代码库级迁移的团队来说,这是一个结构性的变化,而不只是费率优化。
第二个改动在合规路径上。代码不出机器,意味着很多原本因为「源码不能上传第三方」而无法使用云端 agent 的场景被打开。公告把这一点列为动机之一,并明确指向合规受限的环境。对于处理客户数据或受监管代码的团队,这条路的价值可能超过省钱本身。
第三个改动在离线可用性上。公告特别写到,本地执行适用于网络不稳定甚至完全不可用的环境。这个特性对在受限网络、临时断网或需要在客户现场作业的开发者更实际——AI 辅助不再随网络一起中断。
限制、边界与人应该在哪儿接手
先说硬件门槛,这一条很可能直接决定能不能用:官方建议机器具备大于 24GB 的显存或统一内存。这个要求把相当一部分开发笔记本排除在外,团队需要先盘点设备,而不是先写代码。
第二是速度。公告明确提示本地推理「可能要花几分钟」,模型文件也需要先下载到本地。这意味着本地执行并不适合当作交互式补全使用,更适合放在「提交后台跑一批改动」的位置。对人的接管点的提示也很直接:不要把本地 agent 放进需要毫秒级响应的循环里。
第三是官方对这次能力成熟度的表述——Gemma 4 26B 的支持被描述为 initial,也就是初步支持;混合运行的演示被说明为一次录制的运行,而不是稳定承诺。把它当作可以立刻上生产的方案并不合适,更合理的是先在非关键仓库上做验证。
第四,混合模式并不等于全离线。示例里仍有云端规划这一步,只做规划不意味着没有数据流出去——公告的说法是不上传源码,且规划阶段的 token 很少,但这与「完全不出机器」是两个概念,需要按自身合规口径判断。
如何试用
准备一台满足内存建议的机器,创建并激活 Python 虚拟环境,安装 google-antigravity 与 litert-lm 两个包,用 litert-lm import 从 Hugging Face 拉取 Gemma 4 26B A4B 的 LiteRT 版本并命名为 gemma-26b。随后写一个最小的 agy_sample.py,构造 LiteRTAgentConfig(model_path=MODEL_PATH).lightweight(),通过 Agent(config) 打开并调用 agent.chat(...)。若要执行文件操作类任务,还需要传入 workspaces=[WORKING_DIR] 与相应的 policies 设置。想换后端时,改用 LocalOpenAIAgentConfig 指向本地的 Ollama、LM Studio 或 vLLM 即可。
信息来源
- Google Developers Blog:Introducing Support for Local AI Models in the Antigravity SDK(2026-09-23,作者 Sachin Kotwani、Taylor Mullen)— https://developers.googleblog.com/en/introducing-support-for-local-ai-models-in-the-antigravity-sdk/
- Google AI Edge:LiteRT(本地推理运行时与 Gemma 4 26B A4B 的 LiteRT 版本)
- Google Antigravity SDK:Agent 配置与策略(LiteRTAgentConfig、LocalOpenAIAgentConfig)
HiFox :将 Agent 变成真正的队友
另外,我们也在思考,AI 如何从个人提效走进团队协作。
HiFox 是一个让人和 AI Agent 在同一个工作现场协作的平台:你可以像给同事分派任务一样指派 Agent,在任务看板中跟踪进度、查看结果,让 Agent 成为团队里的队友。
👉 立即体验 Hifox:https://hifox.com
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。